
掌握了 Aider 基础命令、Architect 双模型与自动 Git 提交之后,想把效率再往上提一档,核心在于打通无人值守的“改代码 -> 跑静态检查 -> 跑单元测试 -> 报错自动喂回模型重修”闭环,同时搞清楚它是怎么在不烧穿 Token 预算的前提下看懂上百个文件调用关系的。
把仓库根目录的 .aider.conf.yml 配好,团队每个人进目录只需敲两个词 aider 就能直接享受全套自动化防线。
本站开发者订阅直达入口:高频跑多文件重构与工具链调用时,搭配固定月费的主力订阅往往比纯烧按量 API 更省钱。国内无境外信用卡可通过支付宝、微信支付或 AlipayHK 在本站免密自助开通 Claude Code 订阅(Pro / Max)、ChatGPT Plus 或浏览 AI 会员充值总览。
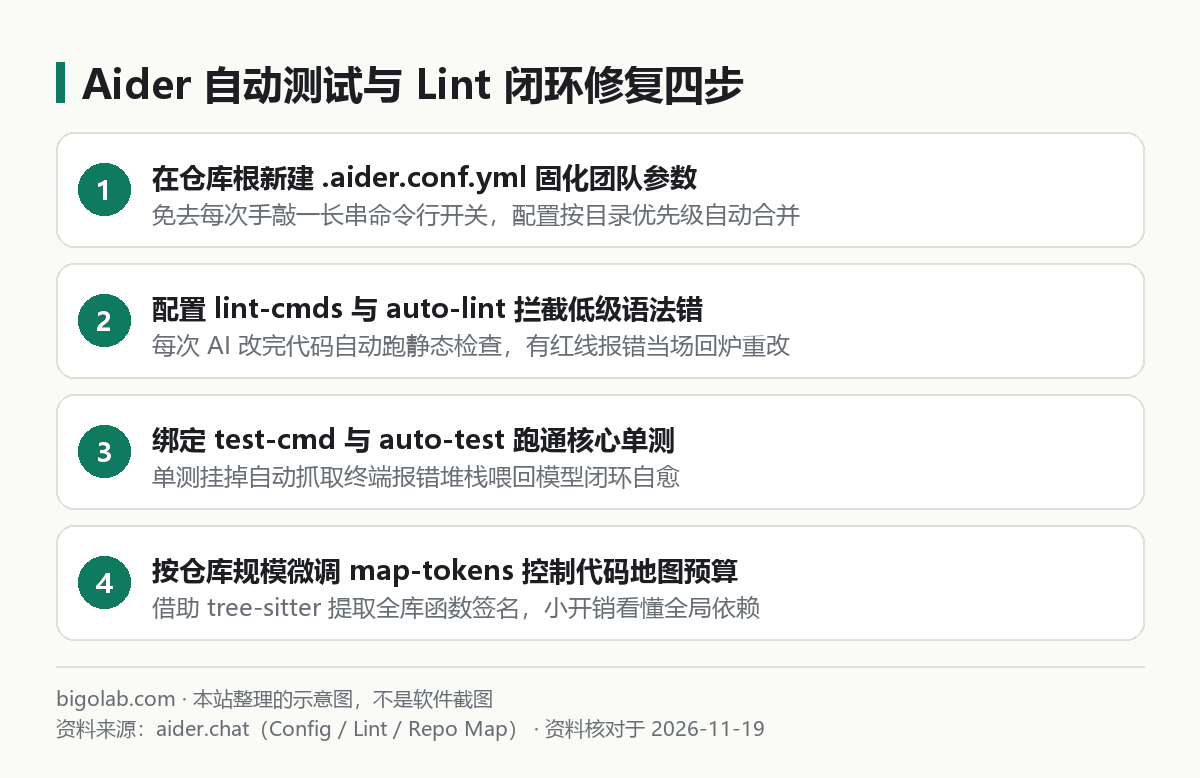
一、用 .aider.conf.yml 固化团队参数与只读规范
Aider 启动时会按“用户主目录 ~/.aider.conf.yml -> Git 仓库根目录 .aider.conf.yml -> 当前工作子目录”的优先级依次加载并合并 YAML 配置。
强烈建议在项目根目录新建一份不含任何明文密钥的 .aider.conf.yml 提交进 Git(个人 API Key 放进被忽略的 .env 或系统环境变量即可):
yaml
# 1. 默认启用主脑 + 副手双模型协作与提示词缓存
model: anthropic/claude-sonnet-4-5
architect: true
cache-prompts: true
auto-commits: true

# 2. 启动自动以只读模式加载项目规范(绝不会被 AI 误改)
read:
  - CONVENTIONS.md
  - docs/api-error-codes.md

# 3. 每次 AI 改完文件自动触发静态检查与快速单测
auto-lint: true
lint-cmds:
  python: "ruff check"
  typescript: "npx eslint --quiet"

auto-test: true
test-cmd: "pytest tests/unit -q --maxfail=3"

# 4. 代码库符号地图(Repo Map)默认预算控制
map-tokens: 2048
这里有两个非常省心的细节:
cache-prompts: true:配合read自动挂载的只读项目规范文档,开启提示词缓存后,后续多轮对话重复发送的固定规范文本与代码地图都能命中官方缓存折扣,大幅压低长会话开销。- 与钩子机制殊途同归:这种写盘即校验的思路(正如我们在 Claude Code 里配置 PostToolUse 自动跑 Prettier / Ruff 钩子异曲同工,专门治大模型“顺手漏引包、拼错类型名”的小毛病)。
二、lint-cmds 与 test-cmd:让报错堆栈自动回炉自愈
如果不配自动测试,你每次等 AI 改完代码,都要切到另一个终端手动敲 pytest,看到红字报错再复制一大段 Traceback 粘回聊天框说“修一下”。开启 auto-lint 与 auto-test 后,整套动作会变成丝滑的流水线:
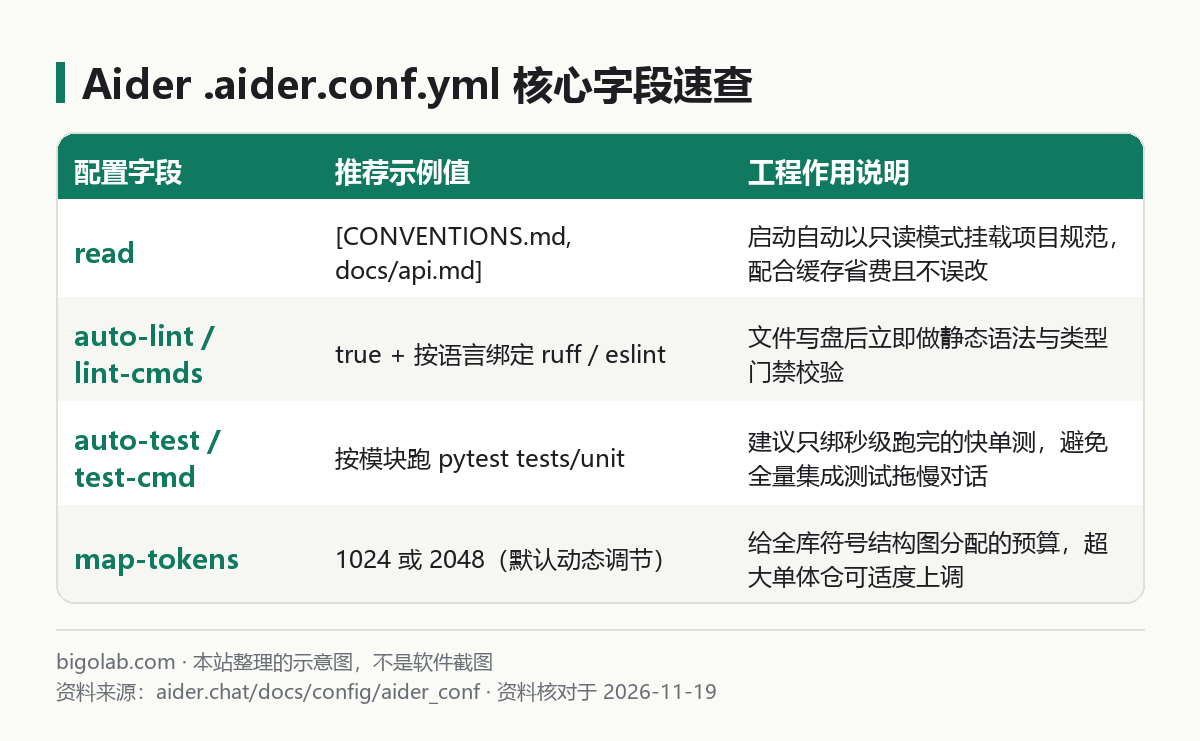
- 第一道关卡(Lint 静态门禁):Aider 内置了基于语法树的快速语法扫描;当你进一步在
lint-cmds里按语言绑好ruff、mypy或eslint后,一旦修改后的文件触发了未定义变量或类型不匹配告警,Aider 会当场截取报错行喂回给大模型要求立刻订正。 - 第二道关卡(
test-cmd单测门禁):静态检查过关后,系统紧接着自动在后台执行test-cmd指定的测试命令。测试全部绿灯则安心结束本轮对话;只要返回非零退出码(Exit Code != 0),终端故障堆栈会自动打包发给模型触发下一轮修复提交。
防拖慢对话的实战铁律:千万不要把耗时五分钟、需要连远程 Docker 数据库的全量端到端(E2E)集成测试直接绑进auto-test: true,否则 AI 每改两行代码你都要干等五分钟。日常开发建议只绑两三秒内就能跑完的纯内存单元测试子集(或者平时关掉auto-test,等一个模块改完后手动在聊天框敲/test触发一次检验)。
重度编码配额与双引擎互补建议:在开源插件或终端智能体里处理大型单体仓库时,不少工程师会同时备好一套包月封顶的官方订阅兜底复杂架构攻坚。可按需前往查看 Claude Max 5x / 20x 充值说明、Claude Pro iOS 自助卡密 或 ChatGPT Pro 充值页。
三、看懂 Repo Map(代码地图):为什么没 /add 的文件它也知道怎么调
很多刚上手的同学会好奇:“我明明只用 /add 喂了 order_service.py 一个文件,为什么 Aider 却能精准写出另一个目录里 PaymentClient.charge(amount, currency) 的参数名,完全没有瞎编?”
幕后功臣就是 Aider 基于 Tree-sitter 语法解析器加图排序算法构建的 Repo Map(全库结构地图):
- 它不会傻乎乎地把全仓库几百个文件的完整函数体硬塞进上下文(那样一轮就会烧掉几十万 Token);也不像重型 IDE 那样需要在后台建庞大的向量索引库(避免了代码库索引卡住或漏文件的烦恼)。
- 相反,它只在本地秒级提取所有源码文件里的类名、核心函数签名、导出接口与跨文件引用关系,算出与你当前
/add文件关联最紧密的骨架摘要,浓缩进短短1024或2048个 Token(由map-tokens控制)里发给模型。 - 模型看到这张“全库通讯录”后,如果发现某处底层实现细节必须看源码才能改准,会主动在对话里礼貌地请求你允许把对应文件加入上下文。在聊天框随时敲
/map命令,你就能亲眼看到当前这一轮发给大模型的精简代码地图长什么样。
如果你在重度工程团队里既用 Aider 跑精准模块单测闭环,又需要固定额度的官方包月订阅工具处理日常全库探索任务,可以前往了解贝果研究社 Claude Code 订阅与配置方案或查看全站 AI 开发者订阅自助导航。
常见问题
我的单体仓库有几千个历史遗留脚本,Repo Map 会把构建产物或老废代码也扫进去吗?
Repo Map 默认只扫描当前受 Git 版本追踪(Tracked)的源码文件,已经写进 .gitignore 的 dist/、node_modules/ 绝不会被扫入。如果仓库里还有受 Git 追踪但不想让 AI 看见的废弃老目录或庞大静态数据文件,可以在根目录新建一份 .aiderignore(语法与 .gitignore 完全一致)把它们屏蔽掉,让宝贵的 map-tokens 预算全留给核心业务目录。
如果跑 auto-test 时遇到死胡同,AI 连续改了三次单测还是挂,会无限烧钱死循环吗?
不会无限死循环,Aider 对连续自动修复轮次设有内置安全上限;但一旦看到模型对同一个报错连续两次给出相似的无效修改,说明它缺少关键上下文或判断错了根因。此时直接按 Ctrl+C 中断自动重试,敲 /undo 退回干净状态,再用 /add 把相关的底层依赖文件补进来重新指明方向最省钱。
国内没有海外信用卡,怎么开通 Claude Code 或 ChatGPT 编程订阅?
可直接在 本站充值中心 使用支付宝、微信支付或 AlipayHK 下单获取自助卡密,支持免上号兑换 Claude Pro、Claude Max 与 ChatGPT Plus / Pro,可开具增值税发票;实时价格、兑换前提与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 在项目根目录配置
.aider.conf.yml,配合read只读规范与cache-prompts: true,既统一团队参数又能吃满官方提示词缓存折扣。 - 绑定按语言触发的
lint-cmds与秒级跑完的轻量test-cmd,把低级语法错与单测回归拦截在落盘瞬间自动自愈。 - 善用
/map查看 Tree-sitter 代码地图并通过.aiderignore剔除陈旧目录,花极小的 Token 预算让模型精准掌握全局调用链。
0 条评论
还没有评论,来抢沙发~