
结论先说
- 传大体积音视频或长 PDF 必走
Files API(client.files.upload):单次内联请求塞不下大媒体文件;通过 Files API 上传的文件会在谷歌服务端免费暂存最长 48 小时,拿到文件句柄即可反复引用。 - 视频上传完不能马上提问,必须先轮询等待
PROCESSING结束:长视频需要几秒到几十秒提取帧与音轨,等state.name变为就绪状态再往下走才不会报错。 - 只问一两次别开缓存;围绕同一大文件连问五次以上必开
Context Caching:把几十万 Token 的视频和系统指令锁进client.caches.create,后续追问只传几十字问题并附带cached_content=cache.name,首字延迟和输入 Token 单价双双大降。 - 用完随手删缓存或设短
ttl:显式缓存默认存活 1 小时(3600s) 并按存活时长收存储费,批处理跑完立即调client.caches.delete释放最划算。 - 谷歌账号与多工具订阅直达入口:体验 Jules 异步提 PR、Stitch 生 UI 与 AI Studio 需登录合规个人谷歌账号,缺号可前往本站 谷歌账号购买页 选购 2FA 谷歌邮箱成品号;跨平台开发与设计订阅对比见 AI 会员充值中心。
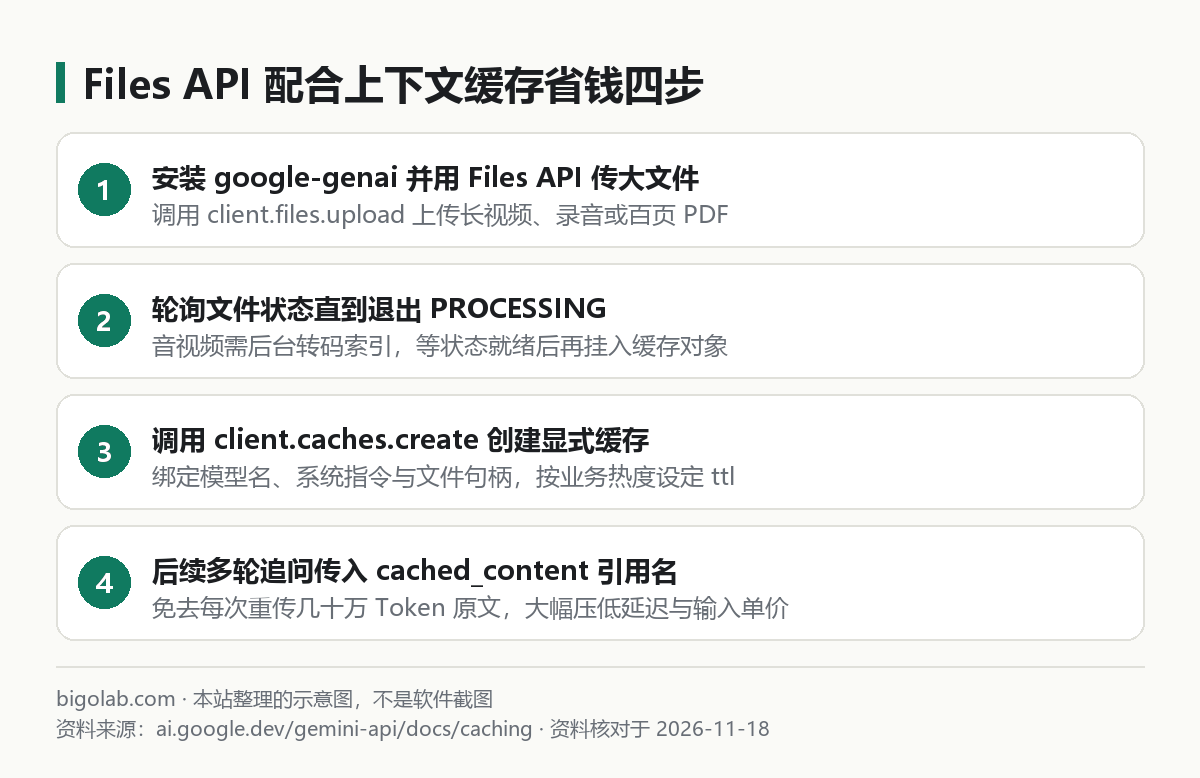
图:本站根据 Gemini API 官方缓存文档 整理的四步流程示意图
本文根据 Google Gemini API 官方文档(ai.google.dev/gemini-api/docs/caching、docs/files)整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Google 官方网站。
适用于谁
- 要用代码解析几十分钟的课程录像、播客录音或整本英文技术手册,并围绕这份材料连续追问十几个问题的开发者;
- 刚上传完视频立刻调生成接口却报错失败,不知道视频在后台有
PROCESSING转码状态的工程师; - 想搞懂什么时候该开显式缓存(Context Caching)、怎么设
ttl才不会被闲置存储费反撸的人。
一、完整 Python 实战代码(上传轮询 → 建缓存 → 多轮追问 → 释放)
请认准官方现行维护的新版 google-genai SDK(安装命令 pip install google-genai,基础环境准备见 Gemini API Python 快速入门 与 Gemini API Key 获取教程):
python
import pathlib
import time
from google import genai
from google.genai import types

# 初始化客户端(默认自动读取环境变量 GEMINI_API_KEY)
client = genai.Client(http_options={"api_version": "v1beta"})

# 1. 通过 Files API 上传长视频或大体积 PDF
video_path = pathlib.Path("tech_keynote_60min.mp4")
uploaded_file = client.files.upload(file=video_path)

# 2. 轮询等待音视频后台转码完成(关键防报错步骤)
while uploaded_file.state.name == "PROCESSING":
    time.sleep(3)
    uploaded_file = client.files.get(name=uploaded_file.name)

if uploaded_file.state.name != "ACTIVE":
    raise RuntimeError(f"文件处理未就绪,当前状态: {uploaded_file.state.name}")

# 3. 创建显式上下文缓存(存活期设为 10 分钟 = 600s)
model_id = "models/gemini-2.5-flash"
cache = client.caches.create(
    model=model_id,
    config=types.CreateCachedContentConfig(
        display_name="keynote_video_cache",
        system_instruction="你是严谨的会议纪要分析助手,给出结论时请一并标注视频中的时间戳(MM:SS)。",
        contents=[uploaded_file],
        ttl="600s",
    ),
)

# 4. 多轮追问直接复用 cache.name,无需重传整部视频
for question in [
    "按章节列出整场演讲的核心发布要点与对应时间戳。",
    "演讲者在演示数据库架构阶段提到了哪些性能瓶颈数据?",
]:
    resp = client.models.generate_content(
        model=model_id,
        contents=question,
        config=types.GenerateContentConfig(cached_content=cache.name),
    )
    print(resp.text)

# 5. 任务全部跑完后主动删除缓存,立即停止计算存储时长费
client.caches.delete(name=cache.name)
如果你需要准备用于登录 Google AI Studio 开通 API 项目的个人谷歌账号,或对比多厂商开发会员方案,可分别查看本站 谷歌账号购买说明 与 AI 会员充值总览页。
二、什么时候开显式缓存最省钱(成本账本对比)
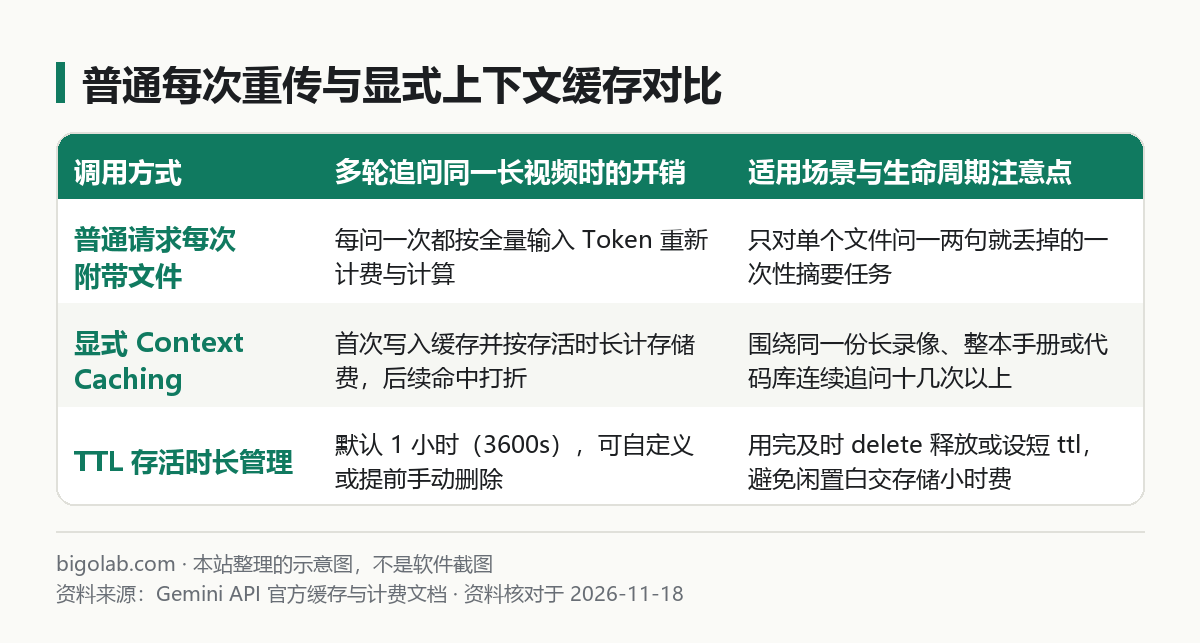
图:本站根据 Gemini API 官方定价与缓存说明 整理的对比示意图
为什么不是所有请求都无脑套一层 caches.create?算清下面三条规则你就不会花冤枉钱:
- 有最低 Token 起步门槛:官方文档规定,待缓存的内容总长度必须达到对应模型的最低 Token 下限(通常几千到几万 Token 不等,短文本两三百字调
caches.create会直接报参数不满足门槛错误)。 - 存储时长费 vs 命中折扣费的平衡点:显式缓存由两部分计费——「缓存命中时的折扣输入单价」加上「按每小时每百万 Token 计算的驻留存储费」(最新费率口径见 Gemini API 官方价格详解)。如果一段长视频你只打算让它总结一次就再也不问了,直接把
uploaded_file传给generate_content就行,建缓存反而多付一小时存储费;反之如果做成交互式问答机器人让用户连续问十几个细节,开缓存能立省大半账单。 - 动态续期与按需清理:如果用户还在持续追问、眼看
ttl快到期了,可以通过client.caches.update延长过期时间;一旦会话关闭,立刻调delete销毁。若在免费层测试时遇到缓存配额受限报错,可对照 Gemini API 免费层速率与计费升级说明 检查项目档位。你也可以对比另一家主流接口的缓存设计思路,见 Claude API 提示词缓存教程。
常见问题
问:Files API 上传的文件过了 48 小时会自动消失吗?
答:会的。官方明确说明 Files API 是为模型推理设计的临时文件中转区,不是永久云盘,上传满 48 小时后服务端会自动清理,长期业务原件请保存在你自己的对象存储桶里。
问:调用 generate_content 引用缓存时,还能在 GenerateContentConfig 里再改一次 system_instruction 吗?
答:不能重复覆盖。系统指令(system_instruction)和固定工具声明应当在创建缓存(CreateCachedContentConfig)那一刻一并封进去,后续每次生成请求只传新增的用户提问文本。
问:为什么创建缓存时提示当前免费层不支持或报 429?
答:部分模型的显式上下文缓存能力或高并发缓存总容量仅对已开启付费结算(Pay-as-you-go)的项目开放,先去 AI Studio Dashboard 检查项目是否已绑定有效计费层级。
问:注册谷歌账号卡在手机号验证,或者国内没有外币卡怎么配齐 AI 开发工具?
答:本站提供支持支付宝、微信支付与 AlipayHK 自动发卡的 谷歌邮箱成品号(登录加固步骤见 谷歌账号说明页),同时支持自助获取兑换码开通 ChatGPT Plus 与 Claude Code 订阅,支持开具增值税发票。
0 条评论
还没有评论,来抢沙发~