
结论先说
llms.txt是给 AI 智能体看的「站点精简目录」:按llmstxt.org(v2 规范)定义,放在网站根目录/llms.txt或子路径(如/docs/llms.txt),用结构化 Markdown 给出项目简介与干净文档页链接,省去解析复杂 HTML 导航和脚本的开销。llms-full.txt是社区与文档平台通行的「整站正文合集」:llms.txt只放轻量索引供智能体按需跟进链接;llms-full.txt则把整站核心文档拼成单个大文本文件,适合本地建索引或离线检索,但直接整份塞进对话容易撑满上下文窗口。- v2 规范只有一级标题
# 项目名是必填项,但各段落顺序固定:依次为# 标题、>一句话摘要、无标题补充说明、## 分类名下的名称: 说明列表,以及约定的## Optional次要链接分组。 - 配套页面建议提供同名
.md纯文本版:规范建议在原网页 URL 后加.md(如page.html.md或目录页加index.md),并用<link rel="alternate" type="text/markdown">或 HTTPLink:头声明关联。 - 它不替代
robots.txt和sitemap.xml:robots.txt管爬虫准入边界,sitemap.xml罗列全量人类页面给搜索引擎,而llms.txt专供推理阶段的智能体按需查资料。 - 主力模型订阅与账号配套入口:跑通 MCP 工具链与多文件智能体编码依赖稳定的底层大模型配额,国内免境外卡自助开通可见本站 Claude Code 订阅页、ChatGPT Plus 充值页 与 AI 会员充值总览。
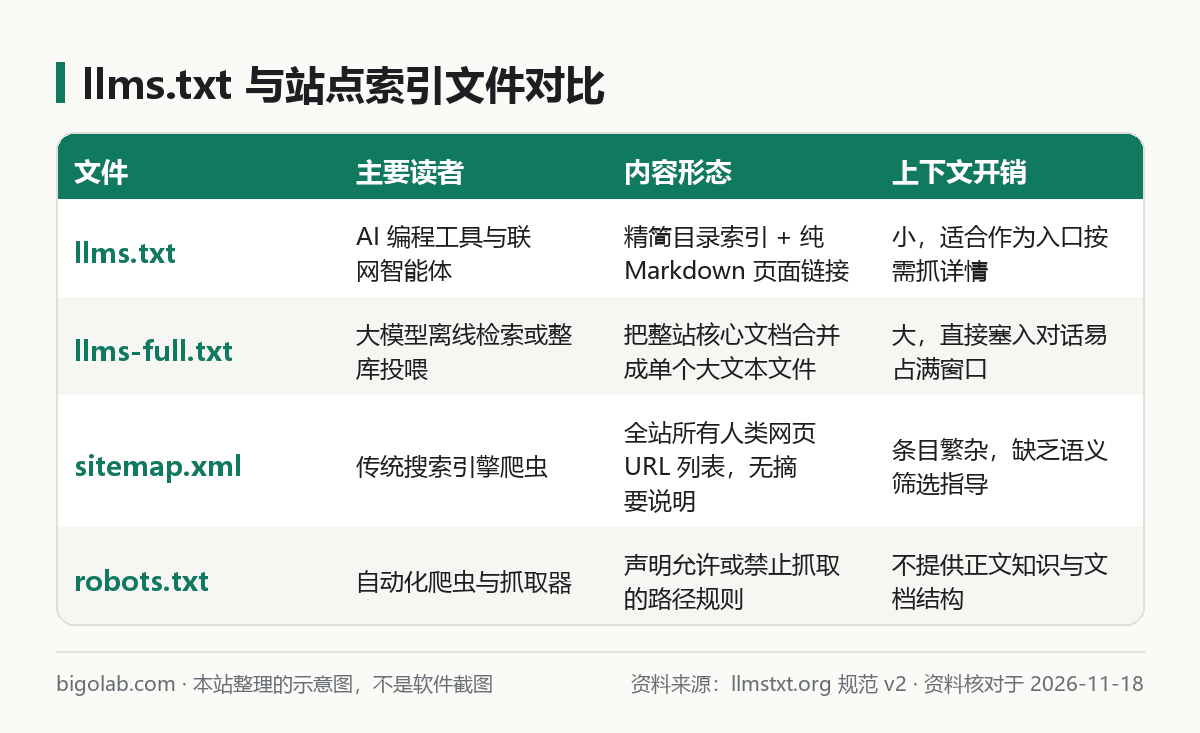
图:本站根据 llmstxt.org:The /llms.txt file, v2 整理的示意图
本文根据开放规范《The /llms.txt file, v2》(llmstxt.org)及主流大模型官方文档站实践整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 llmstxt.org 官方网站。
适用于谁
- 在开源库或大模型文档站看到
/llms.txt和/llms-full.txt,想知道两者有什么区别、该喂哪个给 AI 的开发者; - 维护内部或公开技术文档,想按标准格式写一份让编程智能体少出幻觉的文档负责人;
- 想弄清它和
robots.txt、sitemap.xml以及项目内AGENTS.md各管什么的读者。
一、为什么需要 llms.txt,它和 llms-full.txt 差在哪
人类逛文档站需要侧边栏、样式表和交互脚本,但编程智能体抓 HTML 时,这些标签只会浪费大量 token 并干扰提取精度。为此,OpenAI、Anthropic、Google Gemini 开发者文档以及 Chrome Lighthouse 的智能体浏览检查(Agentic browsing checks)都已引入 /llms.txt。
日常使用时,你会同时遇到两个文件名:
llms.txt(官方规范定义):体积很小,装得进一次普通对话上下文。模型先读这份总览判断该看哪一章,再去拉取对应章节的.md链接;llms-full.txt(文档平台扩展约定):例如 Mintlify 托管站点和 OpenAI Codex 文档(learn.chatgpt.com/docs/llms-full.txt)会把所有文档正文直接拼进这一个文件。小项目直接复制很省事,大型框架动辄几百万字符,更适合拆块检索而不是整篇粘贴。长文本提问排布技巧见 长文档怎么问 AI。
二、怎么给文档站写一份标准的 llms.txt
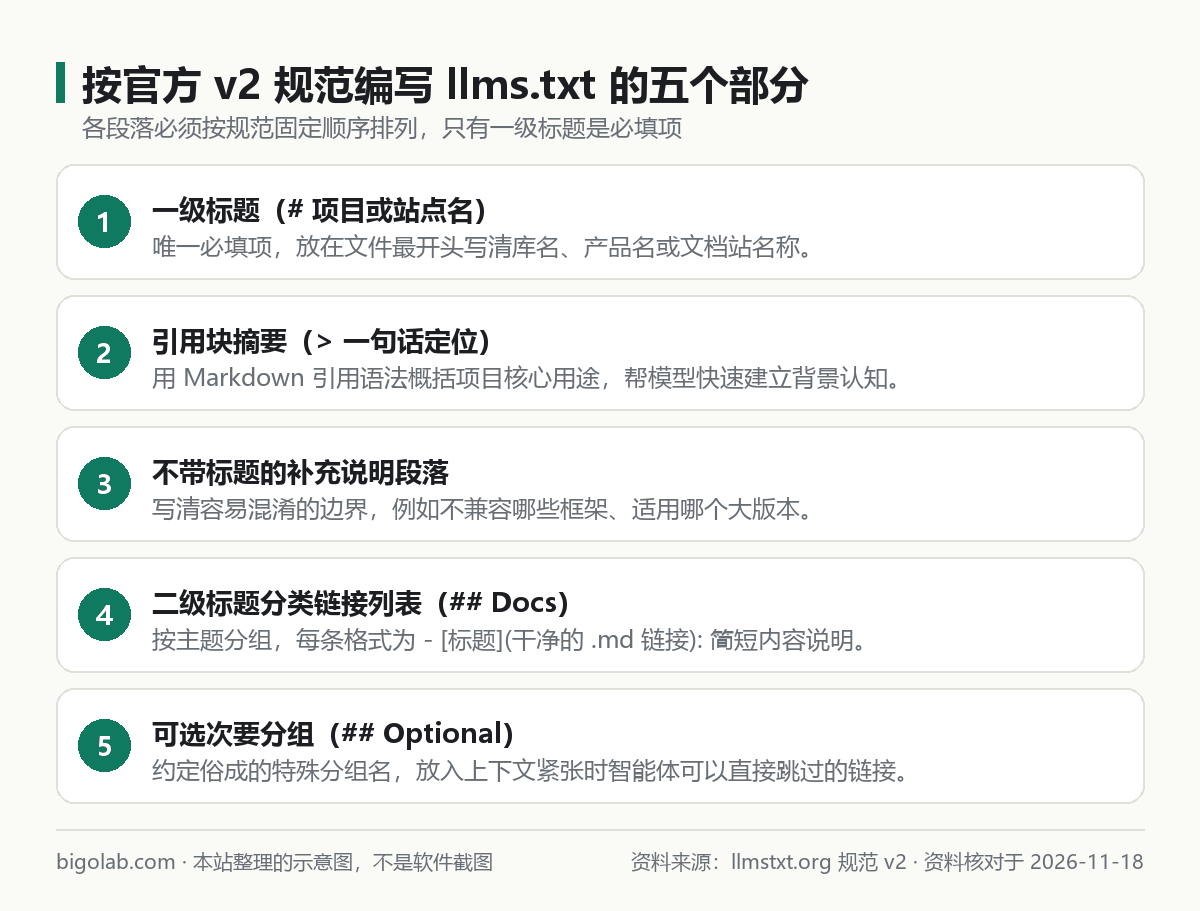
图:本站根据 llmstxt.org:The /llms.txt file, v2 整理的示意图
v2 规范要求各部分严格按顺序书写,这样既方便大模型阅读,也方便普通程序用正则或解析器固定提取。可直接套用下面这份模板:
markdown
# Acme SDK

> Acme SDK 是一个基于 TypeScript 的服务端支付与对账客户端库,要求 Node.js 20 及以上版本。

重要边界说明:
- v3 版本接口与旧版 v2 不兼容,所有异步方法均返回 Result 对象而非直接抛出异常;
- 仅用于服务端环境,不支持在浏览器前端直接打包调用以防泄露密钥。

## 快速开始与核心接口

- [安装与初始化](https://docs.example.com/quickstart.html.md): 环境变量配置、客户端实例化与最小支付请求示例
- [Webhook 验签指南](https://docs.example.com/webhooks.html.md): 请求头签名核验步骤与幂等处理写法

## Optional

- [v2 升级 v3 迁移对照表](https://docs.example.com/migration-v3.html.md): 旧项目升级时的破坏性变更清单
编写和发布时的四个关键细节:
- 子路径就近覆盖原则:放在
/docs/llms.txt就代表只覆盖/docs/下的内容;若同一页面同时命中根目录和子目录两份文件,智能体优先采用路径更具体的那一份; - 中间补充段不能出现标题:在
>引用块之后、第一个##二级标题之前,只能写普通段落或无序列表(常用来强调「不兼容某某语法」),不要穿插三级标题; ## Optional的特殊含义:这是规范约定的保留分组名,告诉智能体「如果上下文预算紧张,这一节里的链接可以直接跳过」;- 提供
.md镜像页与Link响应头:把正文页同步生成一份原路径.md或index.html.md,并在 CDN 或服务端加上Link: </docs/quickstart.html.md>; rel="alternate"; type="text/markdown", </docs/llms.txt>; rel="describedby",无需改动原 HTML 就能让客户端自动发现。
如果你的文档站用的是现成框架,不必纯手写:Mintlify、GitBook、WordPress(Yoast SEO / AIOSEO)已支持自动输出,静态站可直接装 vitepress-plugin-llms 或 docusaurus-plugin-llms。写完初稿后,建议结合 用 ChatGPT 写 README 和技术文档 的核验思路,只把 llms.txt 发给一个新会话的智能体提问,测试它能否准确挑出目标链接。
三、在 AI 编程工具里怎么读取和利用 llms.txt
作为调用第三方新库的开发者,拿到对方官网的 llms.txt 后有三种高频用法:
- 在 Cursor 里挂进文档索引:把目标库的
/llms.txt或/llms-full.txt地址添加到@Docs自定义文档源,让补全和 Agent 引用最新接口; - 在 Claude Code 或 Codex 里按需拉取:在提示词里直接给出库文档的
/llms.txt链接,让智能体先读目录再抓取对应章节的.md页面,或者搭配 Claude Code 配 Context7 MCP 查最新文档 自动注入版本化文档; - 与仓库内
AGENTS.md分工:llms.txt放在外部文档站给访问者读,而自己代码仓库里的构建命令和目录规范则写在AGENTS.md或CLAUDE.md里(见 AGENTS.md 怎么写)。
日常用 Claude Code、Codex 或 ChatGPT 处理新框架升级和长文档检索时,若免费额度不够用,可在本站查看 Claude Code 订阅充值 或 ChatGPT Plus 充值。
常见问题
问:放了 llms.txt 会禁止未列出的页面被爬虫抓取吗?
答:不会。llms.txt 只做主动推荐和上下文导航,没有任何访问拦截作用;控制爬虫准入依然靠 robots.txt。
问:为什么不按 RFC 8615 放在 /.well-known/ 目录下?
答:v2 规范专门解释过:/.well-known/ 只能由域名根目录控制,像托管在子路径下的 GitHub Pages 项目站根本没权限写根目录;允许在任意子路径放 llms.txt 才能像 index.html 一样谁发布谁维护。
问:列表项冒号后面的说明文字是必填的吗?
答:不是必填,单写 - 标题 也符合语法,但官方强烈建议加上英文冒号和简短说明,否则智能体光看标题很难判断是否值得花 token 点进去读。
问:配置好开发环境后,国内没有外币卡怎么开通 Claude 或 ChatGPT 编程订阅?
答:可在 本站充值中心 自助选购卡密开通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程无需交出账号密码,支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页为准。
相关教程
- Claude Code 配 Context7 MCP 查最新文档:两种安装方式、use context7 怎么写、指定库和版本
- AGENTS.md 怎么写:规范、模板,以及 Cursor、Copilot、Trae、Kiro、Cline 各自怎么读
- 用 ChatGPT 写 README 和技术文档:贴代码和目录生成初稿,安装步骤必须亲自跑一遍
- 长文档怎么问 AI:资料放前面、问题放最后、先引用再回答(官方长文本提示词技巧)
参考资料
- The /llms.txt file, v2(官方规范站)— https://llmstxt.org/
- OpenAI Codex 官方文档全量索引 — https://learn.chatgpt.com/docs/llms-full.txt
- Google Gemini API 官方文档索引 — https://ai.google.dev/gemini-api/docs/llms.txt
0 条评论
还没有评论,来抢沙发~