
结论先说
- 分清四个概念只要问一句话:「到底是谁拍板触发它?」——Tools 由大模型自主调用,Resources 由宿主应用或用户按需挂载,Prompts 由用户显式点选,Sampling 则由服务器反向向客户端借模型算力。
- 前三个是服务端原语(客户端去调服务器),第四个 Sampling 是客户端原语(服务器反过来调客户端),方向正好相反。
- 论跨客户端兼容性,Tools 是绝对主力:几乎所有支持 MCP 的软件都完整支持 Tools,而 Resources、Prompts 和 Sampling 在部分编辑器里支持不全或入口较深。
- 实战开发经验是「Tools 保底,其余增强」:核心读写逻辑优先做成 Tools,再把高频背景文档补成 Resources、把固定提问流程补成 Prompts。
- 主力模型订阅与账号配套入口:跑通 MCP 工具链与多文件智能体编码依赖稳定的底层大模型配额,国内免境外卡自助开通可见本站 Claude Code 订阅页、ChatGPT Plus 充值页 与 AI 会员充值总览。
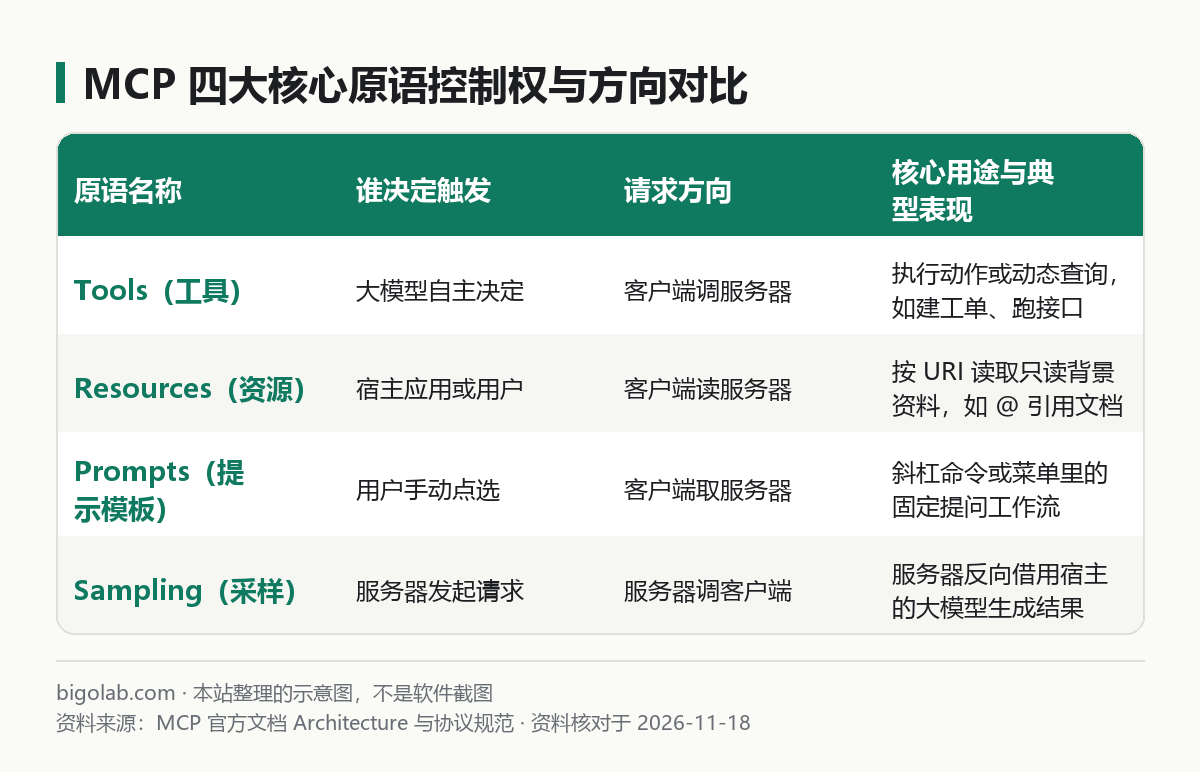
图:本站根据 MCP 官方文档:Architecture overview 整理的对比示意图
本文根据 MCP 官方文档《Architecture overview》及协议规范《Tools》《Resources》《Prompts》《Sampling》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 或 MCP 官方网站。
适用于谁
- 看文档时被各种概念绕晕,搜「mcp resources prompts tools 区别」想快速理清关系的开发者;
- 准备动手写自己的 MCP 服务器,拿不准「查数据库表结构」该做成 Resource 还是 Tool 的人;
- 听说过 Sampling(采样),不确定为什么服务器还能反过来调用客户端大模型的人。
如果还不了解协议的整体角色划分,可以先读 MCP 是什么:Model Context Protocol 入门。
一、服务端暴露的三大原语:按控制权一眼分清
MCP 官方规范在每个原语章节的第一段都明确标出了它的控制模型(Control Model),这是理解设计初衷最准确的钥匙:
1. Tools(工具):模型主导(Model-controlled)
- 协议方法:
tools/list(发现工具列表)、tools/call(执行指定工具)。 - 工作方式:客户端在对话开始时把工具的名称、描述和参数 JSON Schema 交给大模型。聊到一半模型觉得需要查订单、改配置或发通知时,自己决定发起调用并填好参数。
- 类比后端接口:近似于带动作或动态参数的
POST请求,允许产生外部副作用(因此客户端通常会弹出人工确认框)。
2. Resources(资源):应用与用户主导(Application-driven)
- 协议方法:
resources/list、resources/read、resources/subscribe(订阅变更)。 - 工作方式:服务器用类似网址的自定义 URI(例如
file:///logs/app.log或postgres://db/users/schema)暴露只读文本或二进制数据。注意模型自己并不能主动去拉取 Resource,必须由用户在输入框里用@引用、在附件菜单里勾选,或者由宿主程序自动拼进上下文。 - 类比后端接口:近似于纯粹只读、无副作用的静态或模板化
GET数据源。
3. Prompts(提示模板):用户主导(User-controlled)
- 协议方法:
prompts/list、prompts/get。 - 工作方式:服务器预先写好带变量槽位的标准提问模板(例如「按团队规范审查指定提交」)。用户在客户端输入框敲斜杠命令(如 Claude Code 里的
/mcp__服务器名__模板名)或点菜单选中它、填入参数后,服务器把组装好的消息列表返回给客户端开启对话。 - 和本地规则的区别:如果你想对比它和本地技能文件的边界,见 Skill 和 MCP 的区别是什么。
二、反向流动的客户端原语:Sampling 是干什么的
前三个原语都是「客户端向服务器要东西」,而 Sampling(采样) 属于客户端向服务器开放的能力,协议方法是 sampling/createMessage。
设想你在写一个复杂的代码静态分析 MCP 服务器,工具跑完规则扫描后,需要一段自然语言归纳修复建议:
- 没有 Sampling 时:你的 MCP 服务器内部必须自己申请并配置一份 OpenAI 或 Claude 的 API Key,自己付账单去调大模型接口,别人装你的开源服务器也得跟着配一遍密钥。
- 有了 Sampling 后:MCP 服务器直接顺着现有的连接,给宿主客户端发一条
sampling/createMessage请求,说「请用你当前已登录的大模型帮我总结这段扫描结果」。按官方规范建议,客户端会在界面提示用户审核这条采样请求和返回结果,既省掉了服务端配密钥的麻烦,又让安全控制权留在用户手里。
顺带一提,客户端原语里还有两个常和 Sampling 一起出现的配角:Roots(客户端告诉服务器允许访问哪些本地目录边界)和 Elicitation(服务器执行到中途发现缺关键信息,反向弹窗请用户补填表单)。
三、自己开发 MCP Server 时怎么选型不返工
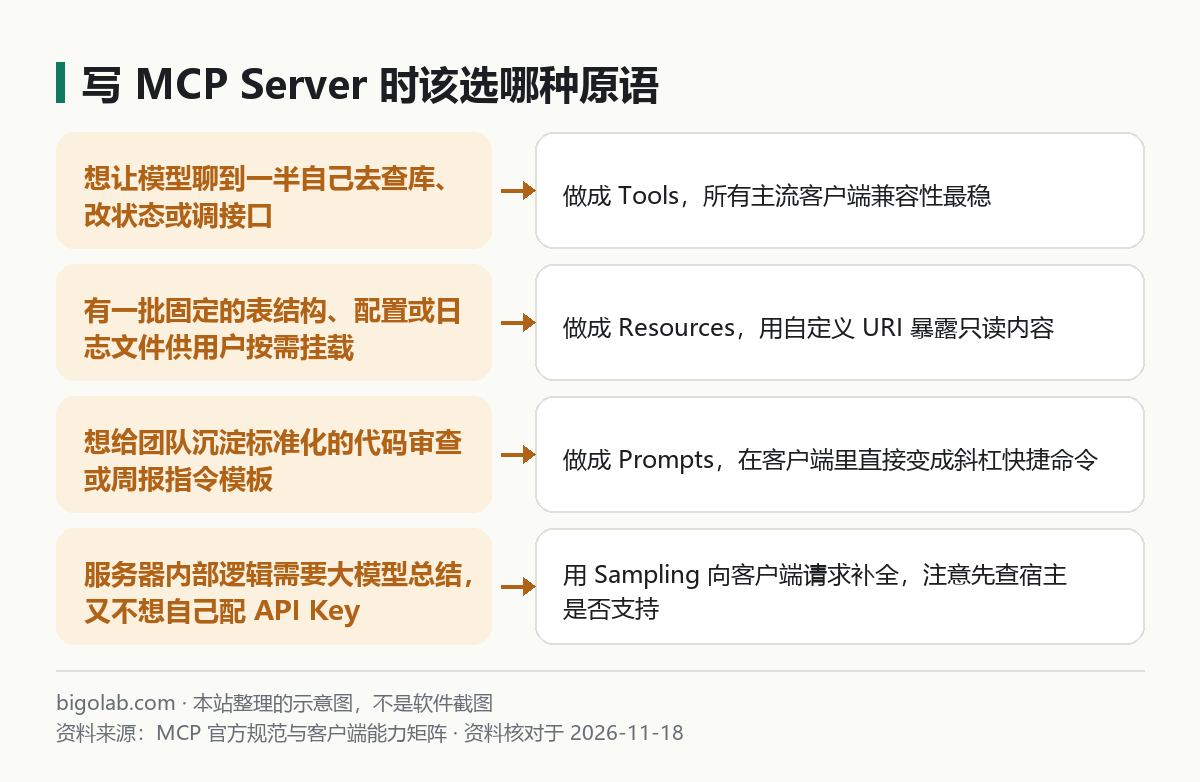
图:本站根据 MCP 官方协议规范 整理的开发选型示意图
如果只看理论很容易把只读查询全写成 Resources,结果接进某些编辑器后发现模型根本读不到。结合目前主流客户端的实际支持度,按下面三条原则选型最稳妥:
- 需要模型自动按需查阅的数据,依然要提供对应的 Tool:比如「按表名查字段结构」,哪怕它是纯只读操作,也建议提供一个
get_table_schema的 Tool(标上readOnlyHint: true),同时再额外挂一份 Resource 供习惯手动@引用的用户直接塞上下文。Python 代码里的具体装饰器写法见 MCP Server 开发入门(Python)。 - 用 Claude Code 体验完整的三原语联动:在终端工具里,Claude Code 对 Tools 自动调用、
@引用 MCP Resources 以及/mcp__斜杠触发 Prompts 都做了原生适配(配置细节见 Claude Code MCP 配置教程);如果你在网页或桌面端搭配多连接器高频使用,也可以开通 Claude Pro 解锁完整连接器配额。 - 写 Sampling 前必须做降级兼容:在初始化握手阶段检查客户端
capabilities里是否声明了sampling。很多轻量客户端暂未实现采样接口,服务端代码里应当在不支持时优雅退回返回原始结构化数据,并先用 MCP Inspector 怎么用 模拟测试请求。
常见问题
问:Resources 和直接让模型调 read_file 工具有什么本质差别?
答:调 read_file 工具是模型自己猜路径、多花一轮工具调用去读;而挂 Resource 是你在发消息那一刻就明确把指定资料钉进当前提问上下文里,零猜测、少一次往返,适合你很清楚模型必须看哪份文档的场景。
问:MCP 里的 Prompts 和我平时存的提示词片段有什么不同?
答:普通提示词只是纯文本粘贴;MCP 的 Prompts 运行在服务端,接收你填入的参数后,可以在服务端动态拉取最新代码 diff 或数据库日志,现场拼装成图文并茂的多条上下文消息再发给模型。
问:开启 Sampling 后,恶意的 MCP 服务器会不会在后台偷偷刷光我的模型额度?
答:MCP 官方《Sampling》规范明确要求客户端实现「人在回路(Human-in-the-loop)」控制:发起采样前应当让用户看到提示词内容并手动批准,同时允许用户限制最大输出 Token 数。遇到来路不明的服务器,拒绝采样请求即可。
问:配置好开发环境后,国内没有外币卡怎么开通 Claude 或 ChatGPT 编程订阅?
答:可在 本站充值中心 自助选购卡密开通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程无需交出账号密码,支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页为准。
相关教程
- MCP 是什么:Model Context Protocol 入门,以及在 Claude 里怎么用
- Skill 和 MCP 的区别是什么:再加上子代理、Hook、CLAUDE.md,到底该选哪个
- MCP Server 开发入门(Python):用官方 SDK 写第一个 MCP 服务器并调试
- Claude Code MCP 配置教程:claude mcp add、配置文件位置与常用 MCP
- MCP Inspector 怎么用:安装、启动命令、调试 MCP 服务器与 v2 的变化
参考资料
- MCP 官方文档:Architecture overview — https://modelcontextprotocol.io/docs/learn/architecture
- MCP 协议规范:Tools — https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- MCP 协议规范:Resources — https://modelcontextprotocol.io/specification/2025-11-25/server/resources
- MCP 协议规范:Prompts — https://modelcontextprotocol.io/specification/2025-11-25/server/prompts
- MCP 协议规范:Sampling — https://modelcontextprotocol.io/specification/2025-11-25/client/sampling
0 条评论
还没有评论,来抢沙发~