
结论先说
- Sequential Thinking MCP 本身没有任何推理算力,它是官方
modelcontextprotocol/servers里的一个参考服务器,本质是给模型提供一个「记步草稿本」工具。 - 它的原理是靠多轮工具调用逼模型分步想:模型每想一步就调一次
sequentialthinking工具,服务器把步数和分支记在内存里返回状态,直到模型把nextThoughtNeeded设为false才输出最终答案。 - 如果你主力用支持原生思考的模型,日常没有必要再装它:Claude Sonnet / Opus、GPT Thinking、Gemini 3 等模型已在单次请求内自带深度推理,叠加该工具反而会增加多轮上下文重发开销与等待时间。
- 只有两类场景还用得上:一是调用不具备原生思考能力的本地小模型或早期接口;二是需要把修订(Revision)和分支(Branching)过程强制留在客户端工具日志里备查。
- 主力模型订阅与账号配套入口:跑通 MCP 工具链与多文件智能体编码依赖稳定的底层大模型配额,国内免境外卡自助开通可见本站 Claude Code 订阅页、ChatGPT Plus 充值页 与 AI 会员充值总览。
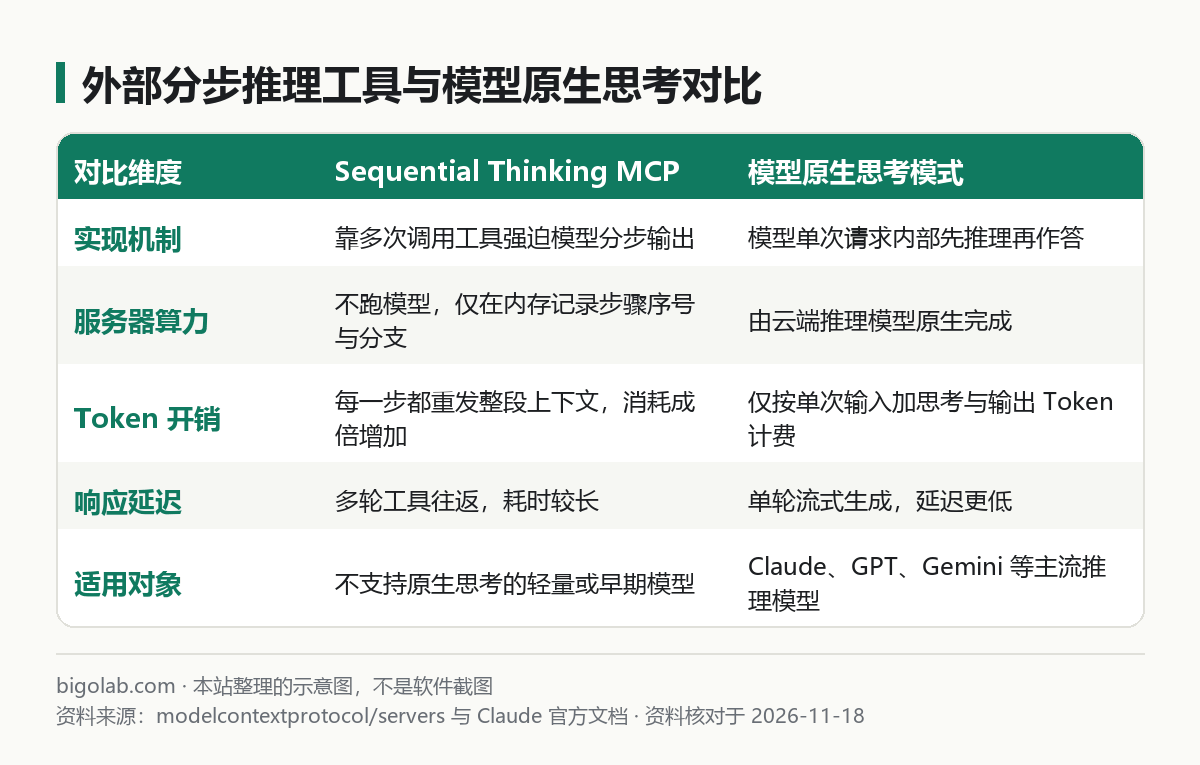
图:本站根据 Sequential Thinking MCP Server 官方说明 与 Anthropic 官方文档整理的示意图
本文根据 MCP 官方参考仓库《Sequential Thinking MCP Server》《modelcontextprotocol/servers》与 Anthropic 官方文档《Extended thinking》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 或 MCP 官方网站。
适用于谁
- 在各种「必装 MCP 清单」里看到 Sequential Thinking,搜「sequential thinking mcp」想弄清它到底干什么的人;
- 装上之后发现每次提问都要连调五六次工具、回复变慢且额度掉得很快的人;
- 分不清这类外部推理工具和 Claude 扩展思考、GPT Thinking 等模型原生思考有什么区别的开发者。
一、Sequential Thinking MCP 到底是怎么工作的
打开官方仓库 src/sequentialthinking 的说明可以看到,这个服务器只向客户端暴露一个名为 sequentialthinking 的工具。很多新手误以为装了它等于外挂了一个推理引擎,其实服务器端既不联网也不调用其他大模型,只负责接收并校验一组结构化字段:
| 参数名 | 是否必填 | 官方定义作用 |
|---|---|---|
thought | 必填 | 当前这一步的思考文本,可以是分析、验证或对前一步的修正 |
thoughtNumber | 必填 | 当前是第几步(正整数,如 1、2、3) |
totalThoughts | 必填 | 当前预估一共需要多少步(后续可随时动态调大或调小) |
nextThoughtNeeded | 必填 | 布尔值,设为 true 则继续调下一步,设为 false 则结束思考 |
isRevision / revisesThought | 可选 | 标记当前步骤是在推翻并修正前面的第几步思考 |
branchFromThought / branchId | 可选 | 从前面某一步分叉出另一条备选方案继续推演 |
它的完整运行闭环是:模型收到复杂问题后,先发起第一次工具调用填入第 1 步想法;本地进程把这个步骤存进内存列表,并把当前总步数、分支数拼成一段简短 JSON 返回给客户端;客户端再把整段历史连同返回值发回给模型,触发第 2 步工具调用。如此循环数次,模型才真正开口回答用户。
二、和模型原生思考模式有什么区别
在 MCP 刚发布时,不少主力对话模型还没有开放原生的推理块,靠工具调用来强制拆解步骤确实能减少漏想。但到了 2026 年,主流模型几乎都内置了经过强化学习训练的原生思考能力(例如 Claude 的 Extended Thinking、ChatGPT 的 Thinking 档位、Gemini 3 的 thinking_level)。两者的核心差异集中在三点:
- Token 计费与额度消耗不同:原生思考在一次 API 请求或一次对话回合内完成,输入提示词只算一次;而 Sequential Thinking MCP 每走一步就是一次新的模型请求,前面累积的对话历史、系统指令和所有工具定义都要重新作为输入发一遍。如果连走 6 步,输入侧的上下文消耗就会翻好几倍。
- 推理连续性不同:按 Anthropic 官方《Extended thinking》说明,原生思考块在模型内部连续生成,并带有加密签名保持多轮推理一致性;外部工具则是把自然思维硬切成 JSON 字符串参数,模型还要分神兼顾参数格式校验。关于提示词思维链与原生思考模式的取舍,可延伸看 思维链提示词还有用吗 与 Claude API 扩展思考参数怎么设。
- 上下文污染不同:Sequential Thinking 每一步传出的长串 JSON 参数都会留在当前会话历史里,对话聊不了几轮就容易把窗口塞满。
三、现在还有没有必要安装(选型判断)
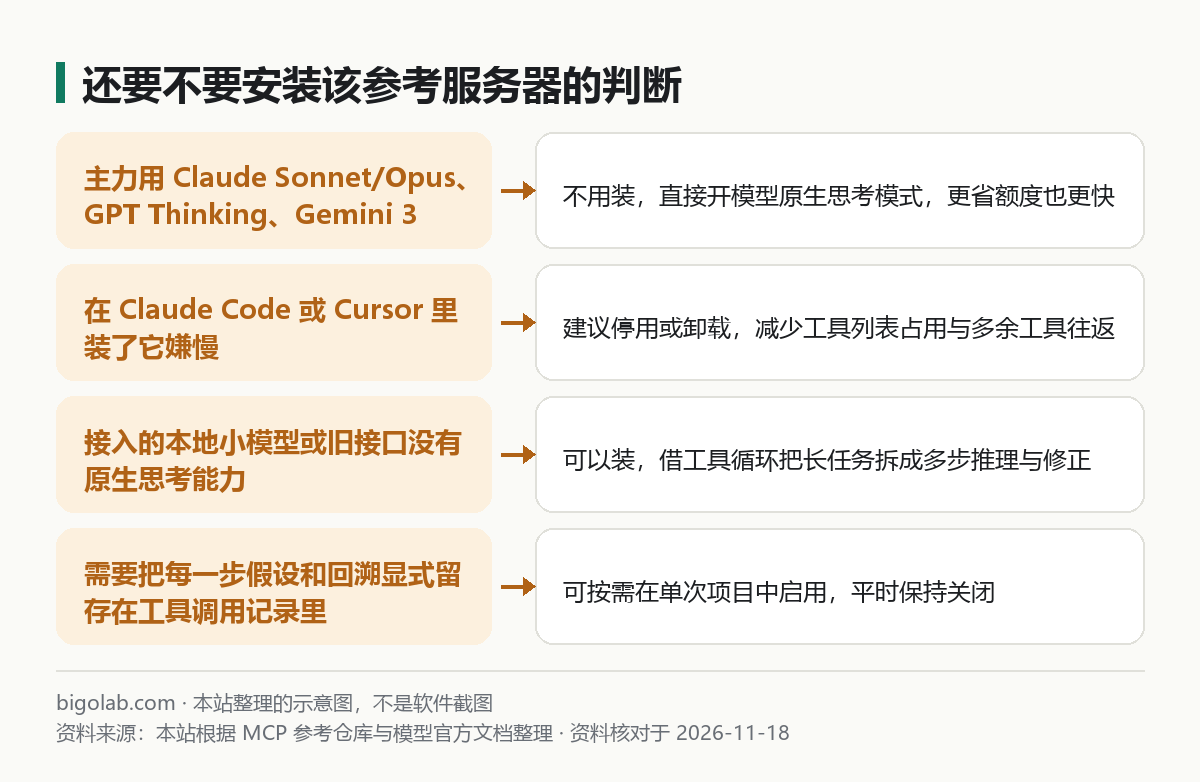
图:本站根据 modelcontextprotocol/servers 官方仓库 整理的选型示意图
本站根据上述机制给出的实用建议很明确:
- 直接不装或停用的情况:你在用 Claude Desktop、Claude Code、Cursor 或 Codex,且底层选的是自带思考模式的现代模型。若你的免费账号因为频繁跑多步工具很快触顶,与其挂着这个工具耗额度,不如把它关掉,需要重度推理与写代码时直接升级支持 Opus 与更高用量的 Claude Pro 或使用 Claude Code。
- 值得保留的情况:你在本地用客户端连接没有思考模式的轻量开源模型、旧版兼容接口,或者你在调试智能体工作流,希望把模型每次推翻重来的「修订步号」明明白白打印在终端标准错误日志里用于复盘。
四、如果确实要用,官方标准配置怎么写
包名是 @modelcontextprotocol/server-sequential-thinking,需要本机装有 Node.js(支持 npx)或 Docker。
1. Claude Desktop(claude_desktop_config.json)写法
json
{
  "mcpServers": {
    "sequential-thinking": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-sequential-thinking"
      ],
      "env": {
        "DISABLE_THOUGHT_LOGGING": "false"
      }
    }
  }
}
官方说明默认会在标准错误流打印带颜色排版的每步思考内容;如果你不希望日志文件塞满思考文本,把环境变量 DISABLE_THOUGHT_LOGGING 设为 "true" 即可关闭日志输出。配置文件路径与重启方法见 Claude Desktop MCP 配置教程。
2. Claude Code 一行命令添加与移除
在终端添加:
bash
claude mcp add sequential-thinking -- npx -y @modelcontextprotocol/server-sequential-thinking
如果你以前跟风装过、现在想删掉省上下文,直接运行移除命令即可:
bash
claude mcp remove sequential-thinking
更多作用域和排错方式见 Claude Code MCP 配置教程。
常见问题
问:卸载 Sequential Thinking MCP 后,Claude 就不会一步步推理了吗?
答:不会。只要你在界面打开扩展思考(Extended thinking)或使用默认带推理能力的模型,它依然会在回答前先做完整的内部推理,而且速度更快、更省额度。
问:为什么装了以后有时候模型根本不调用它?
答:MCP 工具由模型自主决定何时调用(具体机制见 MCP 是什么)。遇到简单问题模型会直接作答;若你在测试环境下想强制触发,需要在提问末尾明确写出「请使用 sequentialthinking 工具分步分析」。
问:Windows 上用 npx 启动报找不到命令怎么办?
答:部分客户端子进程找不到 npx.cmd,在 Windows 配置里可以把 "command" 改成 "cmd","args" 写成 ["/c", "npx", "-y", "@modelcontextprotocol/server-sequential-thinking"]。
问:配置好开发环境后,国内没有外币卡怎么开通 Claude 或 ChatGPT 编程订阅?
答:可在 本站充值中心 自助选购卡密开通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程无需交出账号密码,支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页为准。
相关教程
- Claude API 扩展思考(extended thinking)参数怎么设:adaptive、budget_tokens、effort 和 display
- 思维链提示词还有用吗:「一步一步思考」什么时候写、思考模式什么时候开
- Claude Desktop MCP 配置教程:claude_desktop_config.json 在哪、怎么写、不生效怎么查
- Claude Code MCP 配置教程:claude mcp add、配置文件位置与常用 MCP
- MCP 是什么:Model Context Protocol 入门,以及在 Claude 里怎么用
参考资料
- Sequential Thinking MCP Server 官方说明:https://github.com/modelcontextprotocol/servers/tree/main/src/sequentialthinking
- MCP 官方参考服务器仓库:https://github.com/modelcontextprotocol/servers
- Anthropic 官方文档:Extended thinking — https://platform.claude.com/docs/en/build-with-claude/extended-thinking
0 条评论
还没有评论,来抢沙发~