
结论先说
- Filesystem 和 Fetch 都来自 MCP 官方
modelcontextprotocol/servers参考仓库,前者基于 Node.js(npx启动),后者基于 Python(推荐用uvx启动)。 - Filesystem 靠启动参数限制目录范围:你在
args数组末尾写进哪几个本地绝对路径,模型就只能访问这几个目录及其子目录,越界会直接报错。 - Fetch 会把网页 HTML 转成精简 Markdown,单次默认最多返回
5000个字符(max_length),长网页靠start_index分段往后读。 - 官方把这两个服务器定位为参考实现,以你当前登录的系统用户权限运行。不要把整个用户主目录或系统盘根目录放进白名单。
- 改完配置必须彻底退出并重开 Claude Desktop,仅关闭窗口不会重新加载本地 MCP 进程。
- 主力模型订阅与账号配套入口:跑通 MCP 工具链与多文件智能体编码依赖稳定的底层大模型配额,国内免境外卡自助开通可见本站 Claude Code 订阅页、ChatGPT Plus 充值页 与 AI 会员充值总览。
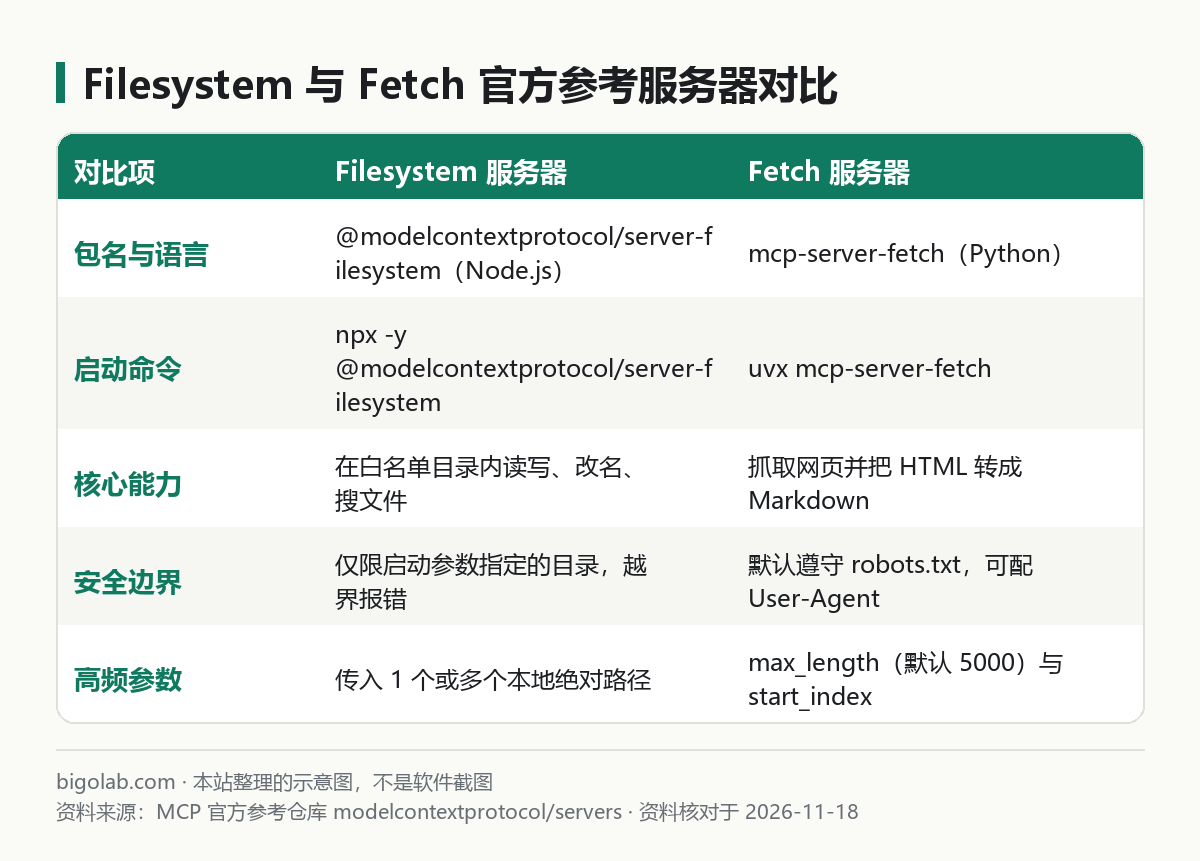
图:本站根据 MCP 官方参考仓库 modelcontextprotocol/servers 整理的示意图
本文根据 MCP 官方参考仓库《modelcontextprotocol/servers》及《Filesystem MCP Server》《Fetch MCP Server》、MCP 官方文档《Connect to local MCP servers》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 或 MCP 官方网站。
适用于谁
- 想在 Claude Desktop 里整理本地文档、批量改名或汇总网页资料,搜「filesystem mcp 配置」的人;
- 不清楚 Filesystem 白名单目录怎么写、为什么 Fetch 要装
uvx的用户; - 已经配好 JSON 却遇到越界报错、网页只抓一半或
robots.txt拦截的人。
一、运行前先准备两个命令行工具
这两个官方服务器分别用了不同的语言打包,装之前先在终端确认环境:
- Node.js(供 Filesystem 使用):运行
node --version确认已安装 LTS 版本,系统里能直接调用npx。 - uv 或 pip(供 Fetch 使用):官方推荐安装 Python 包管理器
uv,装好后自带uvx命令,可以在隔离环境里直接拉起mcp-server-fetch。如果不装uv,也可以用pip install mcp-server-fetch安装后通过python -m mcp_server_fetch启动。
如果你还不熟悉 Claude Desktop 配置文件在哪里打开,可以先看 Claude Desktop MCP 配置教程;想先了解协议原理,见 MCP 是什么。
二、在 Claude Desktop 里同时配好两个服务器
打开 claude_desktop_config.json(macOS 在 ~/Library/Application Support/Claude/,Windows 在 %APPDATA%\Claude\),在 mcpServers 对象里把两项一起写进去。
macOS 与 Linux 写法示例:
json
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "/Users/你的用户名/Documents/work-notes",
        "/Users/你的用户名/Downloads"
      ]
    },
    "fetch": {
      "command": "uvx",
      "args": [
        "mcp-server-fetch"
      ]
    }
  }
}
Windows 写法示例(注意反斜杠必须双写转义):
json
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "C:\\Users\\你的用户名\\Documents\\work-notes",
        "C:\\Users\\你的用户名\\Downloads"
      ]
    },
    "fetch": {
      "command": "uvx",
      "args": [
        "mcp-server-fetch"
      ]
    }
  }
}
保存文件后完全退出 Claude Desktop 再重新打开。点击输入框左下角的加号图标,在连接器(Connectors)管理列表里看到 filesystem 和 fetch 都处于已加载状态,说明进程启动成功。
三、Filesystem 的工具清单与白名单边界
官方 src/filesystem 说明文档列出了服务器暴露的主要工具:
| 工具名 | 作用 | 使用注意 |
|---|---|---|
read_text_file / read_multiple_files | 读取单个或多个文本文件内容 | 支持按行读取,一次读多个文件比循环单读更省往返次数 |
write_file | 新建文件或完整覆盖已有文件 | 会直接改写磁盘文件,批准前先核对路径 |
edit_file | 按匹配块局部替换文件内容 | 支持 dryRun 预览差异,改配置文件和文稿更稳妥 |
list_directory / create_directory | 列出目录内容、新建文件夹 | 仅限白名单目录内部 |
move_file / search_files / get_file_info | 移动或重命名文件、按模式搜文件、看元数据 | 源路径和目标路径都必须在允许目录内 |
关于权限边界,有两条实用规则:
- 只给最小工作目录:比如专门建一个
ai-workspace文件夹放待处理资料,不要把存有 SSH 密钥、浏览器配置或环境变量的用户主目录放进去。安装第三方服务器前的通用检查项可参考 MCP 服务器怎么选、装之前怎么审。 - 支持客户端 Roots 协议:如果宿主客户端实现了 MCP 的 Roots 能力,客户端也可以动态向 Filesystem 服务器声明允许访问的根目录;在 Claude Desktop 手动配 JSON 时,仍以
args传入的绝对路径为准。
四、Fetch 的抓取参数与分段读取方法
官方 src/fetch 服务器只提供一个核心工具 fetch,用来请求指定网址并把网页正文清洗成方便模型阅读的 Markdown。它的四个输入参数很实用:
url(必填):要抓取的网页完整地址。max_length(可选):单次返回的最大字符数,官方默认值为5000。start_index(可选):从第几个字符开始截取,默认从0开始。遇到长技术文档被截断时,直接让 Claude「接着上次的位置用start_index往后读完」即可。raw(可选):布尔值,设为true时不转 Markdown,直接返回网页原始文本或源码。
默认情况下,Fetch 服务器会先检查目标站点的 robots.txt,如果不允许自动化工具抓取就会拒绝请求。官方提供了两个可选启动参数,写在配置文件 fetch 的 args 里:
--ignore-robots-txt:忽略目标站点的robots.txt限制(仅在你有权访问且符合目标网站条款时使用);--user-agent="自定义名称":自定义请求头里的 User-Agent 字符串。
五、常见报错与替代思路
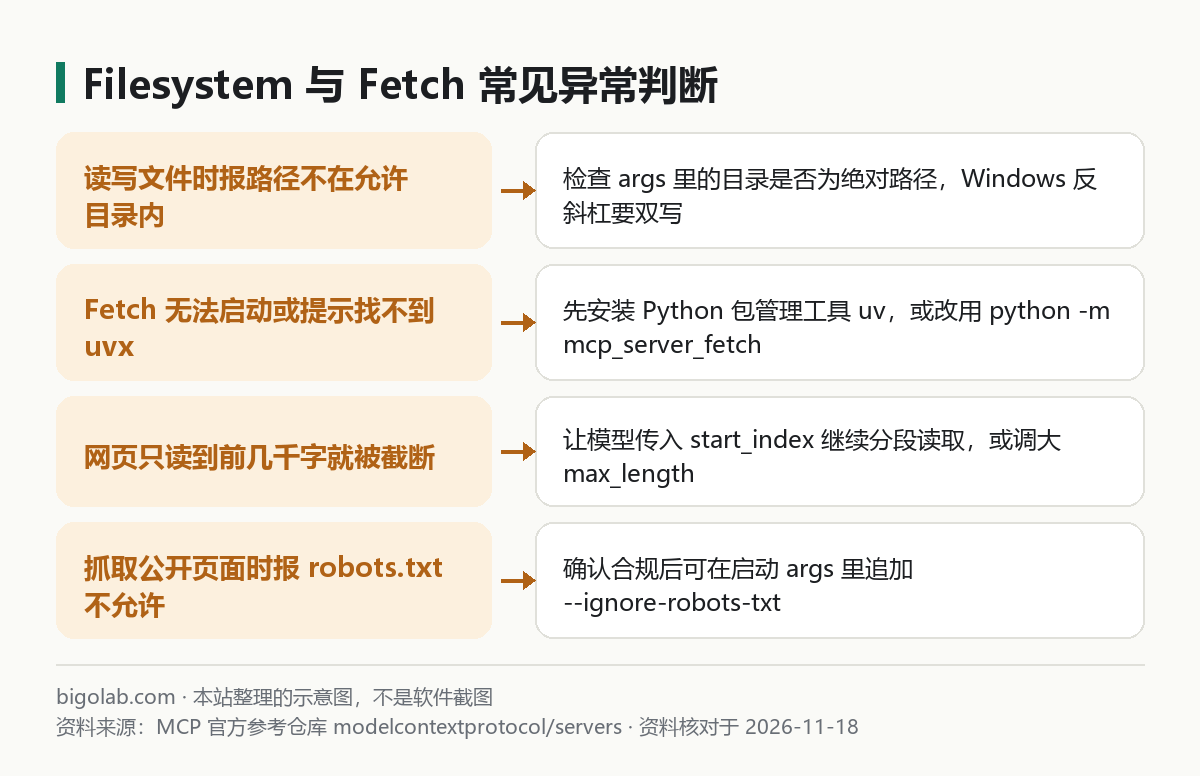
图:本站根据 MCP 官方参考仓库 modelcontextprotocol/servers 整理的示意图
日常使用中最常碰到四类问题:
- Windows 上启动时报
ENOENT或${APPDATA}路径错误:按 MCP 官方排错说明,在filesystem配置下加一个"env": {"APPDATA": "C:\\Users\\你的用户名\\AppData\\Roaming\\"},并确认执行过npm install -g npm。 - Fetch 抓不到动态渲染网页:
mcp-server-fetch走的是普通 HTTP 请求,不会启动真实浏览器跑前端 JavaScript。遇到必须前端渲染的页面,改用 Playwright 类浏览器 MCP 更合适。 - 长文件加长网页很快撞上免费版对话上限:连续读取多份本地文稿和网页正文会消耗较多上下文额度。如果经常卡在 5 小时限额,可以考虑升级 Claude Pro;要是你的日常工作主要是改代码仓库和跑终端脚本,其实不必在桌面版手工配 Filesystem,直接用自带本地读写与抓取工具的 Claude Code 更省事,它的 MCP 扩展方法见 Claude Code MCP 配置教程。
- 不确定是服务器挂了还是客户端没连上:先在终端用官方调试器单独跑一遍,具体命令见 MCP Inspector 怎么用。
常见问题
问:Claude Desktop 不是已经有网页搜索了吗,为什么还要装 Fetch?
答:内置联网搜索偏向按关键词检索摘要;Fetch MCP 则是把你指定的具体 URL 正文完整拉下来转成 Markdown,并支持用 start_index 分段读完长页面,适合精读接口文档或指定文章。
问:Filesystem 可以同时配置多个不相邻的文件夹吗?
答:可以。在 args 数组里跟在 @modelcontextprotocol/server-filesystem 后面依次追加多个绝对路径,用英文逗号隔开即可。
问:允许访问某文件夹后,模型修改或删除文件会先问我吗?
答:在 Claude Desktop 里,调用写文件、改文件、移动文件等工具前默认会弹出审批提示。点同意前务必看清传入的目标路径,防止覆盖原稿。
问:用 pip 装了 mcp-server-fetch 但不想装 uv 怎么写配置?
答:把 fetch 的 "command" 改成 "python"(或虚拟环境里 python.exe 的绝对路径),"args" 改成 ["-m", "mcp_server_fetch"] 即可。
问:配置好开发环境后,国内没有外币卡怎么开通 Claude 或 ChatGPT 编程订阅?
答:可在 本站充值中心 自助选购卡密开通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程无需交出账号密码,支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页为准。
相关教程
- Claude Desktop MCP 配置教程:claude_desktop_config.json 在哪、怎么写、不生效怎么查
- MCP 是什么:Model Context Protocol 入门,以及在 Claude 里怎么用
- Claude Code MCP 配置教程:claude mcp add、配置文件位置与常用 MCP
- MCP Inspector 怎么用:安装、启动命令、调试 MCP 服务器与 v2 的变化
- MCP 服务器怎么选、去哪找、装之前怎么审:官方安全清单与七步检查
参考资料
- MCP 官方参考服务器仓库:https://github.com/modelcontextprotocol/servers
- Filesystem MCP Server 官方说明:https://github.com/modelcontextprotocol/servers/tree/main/src/filesystem
- Fetch MCP Server 官方说明:https://github.com/modelcontextprotocol/servers/tree/main/src/fetch
- MCP 官方文档:Connect to local MCP servers — https://modelcontextprotocol.io/docs/develop/connect-local-servers
0 条评论
还没有评论,来抢沙发~