
结论先说
- 官方主力审核模型是
omni-moderation-latest,基于多模态底座构建,支持在同一次/v1/moderations请求里同时传入文本与图片(旧版text-moderation-latest仅支持纯文本)。 - 审核接口本身免费调用:官方定价页明确标注 Moderation API 不收 token 费用,但每分钟请求数(RPM)和每分钟 token 数(TPM)仍受你账号当前用量层级的限制。
- 先审后调能节省主模型成本:在把用户输入发往高单价推理或生成模型之前先调审核接口,一旦返回
flagged: true直接在业务层礼貌拦截,既降低账号违规风险,也省去后续生成开销。 - 返回对象提供四组关键字段:总判定布尔值
flagged、各细分维度布尔值categories、0 到 1 的连续分数category_scores,以及指出由哪种输入模态触发标记的category_applied_input_types。 - 留意模态覆盖边界:当前支持文本与图片(公开 HTTPS 链接或 Base64 数据),不支持直接传入音频;其中
illicit(违规行为指导类)目前只对文本输入生效。 - 国内免境外卡开通入口:若没有境外银行卡或遇到支付被拒,可在本站通过支付宝、微信支付或 AlipayHK 自助获取兑换码开通 ChatGPT Plus 或 ChatGPT Pro,团队多席位支持联系客服定制 ChatGPT Business 团队版。
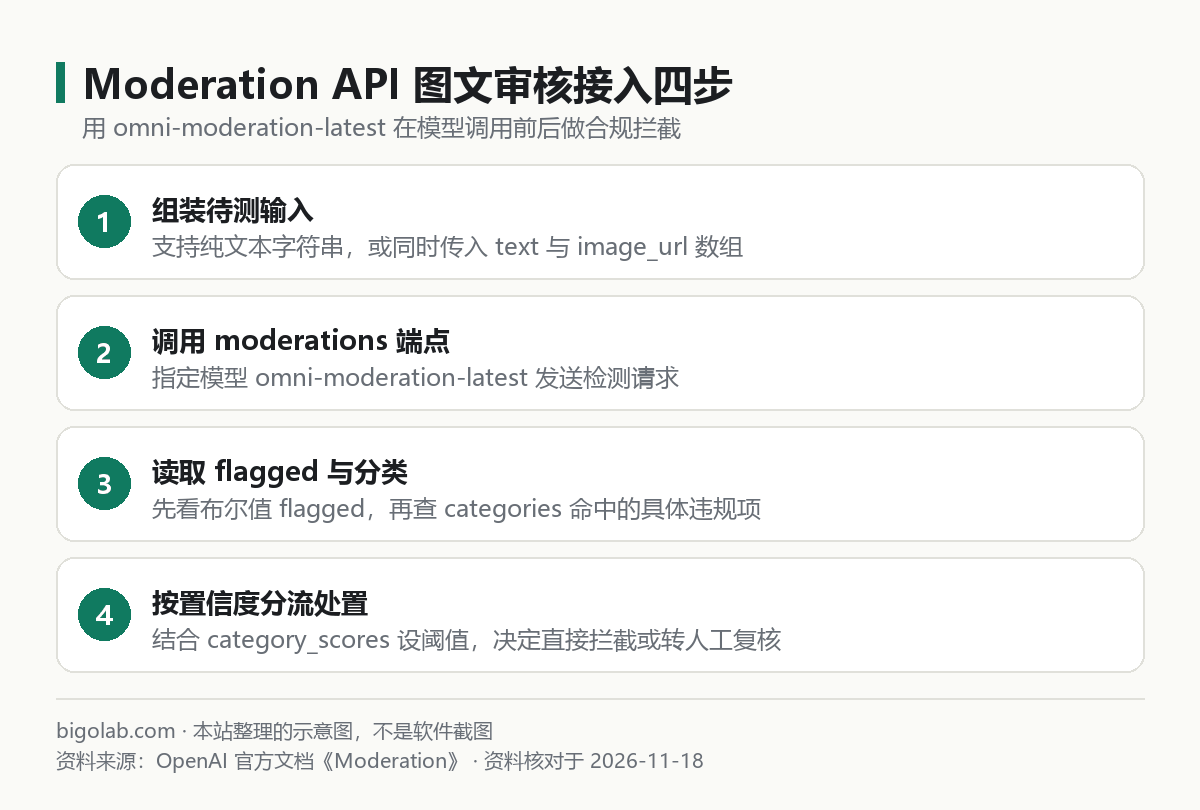
图:本站根据 OpenAI 官方文档:Moderation 整理的示意图
本文根据 OpenAI 官方文档《Moderation》与官方定价页整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 开发面向外部用户的对话助手、表单处理或图文生成应用,需要在把内容发给主模型之前先做一层合规过滤的开发者;
- 之前只用过旧版纯文本审核接口,想知道怎么在一次请求里同时检测文字与图片的工程师;
- 担心增加安全护栏会让 API 调用账单显著上涨的人。
一、纯文本与图文混合调用代码(Python)
调用前请确保已在环境变量配置好 OPENAI_API_KEY(还没跑通过首个 API 请求的读者可先看 /guides/openai-api-python-quickstart)。
1. 检测单条或批量纯文本
input 参数既可以传单个字符串,也可以传字符串数组,一次批量检测多条用户留言:
python
from openai import OpenAI

client = OpenAI()

resp = client.moderations.create(
    model="omni-moderation-latest",
    input="这里放入待检测的用户提问或生成文本",
)

result = resp.results[0]
print("是否命中拦截规则:", result.flagged)
2. 在一次请求里同时检测文字与图片
当你的产品允许用户附带截图或照片提问时(常规视觉传图规范见 /guides/openai-api-image-input),可以把 input 组装成包含 text 与 image_url 的多模态数组,图片支持公开网址或 Base64 编码的 Data URI:
python
resp = client.moderations.create(
    model="omni-moderation-latest",
    input=[
        {"type": "text", "text": "请帮我为这张活动配图写一段宣传文案"},
        {
            "type": "image_url",
            "image_url": {"url": "https://example.com/poster-draft.png"},
        },
    ],
)

res = resp.results[0]
if res.flagged:
    print("命中风险项,触发来源模态:", res.category_applied_input_types)
二、返回结构拆解:怎么看懂四个核心字段
每次调用 moderations.create 返回的 results 列表里,每个元素都包含四块结构化数据:
| 返回字段 | 数据类型 | 业务用途说明 |
|---|---|---|
flagged | 布尔值 | 只要任一细分风险维度超过官方默认判定线即为 true,适合做快速总开关 |
categories | 键值布尔字典 | 列出 hate、harassment、violence、illicit 等官方一级与二级分类各自的布尔判定结果,完整键名列表以官方文档表为准 |
category_scores | 键值浮点字典 | 给出每个分类 0 到 1 之间的模型置信度得分,便于业务方按自身严格度重设阈值 |
category_applied_input_types | 键值数组字典 | 图文混传时标明某分类是由 ["text"]、["image"] 还是两者共同触发,方便前端给出精准提示 |
关于 OpenAI 平台整体禁止哪些内容场景,可对照阅读 /guides/chatgpt-restricted-content-usage-policy。如果你并非接入 API,而是在日常使用网页端时关心订阅账号权限与升级方式,可查看本站 ChatGPT Plus 说明页,注意个人会员订阅与开发者 API 属于两套独立系统。
本站订阅与团队开通提示:如果你在国内遇到银行卡被拒或急需提升对话与推理配额,可前往本站 ChatGPT Plus 充值说明页 或 ChatGPT Pro 5x/20x 充值页 自助获取卡密完成开通(全程无需交出账号密码,可开增值税发票);企业多成员协作可直接查看 ChatGPT Business 团队定制方案。
三、工程落地时的分流与防踩坑建议
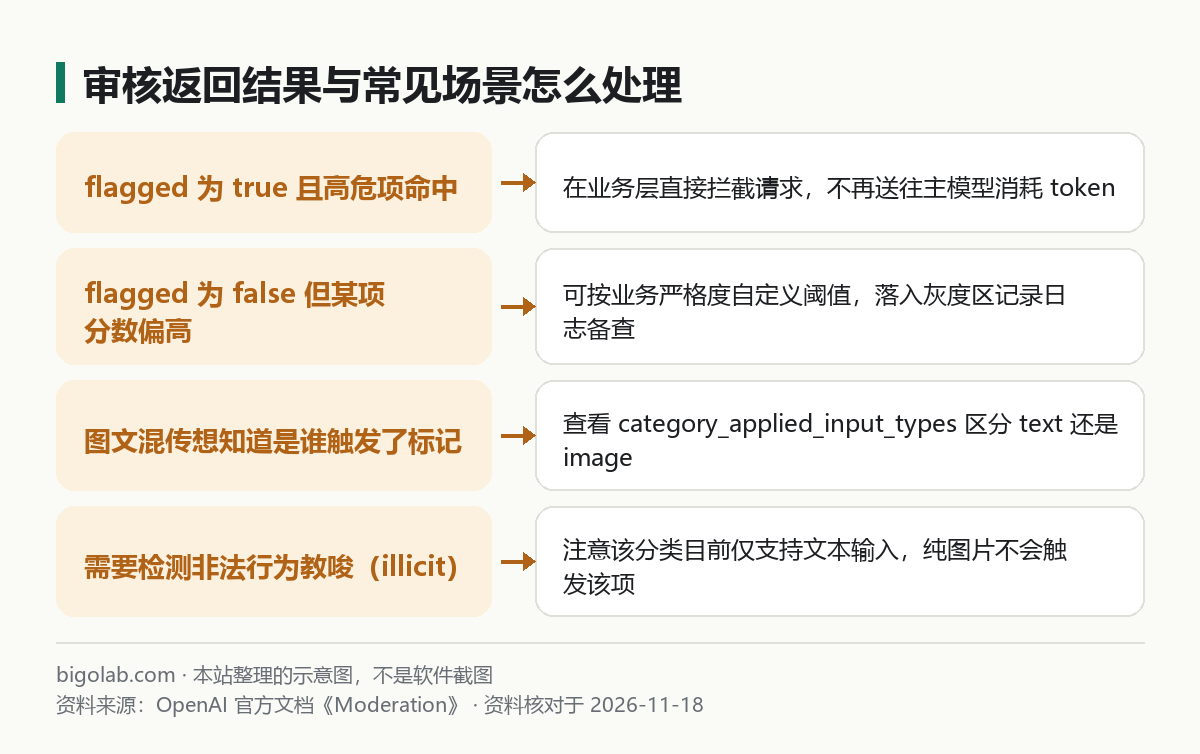
图:本站根据 OpenAI 官方文档:Moderation 整理的示意图
把审核接口真正放进生产链路时,建议做好以下三件事:
- 输入与输出双端设防:除了在调主模型前做输入侧检查(Input Guardrail),对安全要求严苛的公开应用还可以把主模型吐出的草稿再过一遍审核接口,确认无误后再返回给终端页面,也可异步并行执行以减少首字等待。
- 按业务场景微调分数线:不同行业对边界内容的容忍度差异很大。儿童教育类应用可以把
category_scores的拦截阈值调得比默认flagged更严;而新闻摘要、法学检索类工具若遇到正常专业术语误报,可设置灰度分数区间转人工抽检。 - 预留速率余量并处理长文:新建或低层级 API 账号的每分钟请求上限较低,高并发上线前请核对 /guides/openai-api-usage-tiers-rate-limits。另外遇到上万字长文档时,单句违规内容容易被大段常规叙述稀释分数,建议按自然段落切分后放进数组批量送检。
常见问题
问:既然 Moderation API 免费,能拿来单独审核与 OpenAI 无关的普通社区回帖吗?
不建议。按 OpenAI 官方使用政策说明,该免费端点旨在帮助开发者保障围绕 OpenAI 构建的应用安全;脱离 OpenAI 模型调用场景、单纯把它当作第三方免费内容审核接口高频刷量,可能触发平台限制或违反使用条款。
问:底层模型迭代后,我写死在代码里的分数阈值需要改吗?
需要定期复核。omni-moderation-latest 指向持续更新的最新快照,官方明确提示模型升级后同一段文本的概率校准值可能发生变化;依赖自定义 category_scores 阈值的系统,应在模型更新后用固定测试集重测一遍。
问:传入中文或中英混排内容能正常识别吗?
可以。相比早期侧重英文的旧版纯文本审核模型,基于多模态底座的新模型对中文等主流语种的语义理解能力提升明显,日常中文问答和常见图文场景可直接接入。
问:国内没有境外信用卡,怎么开通或续费 ChatGPT Plus / Pro?
答:可在本站使用支付宝、微信支付或 AlipayHK 下单获取卡密自助兑换(支持 ChatGPT Plus、Pro 5x 可覆盖档 与 Pro 5x 空白号档),实时价格、兑换前提与售后规则(掉订阅按剩余天数折退,封号不在质保范围)以对应页面说明为准。
相关教程
参考资料
- OpenAI 官方文档:Moderation — https://developers.openai.com/api/docs/guides/moderation
- OpenAI 官方定价页 — https://developers.openai.com/api/docs/pricing
0 条评论
还没有评论,来抢沙发~