
结论先说
- Claude Code 没有云端自动同步给全组的「隐式聊天记忆池」:官方的自动记忆(auto memory)是纯本地 Markdown 文件,只留在你自己的电脑上,不会自动传给队友。
- 你本机的多个
git worktree默认共享同一份自动记忆:同一个 Git 仓库衍生出的各个工作树与子目录,共用同一个~/.claude/projects/<project>/memory/目录。 - 真正的「团队共享记忆」靠 Git 版本控制实现:载体是仓库根目录的
./CLAUDE.md(或./.claude/CLAUDE.md)以及模块化的./.claude/rules/*.md。 - 最稳妥的团队记忆流转是「个人自动积累 → 人工筛选提炼 → PR 合入仓库」:平时让自动记忆接住零散纠偏,每周挑出全组通用的经验写进
CLAUDE.md或rules/,避免未经审核的个人习惯污染全组上下文。
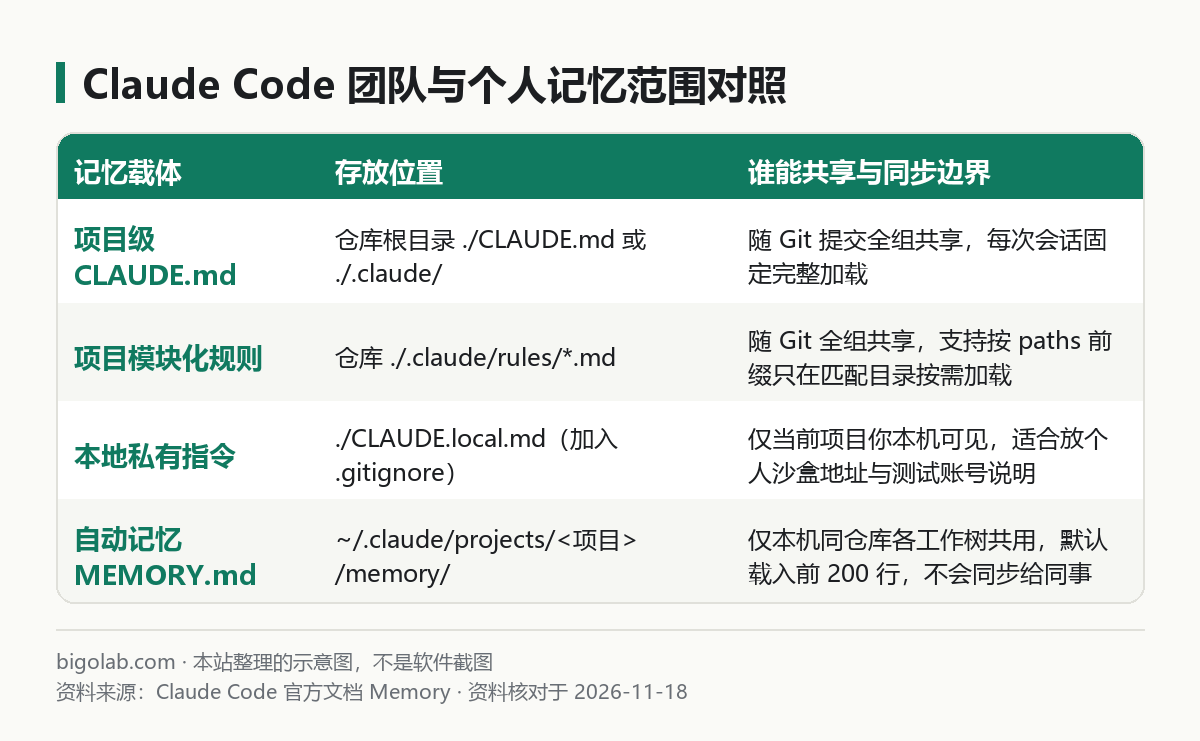
图:本站根据 Claude Code 官方文档:How Claude remembers your project 整理的示意图
本文根据 Claude Code 官方文档《How Claude remembers your project》整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 搜「claude code共享记忆」「claude code 团队记忆怎么同步」的人;
- 团队多人维护同一个代码仓库,发现自己纠正过的坑同事那边的 Claude Code 完全不知道的人;
- 同时开多个
git worktree并行开发,想知道记忆文件能不能跨工作树共用的开发者。
如果你还不清楚 CLAUDE.md 为什么不会自己改动,可以先看 /guides/claude-md-auto-update-how-to-update;如果你只配个人全局偏好,见 /guides/claude-code-global-claude-md-user-level。本文专门拆解「跨工作树本机共享」与「跨成员团队共享」的边界和落地做法。
一、先分清两层「共享」:同机跨工作树 vs 跨成员跨机器
大家搜「共享记忆」通常指两种完全不同的场景,官方机制对这两者的处理截然不同:
1. 同一台机器上的多会话 / 多工作树共享(自动生效)
当你用 claude --worktree 或 git worktree 同时开三四个并行分支改需求时(用法见 /guides/claude-code-worktree),官方明确说明:属于同一个 Git 仓库的所有工作树和子目录共用同一个自动记忆目录 ~/.claude/projects/<project>/memory/。
目录里有一个主索引 MEMORY.md 和若干按主题拆分的笔记文件。每次新开会话时,Claude Code 自动载入 MEMORY.md 的前 200 行(或前 25KB,以先到为准),其余主题文件在需要时按需读取。因此你在 A 分支纠正过一次「本仓库测试必须带某个环境变量」,切到同仓库的 B 工作树新开会话时,本机的 Claude 依然记得。
2. 团队成员之间的跨机器共享(必须进 Git)
自动记忆保存在你的系统用户主目录下,不在项目仓库里,也不会通过账号在云端同步给其他成员。想让全组所有人的 Claude Code 一拉代码就拥有相同的项目背景,官方指定的唯一共享通道就是随代码提交进 Git 的项目级指令文件。关于团队权限和插件的配套共享,可一并参考 /guides/claude-code-team-collaboration-shared-config。
二、团队项目记忆该怎么组织才不撑爆上下文
如果全组所有人都往根目录同一个 CLAUDE.md 里塞经验,不出一个月文件就会突破几百行,既拖慢每次启动消耗的额度,又容易出现前后矛盾的规则。按官方推荐的拆分方式,建议按「全局必读 + 目录按需」两层存放:
- 根目录
CLAUDE.md(控制在 200 行以内):只放全员每次改代码都绕不开的硬信息,例如包管理器与构建测试命令、分层架构红线、提交前必跑检查; - **
.claude/rules/.md(按业务域和路径懒加载)*:把只在特定模块才用得到的记忆拆成独立文件,并用 YAML 顶部的paths字段限定触发范围。
例如前端表单校验的历史踩坑,可以写进 .claude/rules/frontend-forms.md 并提交 Git:
markdown
---
paths:
  - "src/components/forms/**/*.tsx"
---

# 表单组件团队约定
- 统一使用项目封装的 `useAppForm` 钩子,不要直接裸调底层校验库
- 异步提交按钮必须绑定返回的 `isSubmitting` 状态防止重复点击
官方说明:不带 paths 的规则文件会在启动时同 CLAUDE.md 一起载入;带了 paths 的文件只有当 Claude 真正读取或编辑匹配路径下的文件时才载入上下文,非常适合沉淀大团队的模块级记忆。
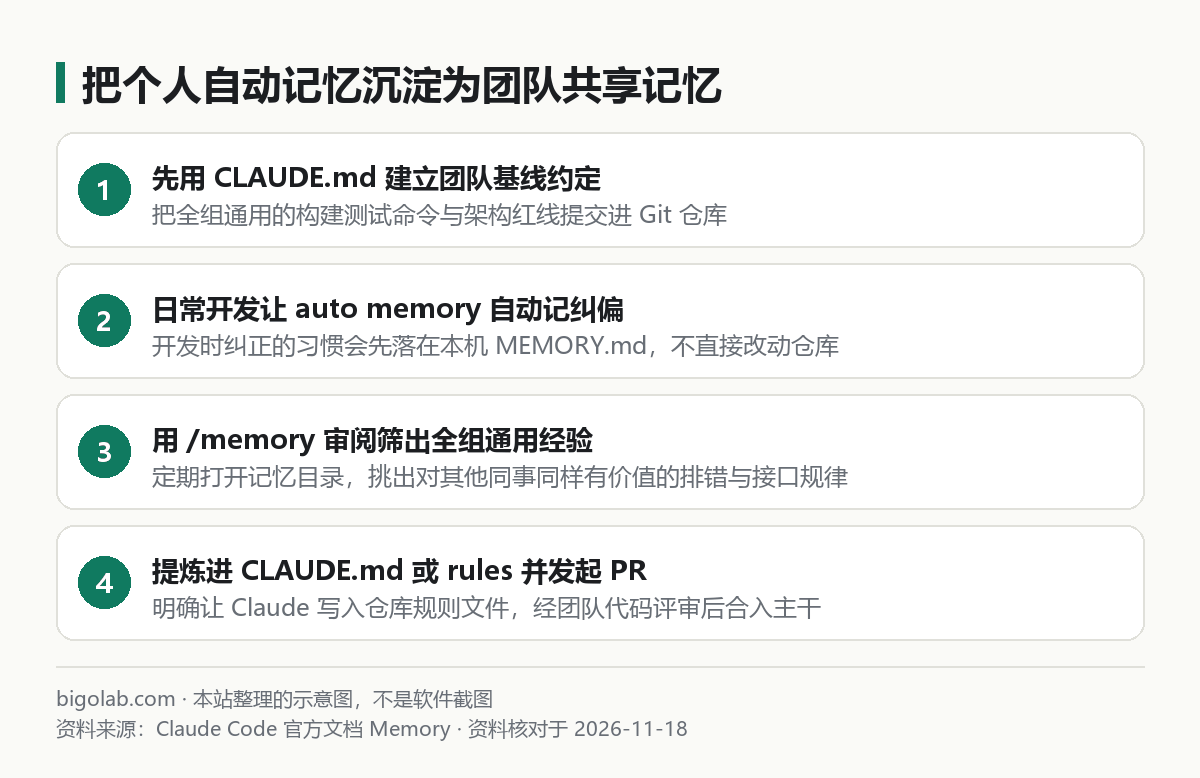
图:本站根据 Claude Code 官方文档:How Claude remembers your project 整理的示意图
三、怎么把个人 MEMORY.md 里的好经验转成团队共享记忆
为什么官方不设计成「所有人的自动记忆直接自动写进仓库」?因为自动记忆里混杂着大量个人偏好(比如某位成员习惯让模型用英文简短回答、或者本机临时连了某个测试端口),直接推给全组反而会互相干扰。
更合理的团队协作习惯是定期做一次「记忆提炼」:
- 打开
/memory查看本机积累:检查当前项目自动记忆里最近记下的feedback(纠偏)和project(项目决策)条目; - 区分个人习惯与项目事实:纯个人调试设置留在本机自动记忆或写进已加入
.gitignore的CLAUDE.local.md;凡是「新同事接手也会踩坑」的构建细节、接口约定,才需要升级为团队记忆; - 明确指令写入仓库文件:在对话里对 Claude 说「把我自动记忆里关于数据库迁移的注意事项整理成两条精简规则,加到
.claude/rules/db.md」,提交 Pull Request 让队友审阅确认; - 定期跑
/doctor prompt-audit清理过期记忆:代码重构后旧记忆容易变成误导信息,运行该命令可以让 Claude 扫描仓库里的CLAUDE.md与.claude/rules/,找出指向已删除文件或互相冲突的旧条目报告给你。
团队日常使用若涉及个人订阅开通或续费方案对比,也可查看 /chongzhi/claude-code 的官方订阅层级整理。
常见问题
Q:能用软链接或同步盘把 ~/.claude/projects/<project>/memory/ 强行全组同步吗?
不建议这样做。多人同时在不同机器会话里触发自动记忆写入,极易造成 MEMORY.md 覆盖冲突,而且会把别人的个人角色设定(user 类笔记)混进你的会话。团队共享请始终走 Git 仓库里的 CLAUDE.md 和 .claude/rules/。
Q:某个项目不想让 Claude 往本机写自动记忆,怎么关掉?
如果全组希望某个敏感仓库统一关闭自动记忆,可以在项目共享的 .claude/settings.json 里加上 "autoMemoryEnabled": false,这样所有拉取该仓库的成员在该项目下都不会生成本机自动记忆文件。
Q:公司所有仓库都要遵守同一套安全或合规底线,每个仓库拷一份 CLAUDE.md 太麻烦怎么办?
官方支持组织级(Managed policy)CLAUDE.md,由企业 IT 统一部署到系统级固定路径(如 macOS 的 /Library/Application Support/ClaudeCode/CLAUDE.md 或 Windows 的 C:\Program Files\ClaudeCode\CLAUDE.md),对机上所有项目自动生效。
相关教程
- /guides/claude-md-auto-update-how-to-update:自动记忆 auto memory 与
CLAUDE.md的区别 - /guides/claude-code-global-claude-md-user-level:全局
~/.claude/CLAUDE.md与各层级范围详解 - /guides/claude-code-team-collaboration-shared-config:Claude Code 团队共享配置与插件管理
- /guides/claude-code-worktree:多工作树(worktree)并行开发指南
参考资料
- Claude Code 官方文档:How Claude remembers your project — https://code.claude.com/docs/en/memory
0 条评论
还没有评论,来抢沙发~