
結論先說
- 百頁 PDF 一把傳上去直接問「幫我總結全文」,漏頁幾乎是必然的:按 OpenAI 文件處理機制,超長文檔往往通過後台分塊檢索(按關鍵詞撈取最相關的若干片段)進入對話,而不是把 300 頁逐字平鋪進單次上下文(上下文容量邊界見 ChatGPT 上下文長度與記憶限制說明)。
- 「編造頁碼」大多有兩個真兇:一是模型只看到了檢索片段卻沒拿到真實頁腳編號於是自己估算頁碼,二是封面與目錄佔了十幾頁,導致「PDF 閱讀器物理頁碼」和「正文印刷頁碼」天生錯位。
- 防漏頁的核心鐵律就三條:「先驗可複製文本 + 按 20–40 頁拆章 + 強制附 15 字以上原文引句」:只要模型給出逐字原文引句,你在本地 PDF 閱讀器裏
Ctrl+F搜尋,3 秒就能驗證它到底有沒有編造。 - 遇到純掃描件標書或模糊蓋章頁,先 OCR 再上載:直接把幾百頁圖片型 PDF 扔給 ChatGPT 極易報無法提取文本或看串數字(排查與轉換方法見 掃描版 PDF 無法提取文本 OCR 修復指南)。
- 長文檔高頻分析檔位入口:單月常規分析論文或標書可在 ChatGPT Plus 充值專題頁 選擇 ChatGPT Plus iOS 訂閱通道卡密;如果每天連讀多份數百頁招股書、需要更大文件並發與高階推理配額,直接看 ChatGPT Pro 充值專題頁。
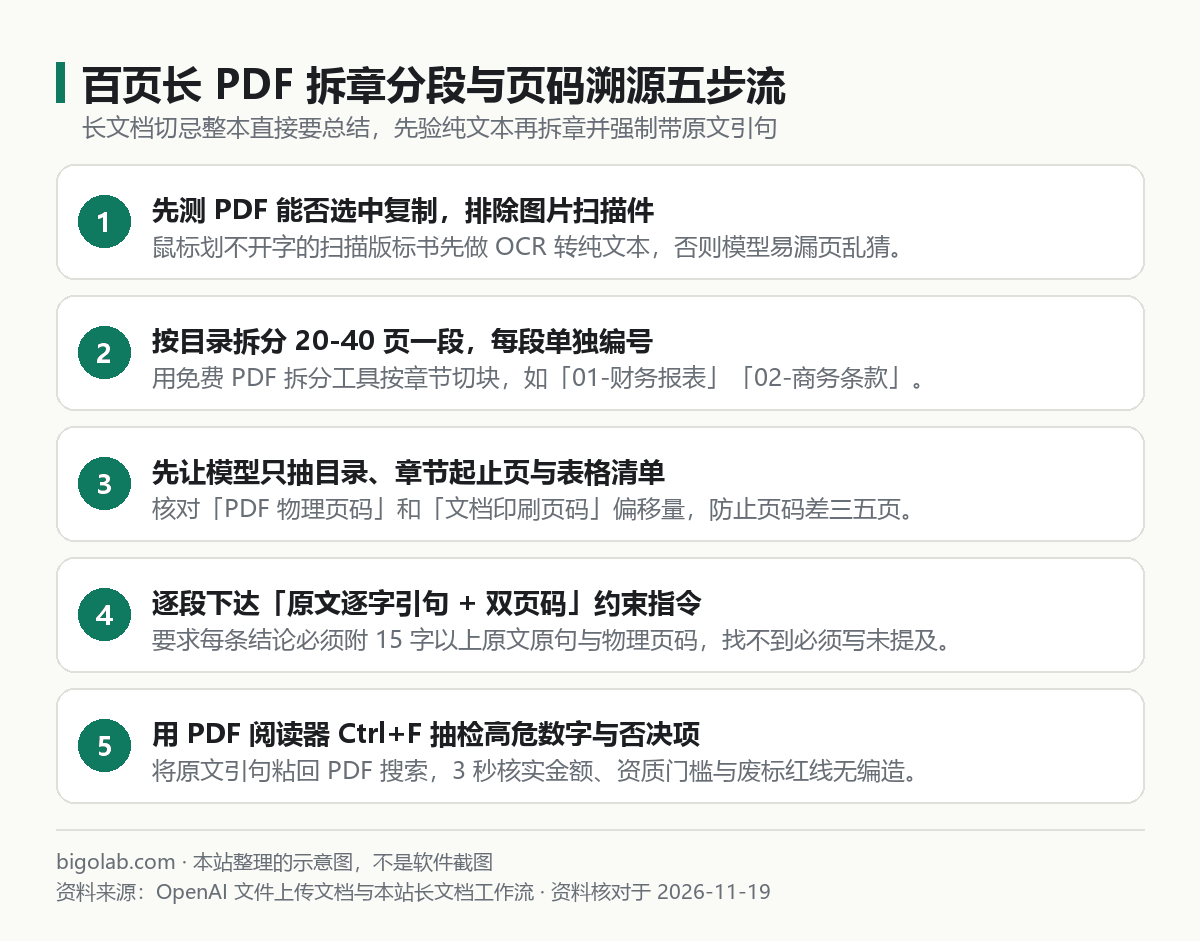
圖:本站根據 OpenAI File Uploads FAQ 與本站長文檔實戰整理的示意圖
本文根據 OpenAI 幫助中心《File Uploads FAQ》《File storage and library in ChatGPT》《OpenAI Academy: Working with Files》及本站長文檔實務整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 需要通讀 100–400 頁招股書、上市公司年報、招標文件或碩博長論文,怕模型跳過關鍵廢標條款或核心實驗數據的職場人與研究生;
- 吃過「ChatGPT 信誓旦旦說在第 68 頁,翻開第 68 頁完全是另一件事」的虧,想徹底杜絕編造頁碼的人;
- 上載整本 PDF 後發現表格數字錯行、或者系統提示無法提取正文文本的文檔分析用戶。
一、五步防跳頁漏讀與防編造頁碼工作流
處理任何超過 50 頁的重要 PDF(尤其是標書、盡調材料和長論文),本站建議放棄「整本一鍋燉」,嚴格按這五步推進(基礎 PDF 提煉技巧另見 ChatGPT 總結 PDF 文檔指南):
- 先做 10 秒文本體檢,排除掃描圖片件:在電腦打開 PDF,用滑鼠拖選正文和表格裏的幾行數字,看能否順利選中並複製成正常中文。如果點上去整頁變藍或粘出來全是亂碼,立刻先用本地 OCR 工具轉為可檢索文本 PDF 再繼續。
- 按目錄把長 PDF 拆成 20–40 頁一段的章節文件:把 200 頁招股書或標書按大目錄拆成 5–7 個小文件(例如
01-投標人須知_P1-35.pdf、02-商務與廢標項_P36-70.pdf)。拆完後每個小文件完全落入模型高精度通讀區間,不再依賴碎片化抽樣。 - 先讓模型用 Python 解析腳本提取「物理頁碼 + 章節錨點」:上載拆分後的章節文件時,讓它優先借助內置代碼解釋器逐頁讀取文本並核對頁碼偏移量,避免「閱讀器第 18 頁」和「書頁腳第 5 頁」混為一談。
- 每章必加「原文逐字引句 + 找不到寫未提及」防編造模板:
text
請逐頁通讀這份拆分章節 PDF(如可用,請用 Python 腳本逐頁提取文本核對),提取所有與 [廢標條件/違約責任/核心財務假設] 相關的條款,嚴格按以下四列輸出表格:
1. 條款要點(不超過 40 字);
2. PDF 物理頁碼(第幾頁)與正文印刷頁碼;
3. 原文逐字摘錄(必須直接複製文檔內 15-30 字連續原句,嚴禁改寫);
4. 風險等級或備註。
規則:嚴禁推測或補全文檔未寫明的資訊;如果本章節未出現相關內容,請直接回復「本章節未提及」。- 本地
Ctrl+F抽檢與多章歸併:拿到每章表格後,把高風險條目的「原文逐字摘錄」粘進本地 PDF 閱讀器按Ctrl+F核驗。能搜到就 100% 真實無誤;搜不到立刻定位並人工補看。所有分章表審完後,另開一個乾淨的新對話,把各章核驗通過的純文本表格合在一起做最終總覽,避免單次對話過長忘掉前面章節。
開通與選購提示:法務、投研或諮詢從業者頻繁拆分處理上百頁長文檔時,Plus 單日文件與高階模型次數較易見頂(差異見 ChatGPT Plus 與 Pro 檔位區別)。當前已有在期 Plus 需要立刻頂掉擴容可選 ChatGPT Pro 5x iOS 可覆蓋檔,已退回 Free 的乾淨空白號可選 ChatGPT Pro 5x 信用卡不可覆蓋檔,日均超大文檔批處理重度用戶可看 ChatGPT Pro 20x 充值檔位,實時售價均以頁面標價為準。
二、漏頁、讀歪表格或編造頁碼排障分流
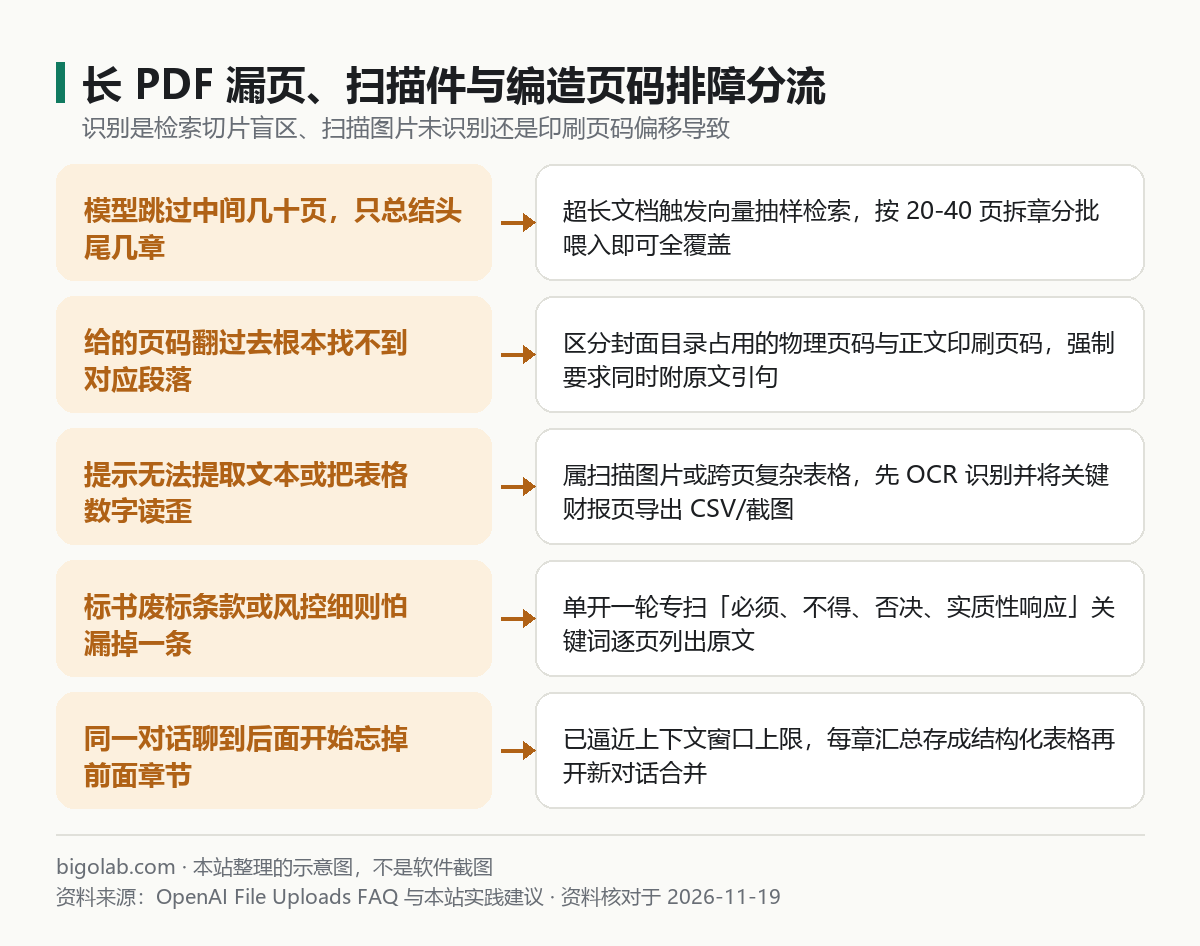
圖:本站根據 OpenAI Working with Files 與實務排障經驗整理的示意圖
尤其提醒標書和招股書讀者:跨頁合併單元格的財務大表是所有大模型最容易讀錯行的薄弱環節。涉及營收、毛利率、報價上限表等關鍵數字頁,最穩的做法是把那 2–3 頁表格單獨截圖或轉成 Excel/CSV 再上載,並讓模型做行列加總交叉校驗,把算術錯誤擋在交付之前。
常見問題
問:為什麼有時候我在同一個對話裏連傳了 5 個章節 PDF,到第 4 個就開始張冠李戴?
答:這是長對話上下文擁擠造成的注意力稀釋。本站建議把每個重要章節的提取結果複製儲存到本地文檔,每跑完 2–3 個章節就開一個新對話繼續後續章節,最後再把提煉好的結構化摘要彙總分析,準確度遠高於在一個百輪超長窗口裏死磕。
問:用 ChatGPT 讀公司涉密標書或未公開招股書,數據會不會被拿去訓練模型?
答:個人 Plus / Pro 帳號預設需在「Settings > Data Controls」手動關閉模型訓練選項;如果文檔涉及嚴格商業保密義務,優先對客戶名和報價做脫敏處理,或者使用預設「業務數據不用於模型訓練」的 ChatGPT Business 團隊工作空間。
問:國內沒有外幣卡怎麼開通 ChatGPT Plus / Pro / Business,可否開具增值稅發票報銷及售後規則?
答:前往本站 AI 會員充值總覽 即可用支付寶、微信支付或 AlipayHK 自助下單,免海外信用卡且免交帳號密碼,所有檔位實時價格以頁面標價為準。個人乾淨空白號日常用首選 ChatGPT Plus 信用卡通道自助卡密,3 人以上法務、投研或教研團隊需要保密工作區、對公轉賬與服務合同請對接 ChatGPT Business 團隊定製。全線均支持由國內經營主體開具增值稅發票(標價不含稅,另付 6% 稅費;收據不加稅)。售後遵循公示條款:未使用卡密可按規則退換,已核銷卡密不退;訂閱期內非自身原因掉訂閱按剩餘天數折退,封號不在質保範圍。
相關教學
- ChatGPT 怎麼總結長 PDF 文檔:上載限制、分段方法與提問技巧
- ChatGPT 提示無法提取 PDF 文本怎麼辦:掃描版文檔 OCR 識別修復
- ChatGPT 上下文長度限制是多少:長對話失憶原因與分段策略
- ChatGPT Plus 與 Pro 檔位區別:額度、深度研究與適用人群對比
0 條評論
還沒有評論,來搶沙發~