
結論先說
- 絕不要把幾百兆的原始
.heapsnapshot直接丟給 Codex,正確做法是先採集「三點差分摘要」。在預熱穩定後取第 1 份快照,持續施壓後再取第 2、第 3 份,只提取兩次之間淨增長排前 20 的構造器、保留大小(Retained Size)與引用路徑摘要餵給 Codex,既省額度又能直擊真兇。 - 先區分是「託管堆內存泄漏」「原生堆/RSS 增長」還是「文件/Socket 句柄泄漏」。Node.js 看
heapUsed與rss/external的剪刀差,Python 看tracemalloc與進程 RSS,句柄泄漏則直接用lsof -p <pid>統計ESTABLISHED、CLOSE_WAIT或未關閉文件描述符類型。 - Node.js 與 Python 內存及句柄泄漏的八成高頻根因集中在五類:無上限全局緩存(Map/dict 沒配 LRU 或 TTL)、事件監聽器只註冊不註銷、閉包/定時任務持有大請求上下文、未用
with/finally關閉文件或 HTTP Session、以及原生擴展/Buffer 未釋放。 - 修完必須補一條「N 次循環 + 強制 GC 後檢查增長閾值」的自動化復現驗證(結合日誌與二分定位技巧可參閱 /guides/codex-debug-production-logs-git-bisect-repro),確認內存和 FD 曲線徹底拉平後再上生產。
- 排查疑難線上泄漏常需跨業務代碼、框架中間件與多輪採樣摘要反覆交叉推演,對模型推理與上下文額度要求較高。國內缺少外幣卡的開發者可在本站自助開通 ChatGPT Plus 充值 或無 5 小時限額的 ChatGPT Pro 充值,團隊多人研發排障可諮詢 ChatGPT Business 團隊定製。
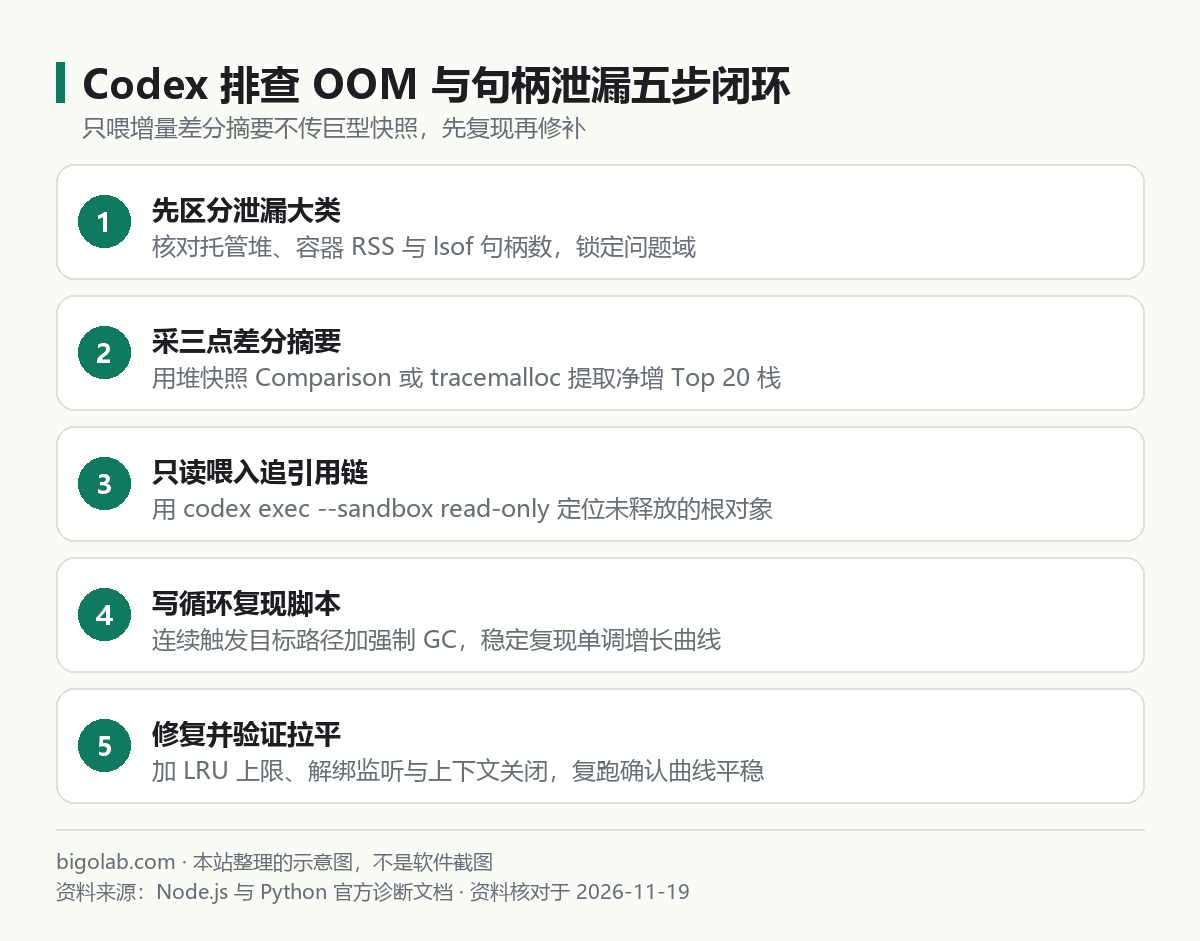
圖:本站根據 Node.js Memory Diagnostics 與 Python tracemalloc 文檔整理的排障流程示意圖
本文根據 OpenAI Codex 官方文檔《Codex CLI》《Non-interactive mode》、Node.js 官方文檔《Memory Diagnostics》及 Python 官方文檔《tracemalloc》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 面臨線上 Node.js 或 Python 容器內存呈鋸齒狀一路爬升、每隔幾小時或幾天被 Kubernetes / Linux 觸發
OOMKilled (Exit 137)的後端工程師; - 遇到服務運行一段時間後報
EMFILE: too many open files、Socket 句柄耗盡或數據庫連接莫名被打滿的開發者; - 面對幾百兆的
.heapsnapshot或火焰圖文件不知從哪下手,想借助 Codex 結合源碼快速定位泄漏引用鏈的排障人員。
一、第一步:按症狀分流,採集可消化的「增量證據」
動手讀代碼前,先用 5 分鐘把泄漏歸到準確的大類,只收集對比增量摘要而不是海量原始文件:
1. Node.js 堆內存與句柄採樣
- 堆快照對比:在測試或灰度實例用
node --heapsnapshot-signal=SIGUSR2 app.js啟動(或在診斷端點調用v8.writeHeapSnapshot()),穩定預熱後發一次信號拍快照 A,重複觸發疑似請求 500 次並等一次 GC 後拍快照 B。用 Chrome DevTools Memory 的 Comparison 視圖(或讓 Codex 寫一個簡短 Node 腳本解析快照節點計數差)導出淨增長前 20 的對象類型與保留路徑(Retainer Tree)。 - CPU / 內存分配火焰圖:結合
--heap-prof導出.heapprofile摘要,提取分配字節數排前 15 的函數調用棧。 - 句柄排查:持續觀察
lsof -p <pid> | awk '{print $5, $8}' | sort | uniq -c | sort -rn | head -n 20,快速看出漲的是普通文件、PIPE還是處於CLOSE_WAIT的 TCP Socket。
2. Python 內存增量與句柄採樣
利用標準庫 tracemalloc 在測試腳本里直接打印兩次採樣間的 Top 15 淨增長代碼行(無需引入笨重依賴):
python
import gc, tracemalloc

tracemalloc.start(25)  # 保留 25 層調用棧便於定位業務入口
snap1 = tracemalloc.take_snapshot()

# ... 連續執行 500 次目標接口或批處理任務 ...
gc.collect()
snap2 = tracemalloc.take_snapshot()

for stat in snap2.compare_to(snap1, "traceback")[:15]:
    print(f"diff={stat.size_diff/1024:.1f}KB count_diff={stat.count_diff}")
    for line in stat.traceback.format()[:6]:
        print("  ", line)
若是進程句柄泄漏,同樣通過 ls -l /proc/<pid>/fd | wc -l 與 lsof -p <pid> 輸出增長最多的目標路徑或遠端 IP:端口彙總。
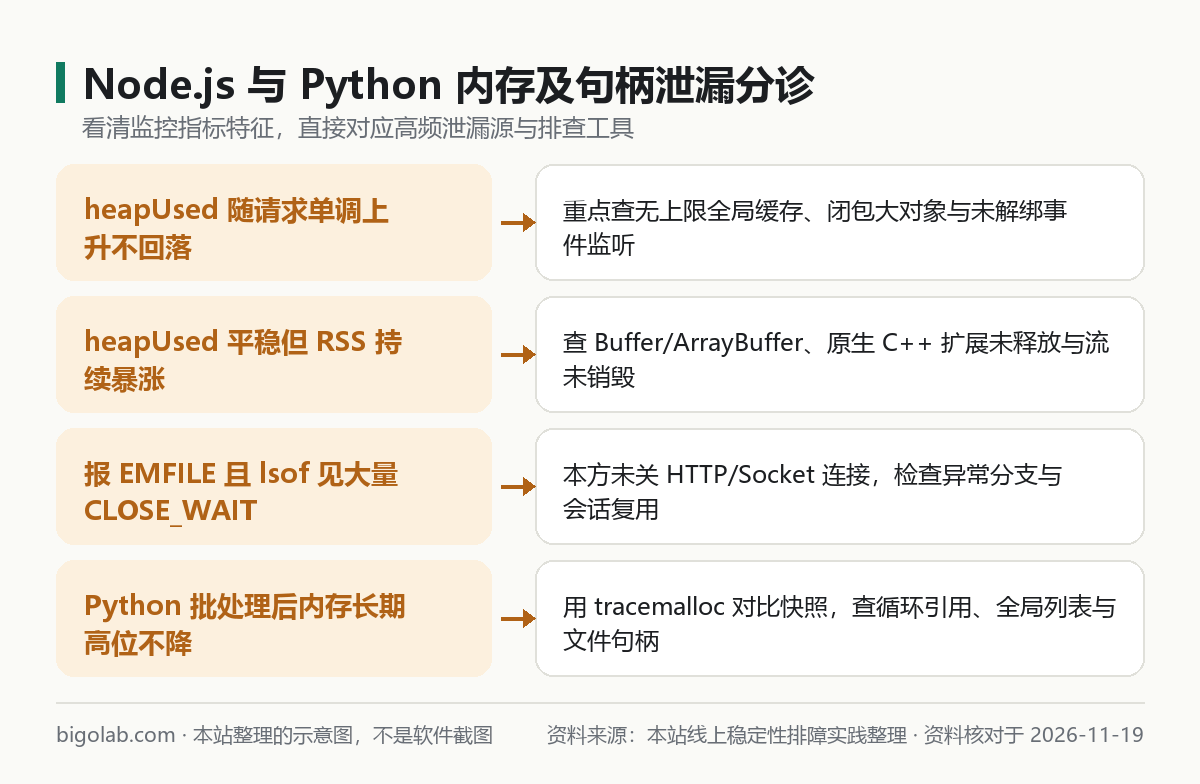
圖:本站結合服務端線上故障排障實踐整理的分診示意圖
二、第二步:只讀投餵增量摘要,讓 Codex 鎖定真實引用鏈
把整理好的差分摘要通過標準輸入管道餵給只讀沙箱裏的 Codex(管道配方參考 /guides/codex-cli-pipe-stdin-exec-recipes),讓它直接結合倉庫源碼追出是誰「攥着對象或句柄不放」:
bash
cat ./leak-diff-summary.txt ./lsof-top20.txt | codex exec \
  --ephemeral \
  --sandbox read-only \
  "這是隔離環境連續請求 500 次後採集的內存增量 Top 15 棧與 lsof 句柄統計,服務線上約 18 小時觸發 OOMKilled。
   請結合倉庫代碼重點檢查:
   1. 哪些全局容器(Map/Set/dict/list)、模組級緩存、事件監聽器(EventEmitter/signal)或閉包持有了請求期對象且缺少淘汰/解綁;
   2. HTTP 客戶端(如 aiohttp ClientSession / requests Session / Node fetch 流)、數據庫連接、文件流或子進程是否存在異常分支漏關閉;
3. 按可能性從高到低列出前 3 個嫌疑文件與精確行號,並說明如何用最小本地復現腳本證實。暫不改代碼。"訂閱與帳號準備提示:疑難內存泄漏往往需要跨幾十個模組追蹤異步回調鏈、中間件上下文與多輪快照對比(省額策略可看 /guides/codex-save-usage-quota-model-reasoning-context-tips)。高頻處理線上性能與穩定性攻堅建議在站內升級 ChatGPT Pro 5x iOS 可覆蓋檔 或 ChatGPT Pro 5x 信用卡不可覆蓋檔;新帳號首次開通 Codex 如卡在手機驗證步驟,可查看 Codex 註冊手機驗證服務。
三、第三步:先寫最小泄漏復現腳本,再定點修復並驗證曲線拉平
切忌看到嫌疑代碼就直接盲改上線。本站建議讓 Codex 按「復現紅燈 → 定點修復 → 曲線拉平」三步走:
- 先寫隔離復現腳本:讓 Codex 寫一個可循環觸發目標邏輯 1000 次的腳本,在循環前後強制執行垃圾回收並打印
heapUsed(Node 需加--expose-gc)或tracemalloc差值與當前打開 FD 數量,確認能穩定復現單調增長。 - 實施最小化釋放修復:例如將無界 Map 換為帶容量上限與 TTL 的 LRU 緩存;確保 Node 響應體流在錯誤分支也被消費或銷燬(
res.resume()/destroy());Python 中將零散創建的ClientSession改為進程級複用並放進async with生命週期管理;移除未配對removeListener的請求級事件綁定。 - 復跑驗證並比對基線:重跑同一份復現腳本(基線對比方法見 /guides/codex-optimize-slow-api-frontend-profiling-baseline),確認經過預熱期後內存與 FD 數維持水平波動不再線性上升,再灰度觀察 24 小時 RSS 趨勢。
常見問題
問:Node.js 裏 heapUsed 一直平穩,為什麼容器總內存 RSS 還是持續暴漲直到 OOM?
答:這說明泄漏發生在 V8 託管堆之外,常見於三類情況:大 Buffer / ArrayBuffer 未釋放、C++ 原生插件(如圖像處理、壓縮、數據庫原生驅動)內存泄漏,或 glibc 內存碎片化。此時單看 V8 堆快照看不出問題,需要重點盯住 process.memoryUsage() 中的 external 與 arrayBuffers 字段,並檢查原生依賴版本與流關閉邏輯。
問:Python 出現大量 CLOSE_WAIT 套接字,通常是服務端還是對端的問題?
答:大量 CLOSE_WAIT 說明對端已經主動關閉了連接,但本方進程沒有調用 close() 釋放套接字。排查重點是檢查發往外部 API、Redis 或數據庫的 HTTP / Socket 封裝,看是否在超時、非 200 狀態碼或解析異常分支裏跳過了關閉邏輯,導致句柄一直懸掛直到觸發 EMFILE。
問:國內沒有外幣信用卡,或者公司研發團隊需要統一採購開具增值稅發票,怎麼開通 ChatGPT / Codex 訂閱?
答:可通過本站 AI 會員充值總覽 按需選購 ChatGPT Plus 充值、ChatGPT Plus 自助卡密 或配額更高的 ChatGPT Pro 充值,支持支付寶、微信支付及 AlipayHK,提供卡密自助兌換(無需交出帳號密碼)與客服協助,並支持開具增值稅發票;多人研發團隊也可諮詢 Business 團隊定製方案。實時價格以商品頁展示為準,售後執行掉訂閱按剩餘天數折退、封號不在質保範圍規則。
相關教學
- 用 Codex 排查線上日誌與 git bisect 定位根因實戰
- 用 Codex 優化慢接口與前端首屏性能:先測 Profiling 基線再驗證收益
- Codex CLI 管道與標準輸入實戰:6 個實用命令配方
- Codex 省額度實戰技巧:模型選擇、推理強度與上下文控制
參考資料
- OpenAI Codex 官方文檔:Codex CLI — https://learn.chatgpt.com/docs/codex/cli
- OpenAI Codex 官方文檔:Non-interactive mode — https://learn.chatgpt.com/docs/non-interactive-mode
- Node.js 官方文檔:Memory Diagnostics — https://nodejs.org/en/learn/diagnostics/memory
- Python 官方標準庫文檔:tracemalloc — https://docs.python.org/3/library/tracemalloc.html
0 條評論
還沒有評論,來搶沙發~