
結論先說
- 不要直接問 Codex「幫我把前端包變小」,先導出真實的打包體積與引用鏈清單。沒有構建 stats(Webpack
stats.json或 Vite / Rollup 產物模組清單),模型只能泛泛建議懶加載,抓不到真正佔體積前 5 的元兇(基線方法可搭配參考 /guides/codex-optimize-slow-api-frontend-profiling-baseline)。 - Tree-shaking 失效八成出在四個硬根因:CommonJS 包、桶文件(Barrel
index.ts)重導出鏈、缺失sideEffects聲明、或 Babel 把 ESM 提前轉成了 CJS。把依賴清單和配置文件餵給 Codex 只讀診斷,幾分鐘就能定位精確觸發點。 - 瘦身順序遵循「剔除誤打入全量依賴 → 路由與重組件按需拆包 → 合理分塊(Vendor Split)」三步走。單變量修改、每次構建都比對 gzip / brotli 後的真實傳輸體積,防止盲目拆出幾十個零碎小 Chunk 反而拖慢 HTTP 加載。
- 改完必須驗證「樣式與副作用未丟失」並設定 CI 體積上限門禁。錯誤標成
sideEffects: false會把全局 CSS 或 Polyfill 誤搖掉,每次改動後都要跑通生產預覽與關鍵路由驗收。 - 在多包前端倉庫裏追蹤跨目錄依賴鏈並反覆驗證多輪構建差異,會持續消耗上下文與周配額。國內沒有外幣卡的開發者可在本站自助開通 ChatGPT Plus 充值 或無 5 小時限額的 ChatGPT Pro 充值,團隊多人前端協作可諮詢 ChatGPT Business 團隊定製。
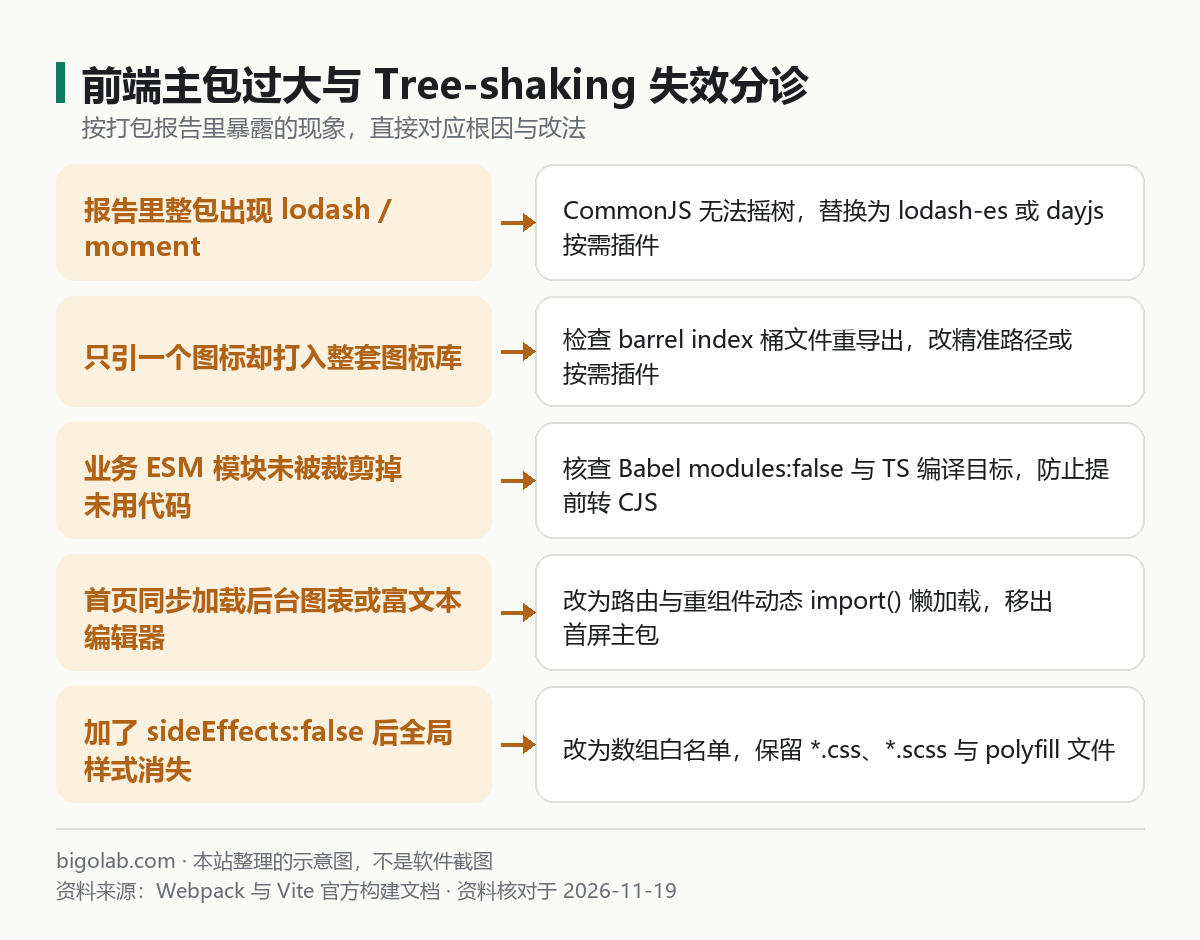
圖:本站根據 Webpack Tree Shaking 文檔 與 Vite 構建指南 整理的診斷示意圖
本文根據 OpenAI Codex 官方文檔《Codex CLI》《Non-interactive mode》、Webpack 官方文檔《Tree Shaking》及 Vite 官方文檔《Building for Production》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 面臨生產構建主入口 JS 超過 1MB、首屏白屏偏久,卻不知道到底是哪個依賴把體積撐爆的前端與全棧工程師;
- 已經把庫換成按需導入,打包報告裏依然看到整包
lodash、圖標庫或圖表庫被完整打進產物的開發者; - 想用 Codex 系統清理 Tree-shaking 失效根因並把體積預算固化到 CI 的前端團隊。
一、第一步:生成精簡版體積與模組引用摘要
直接把動輒十幾兆的完整 stats.json 塞進對話框既浪費額度又會截斷上下文。正確做法是先導出體積排行前 20 的模組與對應 chunk,再用只讀管道餵給 Codex(管道用法參考 /guides/codex-cli-pipe-stdin-exec-recipes):
bash
# Webpack:生成僅包含模組體積與引用原因的 stats.json
npx webpack --mode production --profile --json > stats.json

# Vite:利用 rollup-plugin-visualizer 生成 JSON 報告或直接統計 dist 產物大小
ls -lhS dist/assets/*.js dist/assets/*.css > bundle-sizes.txt
拿到 stats.json 或可視化插件導出的 JSON 後,先用本地小腳本(也可以讓 Codex 寫一行 Node 過濾腳本)只提取體積前 25 的模組路徑及引用方,再跑只讀歸因:
bash
node scripts/top-modules.mjs stats.json | codex exec \
  --ephemeral \
  --sandbox read-only \
  "這是生產構建中體積最大的前 25 個模組及其所屬 Chunk。
   請結合 package.json、vite.config.ts(或 webpack.config.js)、tsconfig.json 與 src/ 路由入口:
   1. 按 gzip 後預計可縮減體積從大到小,列出前 5 個頭號優化項;
   2. 逐項判斷是否命中 Tree-shaking 失效(如 CJS 包、barrel index 導出、Babel modules 配置、sideEffects 缺失或圖標/日期庫全量導入);
   3. 給出最小侵入改動方案與可能破壞 CSS/Polyfill 副作用的風險提示。暫不改代碼。"
二、第二步:對症清理四類高頻「體積殺手」
根據 Codex 輸出的歸因報告,按收益從高到低逐項實施(每次只做一類改動,改完即刻 build 對比體積變化):
1. 替換不可 Tree-shaking 的 CommonJS 巨型依賴
例如舊版 moment(連帶幾十個多語言包)、全量 lodash(而非 lodash-es)或整套圖標全量命名空間導入。提示詞示例:
text
請將倉庫中對 `lodash` 的引用統一替換為 `lodash-es`(或精準單函數導入),並把 `moment` 替換為 `dayjs`(僅按需引入項目實際用到的插件與 zh-cn 語言包)。
要求:
1. 先列出全倉所有引用點與用到的 API 清單;
2. 保證日期格式化、時區與邊界空值行為與原先一致,補齊對應單元測試;
3. 完成後執行生產構建,彙報主包與對應 vendor Chunk 在修改前後的體積對比。
2. 修復 Babel / TS 編譯與 sideEffects 阻斷
- 檢查模組格式:Webpack / Rollup 的 Tree-shaking 依賴原生 ES Modules(
import/export)。讓 Codex 核對babel.config.*中@babel/preset-env是否設定了modules: false,以及tsconfig.json中module是否為ESNext/ES2022,避免在打包器看到代碼前就把 ESM 提前編譯成了require()。 - 精細聲明
sideEffects:對內部 Monorepo 組件庫或工具包,不要粗暴寫"sideEffects": false導致import './index.css'被誤刪,應讓 Codex 掃描所有非純文件後改為精確白名單數組:
json
{
  "sideEffects": [
    "*.css",
    "*.scss",
    "*.less",
    "./src/polyfills.ts"
  ]
}
3. 拆分桶文件(Barrel File)與路由級重型依賴
如果頁面 A 只用到圖表庫裏的折線圖,或者管理後台的富文本編輯器被靜默打進了普通用戶首頁,就讓 Codex 做兩件事:
- 把路由表中的低頻重頁面、導出 Excel、Markdown 編輯器和地圖組件改為動態
import()懶加載; - 在 Vite 的
build.rollupOptions.output.manualChunks(或 Webpackoptimization.splitChunks)中,僅把穩定且跨多頁複用的核心框架與大依賴合理拆塊,避免因為循環依賴把業務代碼和 vendor 攪在一起。
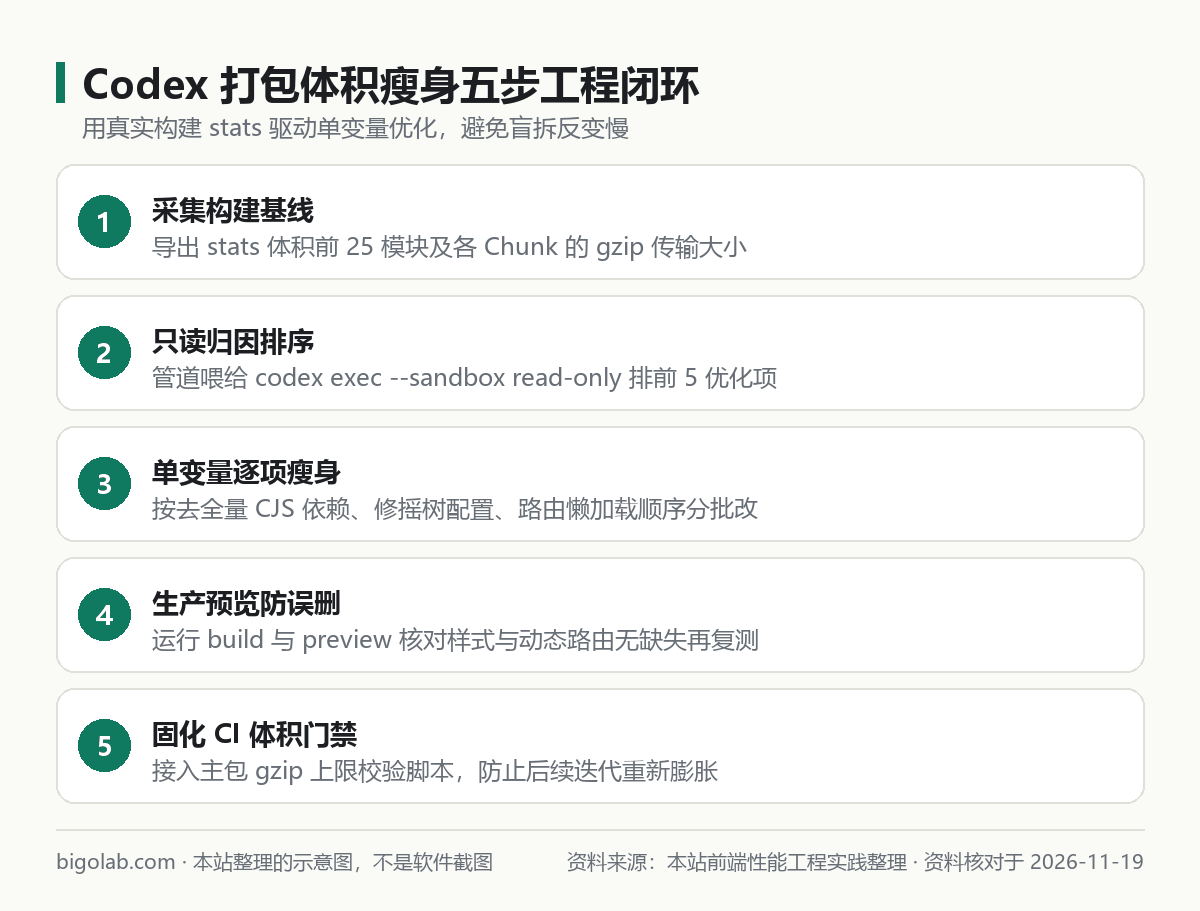
圖:本站結合前端構建工程實踐整理的打包體積優化閉環示意圖
訂閱與帳號準備提示:在多頁面或 Monorepo 倉庫裏排查桶文件傳導引用、批量改寫導入語句並逐輪對比構建產物,容易把 Plus 額度消耗較快(省額方法可看 /guides/codex-save-usage-quota-model-reasoning-context-tips)。前端專項性能優化期建議在站內升級 ChatGPT Pro 5x iOS 可覆蓋檔 或 ChatGPT Pro 5x 信用卡不可覆蓋檔;新帳號首次開通 Codex 如卡在短訊驗證環節,可查看 Codex 註冊手機驗證服務。
三、第三步:驗收防誤刪並把體積預算寫進 CI 門禁
每次體積大幅下降,既可能是優化成功,也可能是某個全局樣式或動態插件被誤搖掉了。本站建議做完瘦身後按兩步收口:
- 跑通生產預覽與代碼預審:本地運行
vite preview(或靜態託管dist)驗證核心頁面樣式、圖標與懶加載路由切換無報錯,再用codex review --base main覆核導入路徑與構建配置改動(審查用法參考 /guides/codex-review-base-uncommitted-custom-focus-guide)。 - 固化體積預算檢查:讓 Codex 寫一段 30 行的構建後體積校驗腳本(或配置
size-limit/ Webpackperformance.maxEntrypointSize)掛進 CI,當主入口 gzip 體積較基線突增超過 10% 時自動預警,防止下一次隨手引入大依賴讓優化前功盡棄。
常見問題
問:為什麼把包拆得很細之後,首屏加載反而更慢了?
答:過度拆包會產生幾十個幾 KB 的零散 Chunk,導致瀏覽器並發請求排隊、解析調度與壓縮字典效率變差。通常只需按「核心框架層 + 大型低頻重依賴 + 路由級異步分包」三層劃分,控制首屏同步加載的關鍵 JS 數量與總 gzip 體積即可。
問:Vite 開發模式(vite dev)一切正常,開啟 sideEffects 或換按需導入後為什麼生產構建才報樣式丟失?
答:因為 Vite 開發環境基於原生 ESM 按需直出,不執行 Rollup 的生產級 Tree-shaking;只有在 vite build 時 Rollup 才會依據 sideEffects 裁剪無顯式引用的導入。所以所有涉及 Tree-shaking 和拆包的改動,都必須以 vite build && vite preview 的生產預覽結果為準。
問:國內沒有外幣信用卡,或者公司研發團隊需要統一採購開具增值稅發票,怎麼開通 ChatGPT / Codex 訂閱?
答:可通過本站 AI 會員充值總覽 按需選購 ChatGPT Plus 充值、ChatGPT Plus 自助卡密 或配額更高的 ChatGPT Pro 充值,支持支付寶、微信支付及 AlipayHK,提供卡密自助兌換(無需交出帳號密碼)與客服協助,並支持開具增值稅發票;多人研發團隊也可諮詢 Business 團隊定製方案。實時價格以商品頁展示為準,售後執行掉訂閱按剩餘天數折退、封號不在質保範圍規則。
相關教學
- 用 Codex 優化慢接口與前端首屏性能:先測 Profiling 基線再驗證收益
- Codex CLI 管道與標準輸入實戰:6 個實用命令配方
- Codex 本地 codex review 進階用法:按 --base、--uncommitted 與自定審查重點
- Codex 省額度實戰技巧:模型選擇、推理強度與上下文控制
參考資料
- OpenAI Codex 官方文檔:Codex CLI — https://learn.chatgpt.com/docs/codex/cli
- OpenAI Codex 官方文檔:Non-interactive mode — https://learn.chatgpt.com/docs/non-interactive-mode
- Webpack 官方文檔:Tree Shaking — https://webpack.js.org/guides/tree-shaking/
- Vite 官方文檔:Building for Production — https://vite.dev/guide/build.html
0 條評論
還沒有評論,來搶沙發~