
結論先說
- 安全第一鐵律:只讀限制必須在「數據庫帳號與引擎層」硬鎖死,絕不能只靠提示詞或 MCP 的只讀參數。早期部分開源數據庫 MCP 實現曾曝出多語句拼接繞過只讀檢查的隱患,只有數據庫角色本身缺乏寫權限,才構成真正的硬防線。
- 嚴禁直連生產主庫,優先連本地脫敏庫、預發庫或只讀從庫。並同時配置語句超時(如
10s)防止一條缺索引的全表掃描打滿數據庫 CPU。 - 憑據一律通過系統環境變量 +
env_vars注入,絕不把密碼明文寫進項目config.toml。詳細config.toml字段與加載層級可參考 /guides/codex-mcp-config 與 /guides/codex-config-toml-complete-guide。 - 讓 Codex 只讀查結構、看執行計劃,但把優化結果輸出成倉庫裏的 SQL 遷移腳本。禁止通過 MCP 直接在線建索引或改表結構,所有 DDL 變更必須走團隊正常代碼審查與發佈流程。
- 連續分析多表 Schema、解讀複雜執行計劃與改寫 ORM 代碼會頻繁佔用上下文額度。國內缺少外幣卡或原套餐限額不足時,可在本站按需開通 ChatGPT Plus 充值 或更高配額的 ChatGPT Pro 充值,團隊協作可了解 ChatGPT Business 團隊定製。
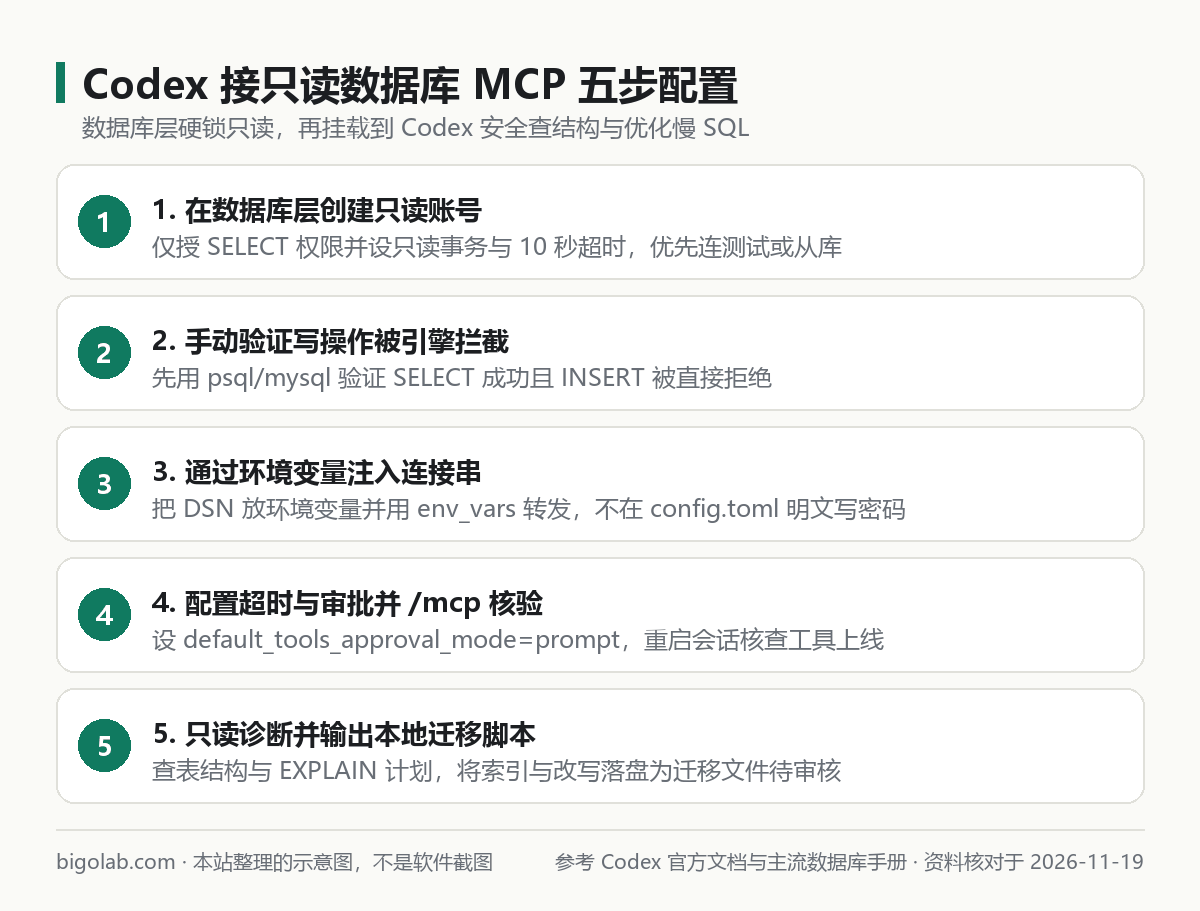
圖:本站根據 OpenAI Codex MCP 文檔 及三款數據庫安全規範整理的示意圖
本文根據 OpenAI Codex 官方文檔《Model Context Protocol》《Configuration Reference》及 PostgreSQL、MySQL、SQLite 官方權限與連接文檔整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 寫複雜聯表查詢或排查慢接口時,需要反覆手動複製
CREATE TABLE、索引定義和執行計劃給 Codex 的後端與數據研發; - 想把 PostgreSQL、MySQL 或本地 SQLite 通過 MCP 接進 Codex,同時死守「絕對不能誤刪改數據、不能拖慢生產主庫」紅線的團隊;
- 擔心在
config.toml裏明文寫死數據庫密碼泄露憑據的開發者。
一、第一步:在數據庫層建立硬只讀帳號(三庫實操)
無論選用哪款活躍維護的開源數據庫 MCP 服務端(注意早期官方示例 @modelcontextprotocol/server-postgres 倉庫已歸檔,建議選用當前持續維護的數據庫 MCP 包或官方兼容發行版),接入前都必須先配好最小權限只讀身份:
1. PostgreSQL:專用只讀角色 + 會話級強保護
sql
CREATE ROLE ai_reader LOGIN PASSWORD 'replace-with-strong-password';
GRANT CONNECT ON DATABASE app_staging TO ai_reader;
GRANT USAGE ON SCHEMA public TO ai_reader;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO ai_reader;
ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO ai_reader;

-- 強制會話預設只讀並限制單條 SQL 最長執行 10 秒
ALTER ROLE ai_reader SET default_transaction_read_only = ON;
ALTER ROLE ai_reader SET statement_timeout = '10s';
ALTER ROLE ai_reader SET idle_in_transaction_session_timeout = '30s';
2. MySQL 8+:僅授予目標庫 SELECT 與查看視圖權限
sql
CREATE USER 'ai_reader'@'127.0.0.1' IDENTIFIED BY 'replace-with-strong-password';
GRANT SELECT, SHOW VIEW ON app_staging.* TO 'ai_reader'@'127.0.0.1';
FLUSH PRIVILEGES;
建議把該帳號指向只讀從庫或獨立測試庫,並在會話或服務端開啟 max_execution_time 超時保護。
3. SQLite:URI 只讀標誌 + 副本隔離
本地排查 SQLite 時,優先拷貝一份快照文件(如 ./tmp/app-readonly.db),連接字符串顯式帶上官方只讀模式參數 file:./tmp/app-readonly.db?mode=ro,並在系統文件權限上設為只讀。
建完帳號後,先用命令行客戶端(psql / mysql / sqlite3)手動驗證一次 SELECT 成功且 INSERT / DELETE 被數據庫拒絕,再進行下一步。
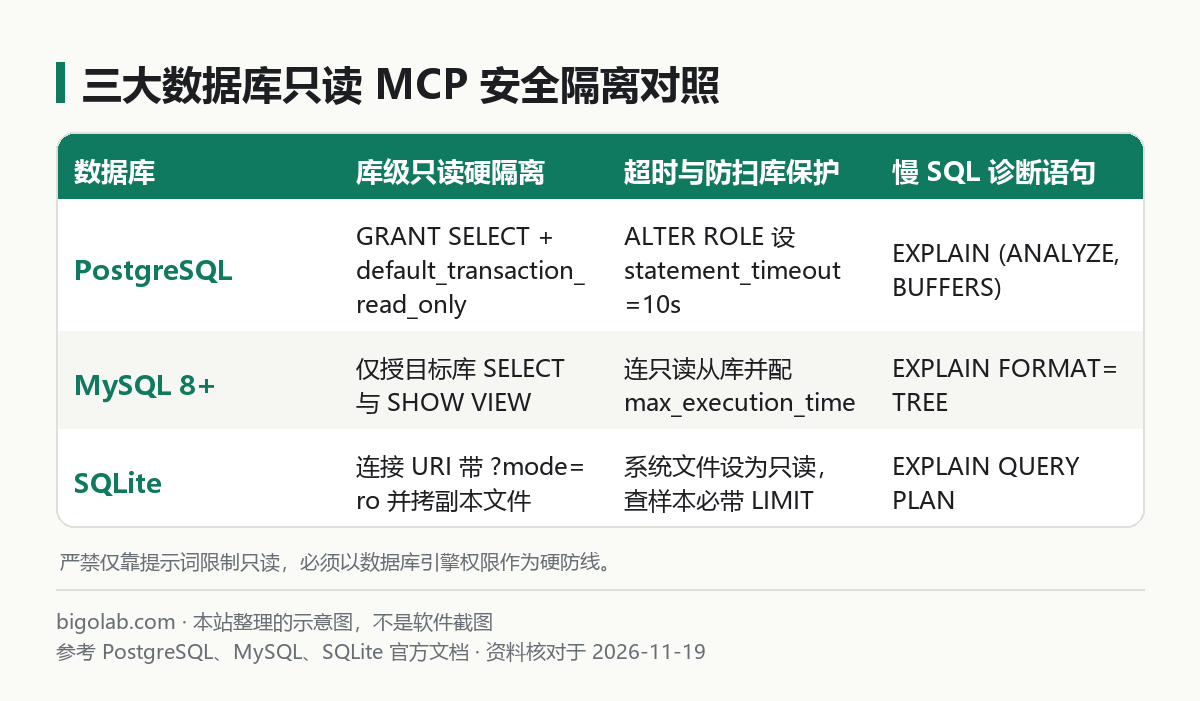
圖:本站根據三款數據庫官方文檔整理的安全配置對比示意圖
二、第二步:在 ~/.codex/config.toml 安全掛載數據庫 MCP
不要把數據庫密碼直接硬編碼在配置裏。先在當前終端導出環境變量(例如 export STAGING_PG_DSN="postgresql://ai_reader:[email protected]:5432/app_staging"),再在 ~/.codex/config.toml 中通過 env_vars 轉發給 MCP 子進程(以支持環境變量讀取連接串的數據庫 MCP 為例,具體包名與參數請以所選維護中項目的最新文檔為準):
toml
[mcp_servers.staging_db]
command = "npx"
args = ["-y", "@bytebase/dbhub", "--transport", "stdio", "--readonly"]
env_vars = ["DSN"]
startup_timeout_sec = 30
tool_timeout_sec = 30
default_tools_approval_mode = "prompt"
enabled = true
啟動 Codex 前將 STAGING_PG_DSN 賦給 DSN 即可,或在只針對個人本機使用的 ~/.codex/config.toml(確保不提交到 Git 且權限僅當前用戶可讀)裏配置獨立隔離的本地測試庫。進入會話後輸入 /mcp,確認只讀查詢與表結構讀取工具已經上線;若連接失敗或報環境變量缺失,可對照 /guides/codex-mcp-connection-failed-no-tools-fix 排查。
訂閱與帳號準備提示:當表數量較多、執行計劃嵌套很深且需要同步重構後端 ORM 代碼時,單次任務會消耗較多配額(額度規則見 /guides/codex-usage-limits)。重度後端與數據調優可在本站升級 ChatGPT Pro 5x iOS 可覆蓋檔 或 ChatGPT Pro 5x 信用卡不可覆蓋檔;新帳號首次開通 Codex 若卡在手機驗證步驟,可查看 Codex 註冊手機驗證服務。
三、第三步:查表結構與慢 SQL 優化的標準提示詞規範
為防止 Codex 順手查出上萬行明文業務數據塞爆上下文或暴露用戶私隱,本站建議在提示詞和 AGENTS.md 中固定三條查詢規矩:先查元數據、抽樣必帶 LIMIT 5、分析走 EXPLAIN 而不拉原始私隱列。
text
請使用 staging_db MCP 排查倉庫 src/repositories/orderRepo.ts 中 listOrdersByMerchant 的慢查詢問題:
1. 先讀取 orders 與 order_items 兩張表的字段定義、現有索引與近似行數(不要拉取用戶手機號、電郵等私隱列);
2. 對該查詢執行只讀 EXPLAIN(PostgreSQL 可用 EXPLAIN (ANALYZE, BUFFERS),MySQL 可用 EXPLAIN FORMAT=TREE,SQLite 可用 EXPLAIN QUERY PLAN),找出全表掃描、回表或排序瓶頸;
3. 結合業務過濾條件和排序字段,給出建議新增的複合索引(含最左前綴列順序說明)與改寫後的 SQL / ORM 代碼;
4. 嚴禁嘗試執行任何建索引或改表語句,請將建議的索引 DDL 寫入本地新遷移文件草案中等待我人工審查。
同時保持 default_tools_approval_mode = "prompt"(工具審批與沙箱邊界見 /guides/codex-permissions-sandbox),每次 Codex 準備發 SQL 前你都能肉眼確認語句安全無越界。
常見問題
問:PostgreSQL 執行 EXPLAIN ANALYZE 會真的把語句跑一遍,會不會有風險?
答:EXPLAIN ANALYZE 確實會實際執行該查詢以統計真實耗時與掃描頁數。如果誤對 UPDATE/DELETE 跑 EXPLAIN ANALYZE 會真的改寫數據——這正是本文強調必須在數據庫層用 default_transaction_read_only = ON 和純 SELECT 帳號硬隔離的原因,即便模型誤寫改數據語句也會被引擎直接攔截,同時 statement_timeout 能防止大查詢長時間佔用資源。
問:為什麼不建議把公司 200 張表的完整 DDL 一次性讓 Codex 全查一遍?
答:一次性拉取上百張表結構會瞬間吃掉大量上下文窗口並消耗高額配額,還會降低模型對關鍵表的注意力。正確方式是先告知 Codex 相關業務模組涉及的 3 到 5 張核心表名,按需查詢目標表及其關聯外鍵表即可。
問:國內沒有外幣信用卡,或後端團隊需要統一採購開具增值稅發票,怎麼開通 ChatGPT / Codex 訂閱?
答:可通過本站 AI 會員充值總覽 按需選購 ChatGPT Plus、ChatGPT Plus 自助卡密 或高配額 ChatGPT Pro,支持支付寶、微信支付及 AlipayHK,提供卡密自助兌換(無需交出帳號密碼)與客服協助,並支持開具增值稅發票;多人研發團隊也可諮詢 Business 團隊定製方案。實時價格以商品頁展示為準,售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍規則。
相關教學
- Codex 怎麼配置 MCP:codex mcp add 命令與 config.toml 寫法
- Codex config.toml 完整詳解:文件層級、常用鍵與 profiles 切換
- Codex MCP 連接失敗或找不到工具怎麼辦:超時與環境變量排查
- Codex 權限與沙箱設定:審批模式與安全邊界
參考資料
- OpenAI Codex 官方文檔:Model Context Protocol — https://learn.chatgpt.com/docs/extend/mcp
- OpenAI Codex 官方文檔:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- PostgreSQL 官方文檔:CREATE ROLE — https://www.postgresql.org/docs/current/sql-createrole.html
- MySQL 8.4 官方文檔:Privileges Provided by MySQL — https://dev.mysql.com/doc/refman/8.4/en/privileges-provided.html
- SQLite 官方文檔:Uniform Resource Identifiers — https://www.sqlite.org/uri.html
0 條評論
還沒有評論,來搶沙發~