
結論先說
- 核心機制是利用 Codex 官方的「分層繼承」加載規則,把
AGENTS.md拆成根目錄 + 子包兩級。Codex 會從 Git 根目錄一路向下讀取到當前工作目錄,把沿途所有AGENTS.md拼接起來,且離當前子目錄越近的規則優先級越高。 - 根目錄
AGENTS.md只寫「全局紅線與倉庫地圖」,嚴禁塞滿細節。控制在精煉篇幅內,只交代包管理器、模組目錄速查表、禁止掃描的生成目錄以及跨包提交約束,避免污染每一個無關子包的上下文。 - 子包
AGENTS.md專門落地「局部構建、局部類型檢查、局部單測命令」。明確禁止在根目錄直接跑全量pnpm test或pytest,強制使用--filter、定向路徑或標籤測試,把反饋閉環從十分鐘壓回十秒內。 - 日常改單一子服務時,用
codex --cd <子目錄>啟動或在提示詞裏鎖定邊界。縮小工作起點不僅能自動命中對應子包規則,還能大幅減少 Codex 漫無目的地全倉亂掃。 - 在大型 Monorepo 中做跨包重構和自動化驗證,對額度裕度與團隊協作要求更高。個人重度開發推薦直接開通高配額 ChatGPT Pro,常規起步可選 ChatGPT Plus,研發團隊統一席位管理可了解 ChatGPT Business 團隊定製。
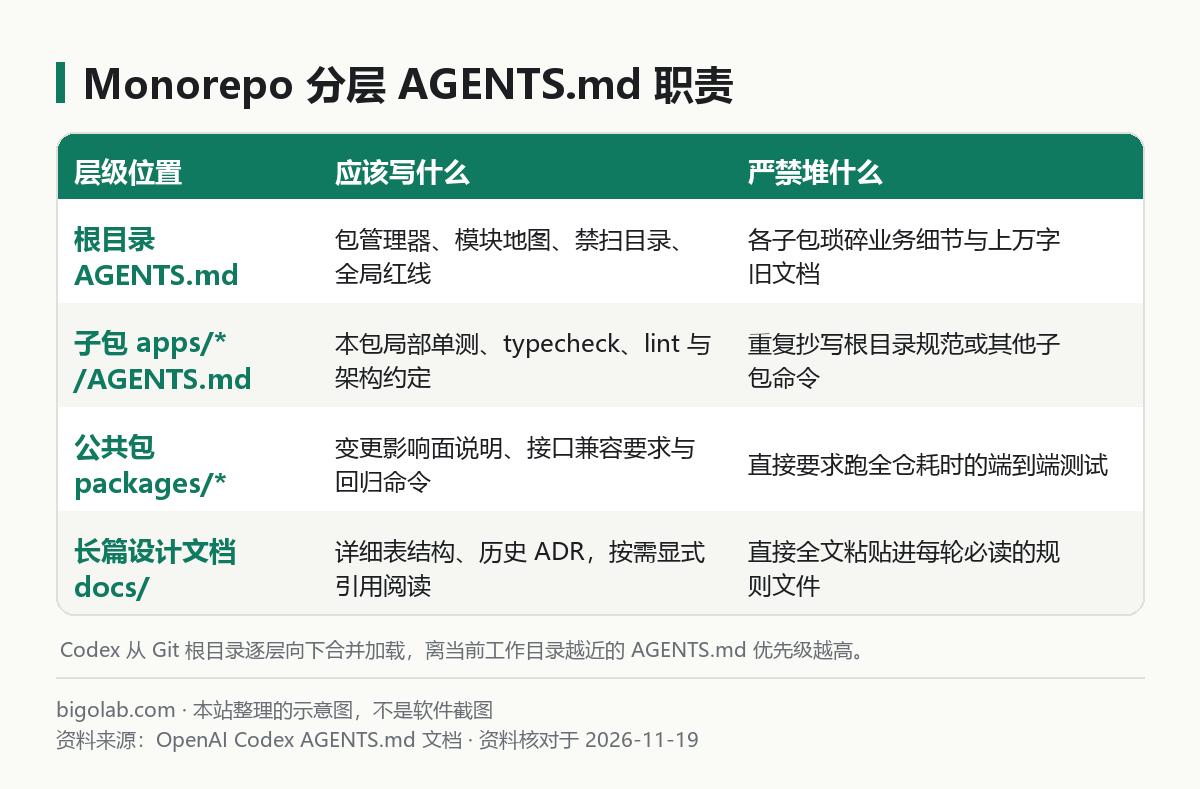
圖:本站根據 OpenAI Codex 官方文檔:AGENTS.md 與多包倉庫規範整理的示意圖
本文根據 OpenAI Codex 官方文檔《AGENTS.md》《Codex CLI》《Configuration Reference》《Codex environments》及大型倉庫工程實踐整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 在包含多個前端應用、後端微服務和共享組件庫的大型 Monorepo(如
pnpm workspaces、Turborepo、Nx、Go/Python 多模組倉)裏接入 Codex 的工程師; - 讓 Codex 改一個子模組,它卻動不動全倉
find/grep、跑長達十幾分鐘的根級測試,或者把無關子包的構建產物讀進上下文導致慢且費額度的團隊; - 想設計一套清晰、可維護的分層
AGENTS.md規範,讓每位團隊成員開箱即用的架構師或 Tech Lead。
一、為什麼 Monorepo 不能只靠一份巨型根目錄 AGENTS.md
不少團隊剛開始接 Codex 時,習慣把前端 React 規範、後端 Go 微服務部署、Python 數據腳本和數據庫遷移文檔全堆進倉庫根目錄的一份 AGENTS.md。結果很快出現三大副作用:
- 上下文信噪比暴跌:你只是想改
apps/admin的一個表格篩選,Codex 每次開局卻被迫吞下幾千字 Go 支付服務的架構規則,既浪費 Token 額度又容易注意力分散。 - 規則互相打架:A 子包用 Vitest,B 子包用 Jest,C 子服務用 Pytest;全揉在一張文件裏,模型極易張冠李戴跑錯測試框架。
- 動輒觸發全倉掃描與全量構建:沒有給清晰的倉庫目錄索引和忽略清單,Codex 為了找一個類型定義,可能會掃遍
dist/、storybook-static/、自動生成的 GraphQL/Protobuf 產物和上千個歷史 fixture 文件。
關於 Codex 查找併合並多層規則文件的底層順序,可搭配閱讀 /guides/codex-agents-md-how-it-reads 和 /guides/codex-onboard-unfamiliar-project-agents-md。
二、大型 Monorepo 接入 Codex 的 5 步標準配法
以下為本站建議的 5 步落地架構,適用於前後端一體或微服務 Monorepo:
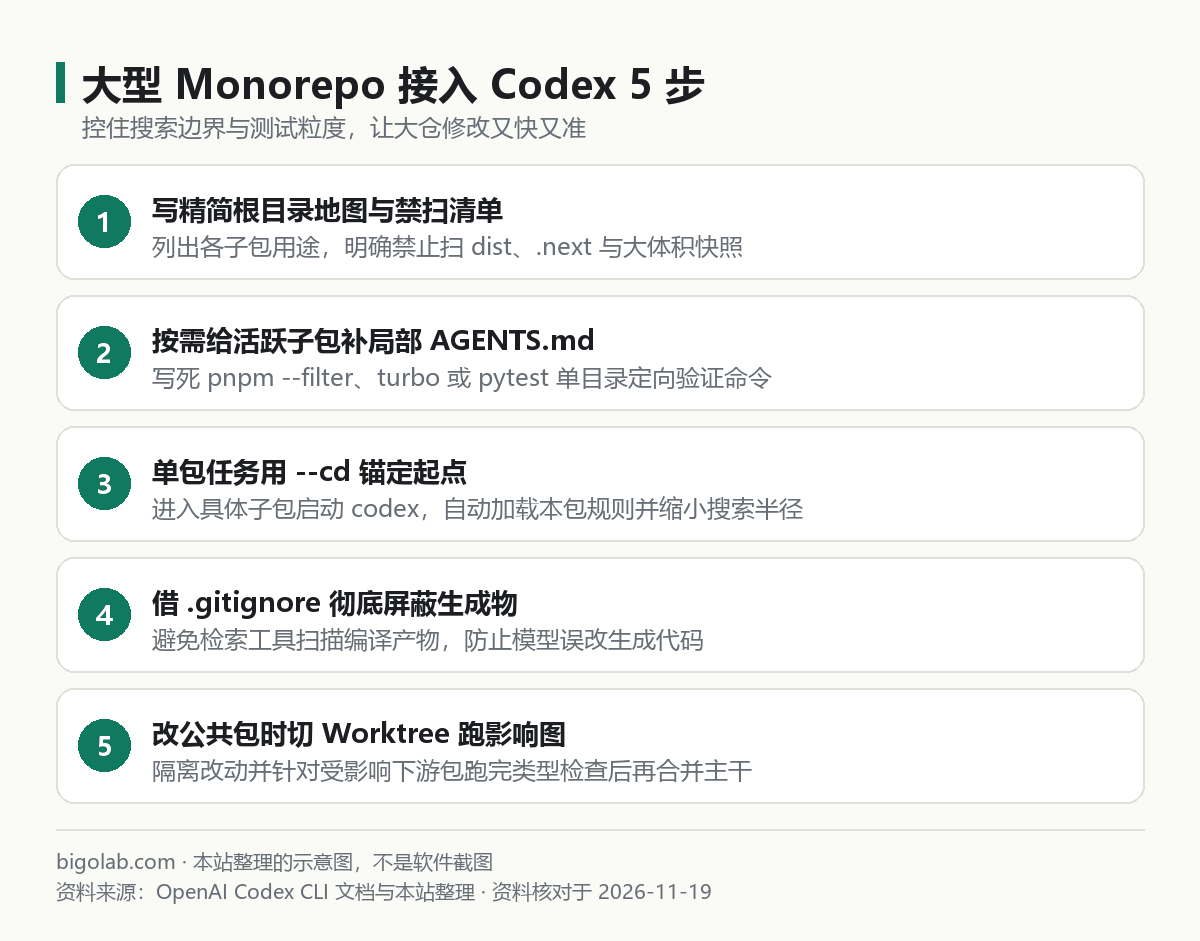
圖:本站根據 OpenAI Codex 官方文檔:Codex CLI 與 Monorepo 實踐整理的示意圖
第 1 步:編寫精簡的根目錄 AGENTS.md(目錄地圖 + 防掃紅線)
把根目錄 AGENTS.md 控制在 1 屏左右,重點給 Codex 一張「導航圖」和「禁行清單」:
markdown
# Monorepo 全局開發規則

## 倉庫目錄地圖(先看地圖再搜尋,不要盲目全倉遞歸)
- `apps/web`: Next.js 用戶端前台
- `apps/admin`: 管理後台(React + Vite)
- `services/billing`: Python FastAPI 計費服務
- `packages/shared-types`: 前後端共享類型與 OpenAPI 產物
- `packages/ui`: 公共組件庫

## 全局約束與禁掃目錄
- Node 依賴統一使用 `pnpm`,嚴禁運行 `npm install` 或 `yarn`。
- 禁止讀取或全局搜尋以下生成與大體積目錄:`dist/`、`.next/`、`.turbo/`、`coverage/`、`**/__snapshots__/`、`testdata/large-dumps/`。
- 禁止在倉庫根目錄直接執行全量 `pnpm test`;必須先進入子包或加 `--filter` 局部運行。
- 修改 `packages/*` 公共包前,必須先列出受影響的下游應用並獲得確認。
第 2 步:為每個活躍子包維護獨立的局部 AGENTS.md
在各自子目錄放置精簡專屬規則,例如 apps/web/AGENTS.md:
markdown
# apps/web 局部規則

## 局部驗證命令(改完必須先跑單文件,再跑本包檢查)
- 單文件測試:`pnpm --filter @acme/web test -- <測試文件路徑>`
- 本包類型檢查:`pnpm --filter @acme/web typecheck`
- 本包 Lint:`pnpm --filter @acme/web lint`

## 模組約定
- 接口請求統一複用 `src/lib/api-client.ts`,禁止在組件裏手寫裸 `fetch`。
- 新增路由頁面放在 `src/app/`,公共 Hook 放在 `src/hooks/`。
同理,在 services/billing/AGENTS.md 中則寫明使用 ./.venv/bin/pytest services/billing/tests/<file>.py -q 與 ruff check services/billing。當你在該子目錄下啟動 Codex 時,它會自動同時繼承根目錄紅線和當前子包的局部命令。
第 3 步:按任務粒度選擇 codex --cd 起點(本站建議)
- 單包需求(佔日常 80% 工作量):直接定位到子目錄啟動,如
codex --cd apps/web或在子目錄內運行codex。Codex 天然把探索起點錨定在該包內,只會按需讀取被引用的packages/shared-types。 - 跨包聯動需求:從倉庫根目錄啟動,但在首句提示詞裏顯式圈定本次允許讀寫的 2 至 3 個目錄,禁止越界修改其他子包。
第 4 步:把構建緩存與生成文件徹底擋在搜尋之外
除了在 AGENTS.md 裏口頭提醒,更要在工程基礎設施層配合 .gitignore(多數高速搜尋工具如 rg 會預設遵循 .gitignore)。把自動生成的 SDK、編譯產物、大號 SQL 種子文件與日誌目錄正確加入忽略規則,既能提速搜尋,也能防止 Codex 錯把編譯後的 dist/*.js 當源碼去改。
第 5 步:改動公共底層包時用 Worktree 隔離驗證
在 Monorepo 中修改 packages/shared-types 或 packages/ui 這類被十幾個應用共同依賴的核心包時,風險遠高於改業務頁面。建議在桌面端選 Worktree 模式或命令行建獨立 Git Worktree 開展重構,跑通 turbo run typecheck --filter=...[HEAD^1] 這類受影響子圖檢查後再合併主幹。配置參數與權限邊界可聯動參考 /guides/codex-config-toml-complete-guide 與 /guides/codex-permissions-sandbox。
排障與訂閱提示:大型 Monorepo 即使做足了分層裁剪,跨包類型檢查和多輪驗證的 Token 吞吐量依然明顯高於單倉小項目。需要充沛配額保障可按需選擇 ChatGPT Pro 20x iOS 可覆蓋檔;企業技術團隊統一採購席位可看 ChatGPT Business 團隊定製,新帳號手機驗證受阻可參考 Codex 註冊手機驗證服務。
三、大型倉常見踩坑與排查要點
- 寫了子目錄
AGENTS.md卻感覺沒生效:核對兩件事——一是你是否是從倉庫根目錄啟動且工作目錄未切到子包(根啟動時某些場景要等到實際操作或切換進入子目錄才會讀取下層規則);二是檢查父級是否存在高優先級的覆蓋文件(如AGENTS.override.md)覆蓋了同名約定。 - 改完公共包,本包測試過了但 CI 全倉掛了:局部測試用於日常秒級開發閉環;臨近提交 PR 前,建議讓 Codex 跑一次受影響下游包的類型檢查(例如 Turborepo 的
--filter=...^或 Nx 的affected命令),把迴歸攔截在提交之前。
常見問題
問:倉庫裏已經有 30 個子包,需要一口氣寫完 30 份 AGENTS.md 嗎?
答:完全不需要。建議採用「按需漸進」策略:先花 15 分鐘寫好根目錄的倉庫地圖和全局紅線,再優先給最常迭代的 2 到 3 個核心子包補上局部 AGENTS.md,其餘冷門子包等真正要大改時再順手補齊,維護成本最低。
問:根目錄 AGENTS.md 寫太長到底有多大影響?
答:根目錄規則文件會疊加到該倉內幾乎每一次 Codex 會話的初始上下文裏。文件過長不僅持續放大額度消耗,還會稀釋真正關鍵的局部命令和禁令。建議根目錄不超過 80 到 120 行,把長篇設計文檔拆成獨立 Markdown 放進 docs/,只在規則裏寫「做某類改動時再去按需閱讀對應文檔」。
問:國內沒有外幣卡,或者研發團隊需要集中採購 Pro / 團隊版並開具發票,怎麼辦理?
答:可前往本站 AI 會員充值總覽 按需選購 ChatGPT Plus(含 Plus iOS 可覆蓋版)或高配額 ChatGPT Pro,團隊多人研發亦可選擇企業定製方案。支持支付寶、微信支付及 AlipayHK,提供免交密碼卡密自助兌換與增值稅發票服務,價格以商品頁實時展示為準;售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍的說明。
相關教學
參考資料
- OpenAI ChatGPT Learn:AGENTS.md — https://learn.chatgpt.com/docs/agent-configuration/agents-md
- OpenAI Codex 官方文檔:Codex CLI — https://developers.openai.com/codex/cli
- OpenAI ChatGPT Learn:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- OpenAI ChatGPT Learn:Codex environments — https://learn.chatgpt.com/docs/environments/modes
- OpenAI Codex 官方 GitHub 倉庫 — https://github.com/openai/codex
0 條評論
還沒有評論,來搶沙發~