
結論先說
- Predicted Outputs 通過傳入已知原文草稿大幅縮短輸出等待時間。當模型最終輸出有七八成以上內容與輸入草稿一致時,在請求中附帶
prediction參數可讓服務端並行驗證匹配片段,顯著降低首字與總響應延遲。 - 僅適合「大段保留、局部微調」場景,不適合重寫或從零生成。如果模型實際輸出推翻了大部分預測文本,不僅無法提速,還會產生額外帳單。
- 被拒絕的預測 Token 同樣按輸出單價收費。響應裏的
usage.completion_tokens_details會披露accepted_prediction_tokens與rejected_prediction_tokens,後者會計入計費總額。 - 存在明確的參數互斥邊界。開啟
prediction時不能同時掛載函數調用(tools)、不能開啟音頻輸出、n不能大於 1,也不能把presence_penalty或frequency_penalty設為正數。 - 開發調試之餘若需直接使用官方客戶端交互改代碼,國內缺少境外信用卡的用戶可在本站自助開通 ChatGPT Plus 或高配額 ChatGPT Pro,團隊協作可了解 ChatGPT Business 團隊定製。
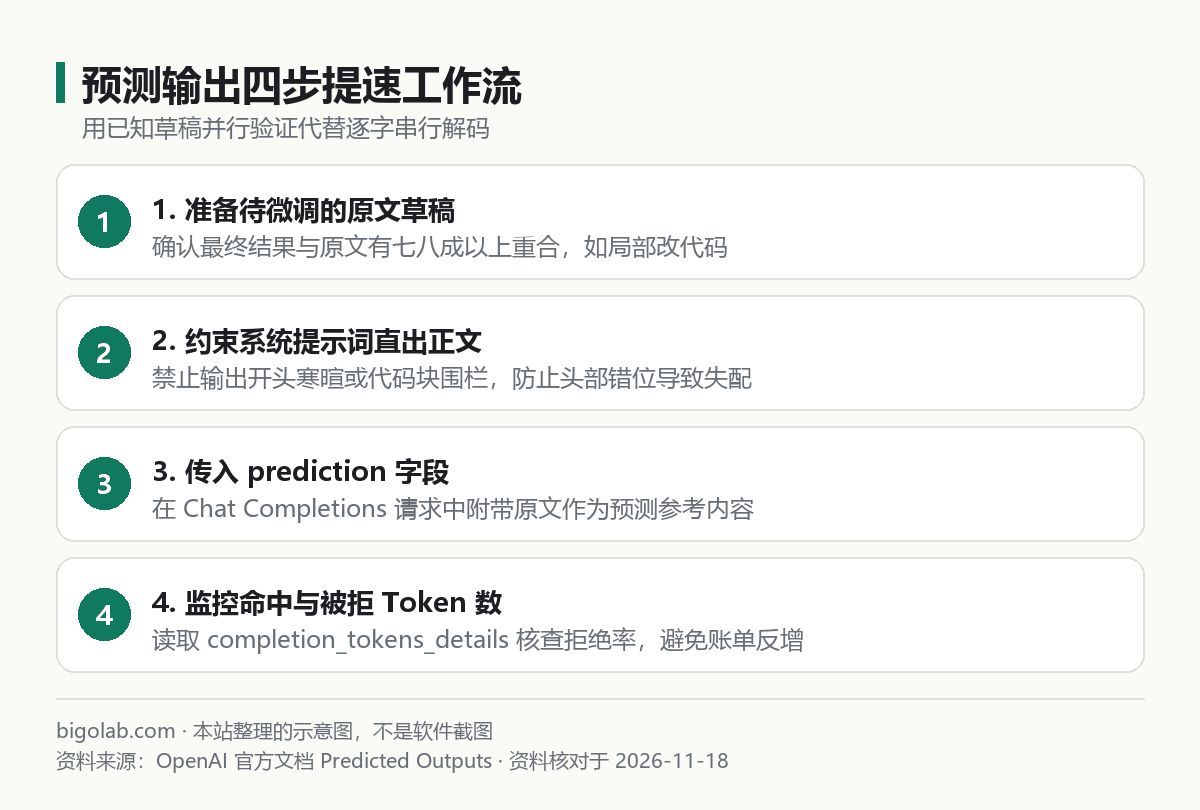
圖:本站根據 OpenAI 官方文檔:Predicted Outputs 整理的示意圖
本文根據 OpenAI API 官方文檔《Predicted Outputs》《Chat Completions API Reference》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 開發 AI 代碼編輯器、「一鍵應用修改(Apply)」或公文微調功能,需要把幾百行舊文件改幾行後完整返回,但嫌預設逐字生成太慢的開發者;
- 想搞懂
prediction參數為什麼能提速、又在什麼情況下反而會多扣 Token 費用的工程負責人; - 調用接口傳入
prediction後遇到 400 參數衝突報錯的排查者。
一、工作原理與 Python 調用代碼示例
在傳統代碼重構調用中,即便 300 行文件只改 2 行變量名,模型仍需從第 1 行串行解碼到第 300 行。按官方《Predicted Outputs》文檔,在 Chat Completions 接口(與新版接口關係見 /guides/openai-responses-api)中把原文件全文傳給 prediction 字段即可啟用投機解碼加速:
python
from openai import OpenAI

client = OpenAI()

original_code = """class OrderService:
    def __init__(self, repo):
        self.repo = repo

    def find_by_uid(self, uid: str):
        return self.repo.get(uid)
"""

prompt = "把方法名 find_by_uid 改為 get_order_by_id,其餘邏輯與格式保持原樣,只返回完整代碼正文不要包裹代碼塊圍欄。"

resp = client.chat.completions.create(
    model="gpt-4o",
    messages=[
        dict(role="user", content=prompt),
        dict(role="user", content=original_code),
    ],
    prediction=dict(type="content", content=original_code),
)

print(resp.choices[0].message.content)
details = resp.usage.completion_tokens_details
print("命中預測 Token:", details.accepted_prediction_tokens)
print("拒絕預測 Token:", details.rejected_prediction_tokens)配合流式輸出(stream=True,寫法見 /guides/openai-api-streaming)時,前端打字機渲染會出現明顯的成片躍進效果。注意提示詞中應明確要求「只輸出修改後的完整文件內容,不要添加寒暄解釋和 Markdown 代碼塊圍欄」,否則開頭多出的閒聊文字會導致整段預測錯位失效。
訂閱與帳號準備提示:若你不做底層 API 二次開發,只希望在本地倉庫直接享受低延遲自動改文件體驗,開通訂閱直接使用 Codex CLI 更省心。國內用戶可在本站選購 ChatGPT Plus 會員 或升級 ChatGPT Pro 充值,支持免交密碼自助兌換。
二、計費帳本與適用邊界決策
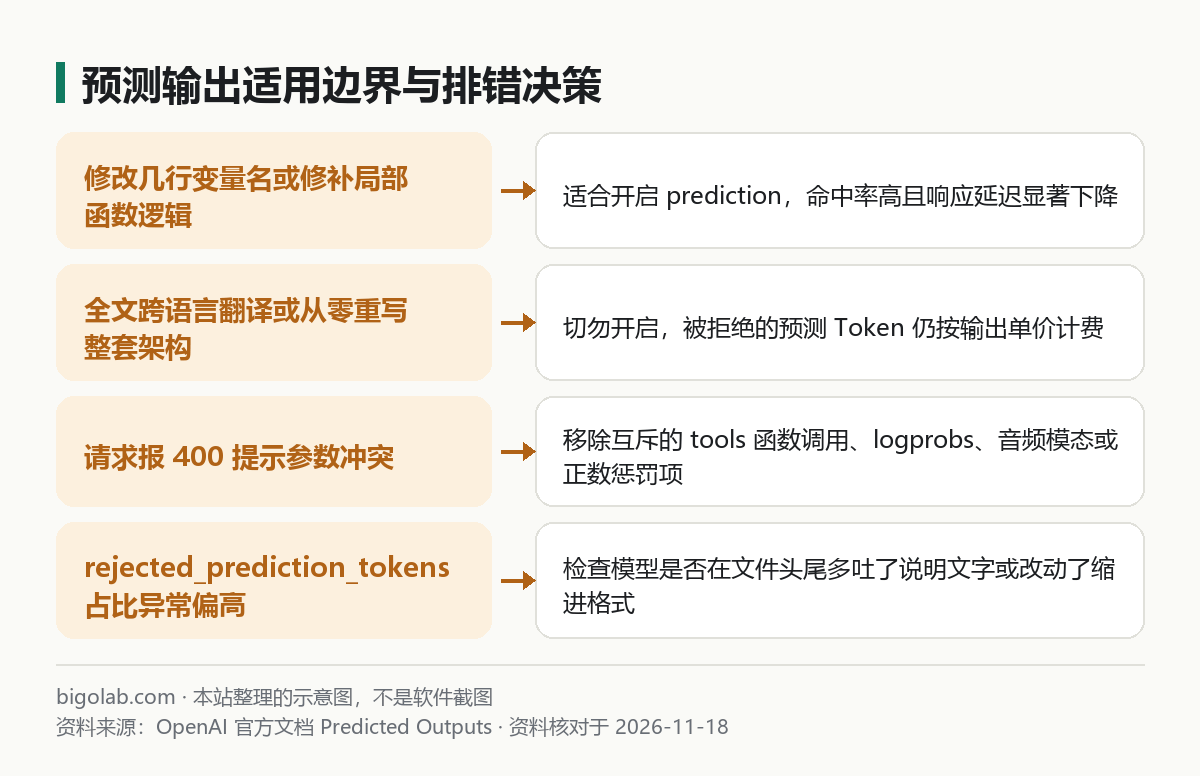
圖:本站根據 OpenAI 官方文檔:Predicted Outputs 整理的示意圖
上線前務必在監控日誌裏核查拒絕率(價格表見 /guides/openai-api-price-official-table),按以下四條規則取捨:
| 檢查維度 | 官方規則與工程影響 | 實操應對建議 |
|---|---|---|
| 改動幅度 | 改動越小,命中率越高、加速越顯著;大幅改寫會導致大量預測被拒並計費 | 僅用於局部補丁應用、拼寫修正、字段重命名,全文翻譯或重寫切勿開啟 |
| 開頭多餘文本 | 模型若先輸出一句「好的,修改如下:」,後續預測更容易失配 | 系統提示詞寫死直接以原文件首行開頭返回,不輸出解釋 |
| 工具調用衝突 | 與 tools / tool_choice 同時傳會直接報 400 錯誤 | 先在上一輪用函數調用(見 /guides/openai-api-function-calling)定好修改方案,最後一輪落盤改寫再單獨帶 prediction |
| 模型支持範圍 | 面向非推理型主力對話模型開放(如 gpt-4o、gpt-4.1 系列),推理模型不支持 | 切換模型前先查官方文檔的支持表 |
常見問題
問:為什麼我加了 prediction 後,帳單上的 completion_tokens 反而比實際字數多出一截?
答:因為模型在驗證草稿時推翻了部分不匹配的預測片段,這部分 rejected_prediction_tokens 同樣計入輸出用量。檢查提示詞是否導致模型在頭部多吐了說明文字或改動了縮進風格。
問:只讓模型返回 Unified Diff 補丁不是比傳全文加 prediction 更省錢嗎?
答:純算 Token 數確實 Diff 更少,但通用模型手寫行號偏移的 Diff 容易貼片失敗;「全文返回 + prediction」以接近普通生成的費用換取了零貼片報錯和極低延遲,是很多 IDE「快速應用修改」層的常用折中方案。
問:國內沒有外幣卡,或者公司財務要求開具增值稅發票,怎麼訂閱官方會員輔助研發?
答:可通過本站 AI 會員充值總覽 選購 ChatGPT Plus 或 ChatGPT Pro,支持支付寶、微信支付及 AlipayHK 結算,提供卡密自助兌換與企業定製,並支持開具增值稅發票。實時價格以頁面顯示為準;售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍的規則。
相關教學
- OpenAI API 流式輸出(streaming)怎麼寫
- OpenAI API 函數調用(function calling)怎麼寫
- OpenAI API 價格表與計費說明
- OpenAI Responses API 與 Chat Completions 區別
參考資料
- OpenAI API 官方文檔:Predicted Outputs — https://platform.openai.com/docs/guides/predicted-outputs
- OpenAI API 官方文檔:Chat Completions Reference — https://platform.openai.com/docs/api-reference/chat/create
0 條評論
還沒有評論,來搶沙發~