
結論先說
- Responses API 通過
reasoning對象統一控制思考深度與摘要。核心字段為effort(常用low、medium、high,預設medium)與summary(可選auto、concise、detailed)。 - 內部推理 Token 不直接暴露原文,但按輸出 Token 單價計費。可在返回結果的
usage.output_tokens_details.reasoning_tokens中精確查看本輪消耗的思考量。 max_output_tokens管的是「推理 + 可見回答」的總和。若上限設得太小,模型在內部思考階段就會耗光配額,導致可見文本為空且status變為incomplete。- 獲取
summary思考摘要無需額外付費。但部分前沿推理模型要求先在 OpenAI Platform 後台完成組織身份驗證(Organization Verification)才能開啟摘要返回。 - 想免寫代碼直接交互體驗高階推理模型,國內無外幣卡用戶可在本站自助開通 ChatGPT Plus 或高配額 ChatGPT Pro,企業研發團隊可了解 ChatGPT Business 團隊定製。
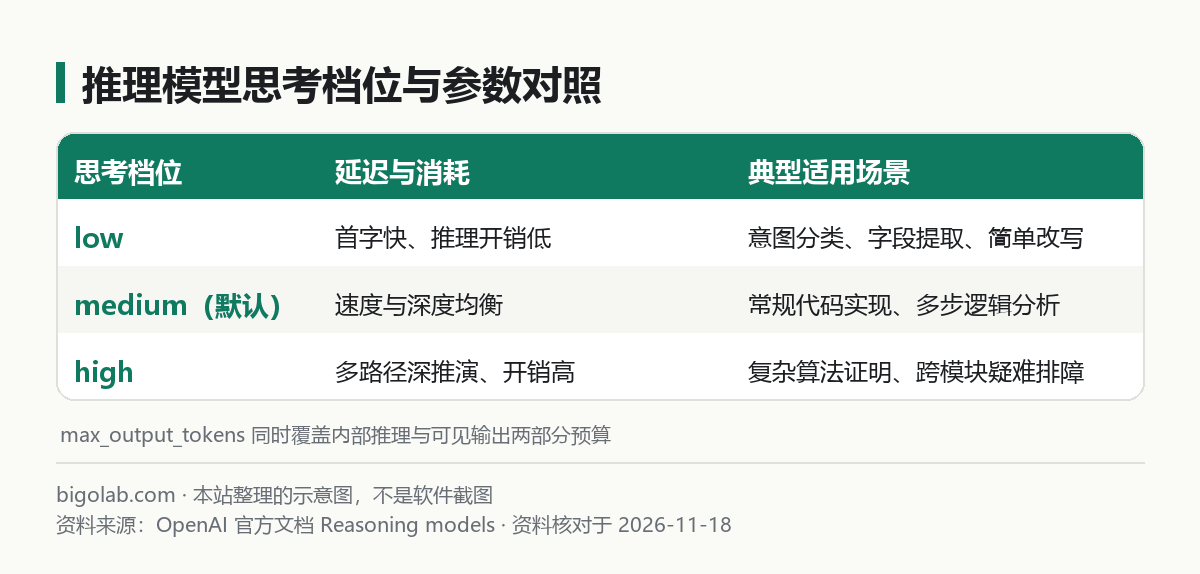
圖:本站根據 OpenAI 官方文檔:Reasoning models 整理的示意圖
本文根據 OpenAI API 官方文檔《Reasoning models》《Responses API Reference》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 在代碼裏調用 OpenAI 推理模型,想按任務難度平衡延遲、準確度與 Token 帳單的開發者;
- 希望在前端介面展示模型「正在思考什麼」,需要拉取
reasoning.summary思考摘要的人; - 遇到 API 返回 HTTP 200 但正文為空、
status顯示incomplete的排查者。
一、effort 思考強度檔位與兩套接口寫法
OpenAI 新版開發首選 Responses API(與舊接口差異見 /guides/openai-responses-api)。effort 各檔位定位如下:
| 檔位取值 | 思考深度與耗時 | 適用任務場景 |
|---|---|---|
low | 簡短推理,首字響應快、消耗少 | 意圖路由、結構化抽取、明確語法改寫 |
medium(預設) | 速度與深度均衡 | 常規業務代碼編寫、多步邏輯問答、文檔審查 |
high | 深度多路徑推演,推理 Token 佔比高 | 複雜算法證明、跨模組疑難排障、架構方案設計 |
注:部分新版 GPT 系列模型還支持更輕量的檔位(以具體模型參考頁為準);在交互終端 Codex CLI 裏切換同款思考強度的做法見 /guides/codex-switch-model-reasoning-effort。若仍在維護舊版 Chat Completions 接口,對應頂層參數名為 reasoning_effort="medium"。
二、調用示例:同時讀取思考摘要與正文並防截斷
下面用官方 Python SDK 演示傳入 reasoning 參數、預留 max_output_tokens 預算,並檢查 incomplete 狀態:
python
from openai import OpenAI

client = OpenAI()

resp = client.responses.create(
    model="o4-mini",
    input="請排查高並發下數據庫連接池耗盡的三類常見根因,並給出連接超時配置建議。",
    reasoning=dict(effort="medium", summary="auto"),
    max_output_tokens=16000,
)

if resp.status == "incomplete":
    print("輸出被截斷,原因:", resp.incomplete_details.reason)

for item in resp.output:
    if item.type == "reasoning":
        for s in item.summary:
            print("[思考摘要]", s.text)

print("[正式回答]\n", resp.output_text)
print("推理消耗 Token:", resp.usage.output_tokens_details.reasoning_tokens)流式傳輸(stream=True)時,同樣可以監聽摘要增量與正文增量事件,流式基礎寫法參考 /guides/openai-api-streaming。
訂閱與帳號準備提示:調試複雜推理提示詞前,很多開發者會先在網頁端或 Codex 裏對比不同思考檔位的效果。若缺少境外支付卡,可在本站自助選購 ChatGPT Plus 會員 或大額度的 ChatGPT Pro 充值,免交帳號密碼即可完成卡密兌換。
三、輸出為空或半截中斷的排錯決策
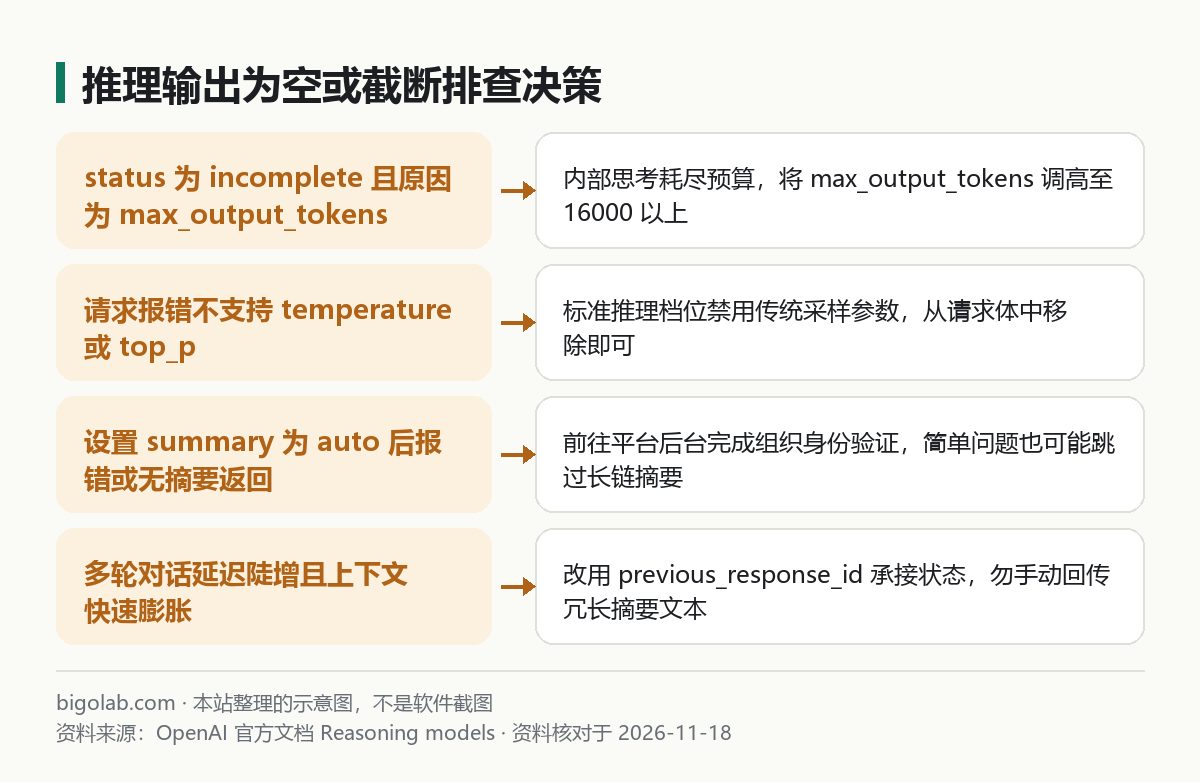
圖:本站根據 OpenAI 官方文檔:Reasoning models 整理的示意圖
resp.output_text為空字符串且status == "incomplete":查看resp.incomplete_details.reason,若為max_output_tokens,說明你把上限(例如1024)設得太低,全被內部推理吃掉了。官方建議調試期預留至少16000至25000的上限,沒用完的額度不會扣費(計費標準見 /guides/openai-api-price-official-table)。- 傳了
temperature或top_p報 400 錯誤:標準推理模型(或在非零推理檔位下)固定不支持採樣溫度、presence_penalty等傳統採樣參數,刪掉即可恢復正常。 - 請求
summary="auto"報權限錯誤或返回空數組:登入 OpenAI Platform 進入組織設定(Settings > Organization > General)核查是否已完成組織認證;極簡問題未觸發長鏈思考時,summary數組也可能為空。 - 流式渲染時首字等待偏久:高檔位(
high)推理可能需要十餘秒才開始吐出第一段正文。若產品介面對白屏敏感,建議開啟summary="auto"並監聽流式推理摘要增量事件,先把階段性思考摘要實時呈現在摺疊面板裏,能明顯改善用戶等待體驗。 - 批量離線任務優先搭配緩存與批處理:推理模型同樣享受輸入提示詞緩存(Prompt Caching)與 Batch API 折扣,固定不變的系統規則與參考資料應放在輸入最前端以提高緩存命中率。
常見問題
問:把 max_output_tokens 設成 25000 會不會每次都按兩萬五千個 Token 扣錢?
答:不會。max_output_tokens 只是安全上限剎車,實際帳單只按本輪真實生成的「推理 Token + 可見輸出 Token」數量結算。
問:多輪對話時要不要把上一輪的思考摘要拼回 input 傳給下一輪?
答:不需要手動拼摘要文本。使用 Responses API 時直接傳入 previous_response_id=resp.id,服務端會自動承接上下文與必要的推理狀態。
問:國內沒有外幣卡,或者公司需要開增值稅發票報銷,怎麼開通 ChatGPT 會員配合開發?
答:可通過本站 AI 會員充值總覽 選購 ChatGPT Plus 或 ChatGPT Pro,支持支付寶、微信支付與 AlipayHK,支持卡密自助兌換與企業定製,並可開具增值稅發票。實時價格以頁面顯示為準;售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍的規則。
相關教學
- OpenAI Responses API 是什麼:和 Chat Completions 的區別
- OpenAI API 價格表與長上下文計費說明
- OpenAI API 流式輸出(streaming)怎麼寫
- Codex 怎麼切換模型和思考強度
參考資料
- OpenAI API 官方文檔:Reasoning models — https://platform.openai.com/docs/guides/reasoning
- OpenAI API 官方文檔:Responses API Reference — https://platform.openai.com/docs/api-reference/responses
0 條評論
還沒有評論,來搶沙發~