
在讀完 promptfoo 基礎安裝與對比提示詞入門教學 之後,把這套工具真正用進企業級知識庫(如 RAGFlow 知識庫)或智能體生產項目,最核心的價值不再是人工打開網頁看哪段話寫得順眼,而是把它變成跟後端單元測試一模一樣的自動化迴歸防線——每次有人提交代碼改了提示詞模板、換了切片長度或升級了底座模型,自動跑一遍黃金題庫,只要幻覺率抬頭就當場攔下合併請求(PR)。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
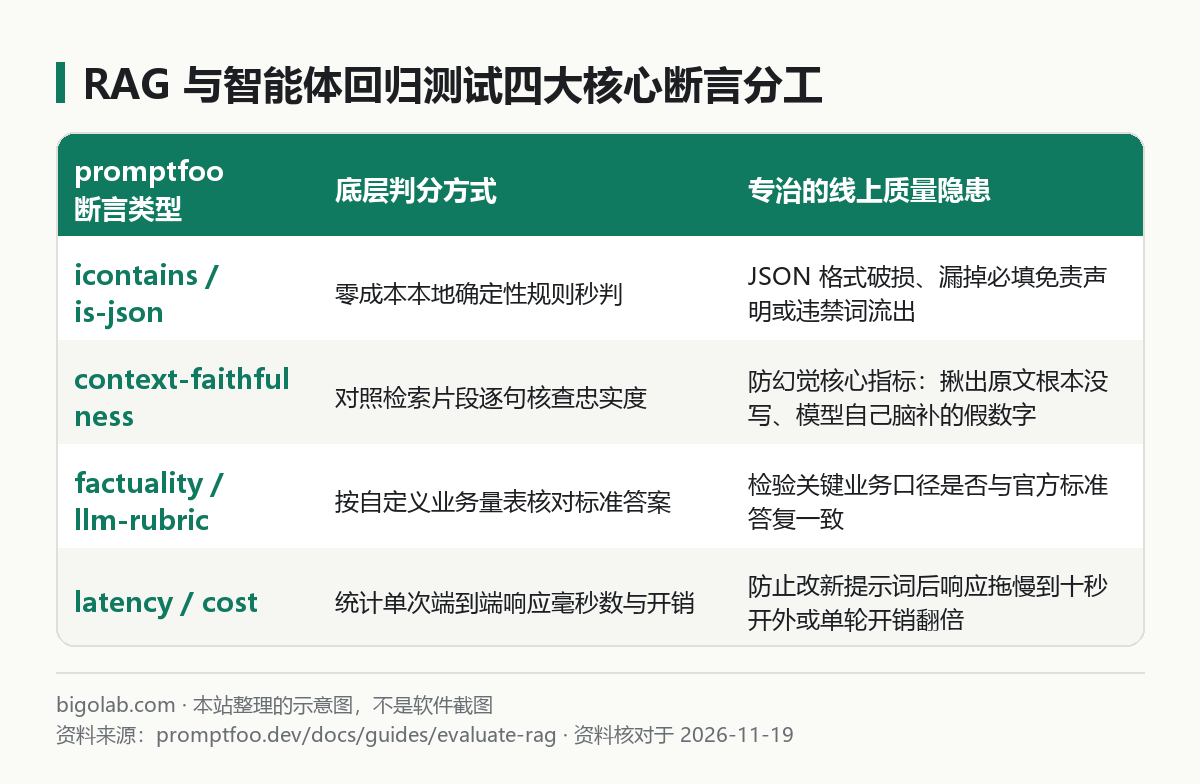
一、給 RAG 知識庫挑對尺子:四大核心斷言組合拳
評測知識庫問答不能只靠字符串包含匹配(icontains),因為大模型說話措辭每次都在變。在 promptfooconfig.yaml 裏,官方提供了一套專門審計“檢索—生成”全鏈路的內置斷言(Assertions),把硬規則和模型裁判結合起來最穩當:
二、實戰 promptfooconfig.yaml:同時卡死“瞎編幻覺”與“拒答底線”
在你的知識庫工程根目錄新建一套專門測 RAG 質素的評測配置。注意看我們是怎麼通過傳入模擬檢索片段 context,用 context-faithfulness(上下文忠實度) 一針見血抓出模型“脫離文檔自己腦補數字”的:
yaml
description: "企業售後知識庫防幻覺與拒答邊界迴歸測試集"

prompts:
  - |
    你是公司官方售後客服助手。請【嚴格且僅依據】下方提供的知識庫參考片段回答用戶問題。
    如果參考片段中未包含答案所需事實,請明確回覆“抱歉,現有說明文檔暫未覆蓋該問題,建議轉接人工客服”,嚴禁自行推測或編造數字。

    <context>
    {{context}}
    </context>

    用戶問題:{{question}}

providers:
  - id: openai:gpt-4o-mini
    config:
      temperature: 0

defaultTest:
  assert:
    # 全局底線:單次響應不得超過 8000 毫秒,且絕不允許出現感嘆號與誇大絕對化用語
    - type: latency
      threshold: 8000
    - type: not-icontains
      value: "百分百包賠"

tests:
  # 用例 1:考核忠實提取與不篡改退換貨時限
  - vars:
      question: "拆封後的藍牙耳機支持幾天無理由退貨?需要扣折舊費嗎?"
      context: "根據 2026 版售後總則第 3.2 條:音頻類拆封商品支持簽收後 7 天內無理由退貨,外觀完好配件齊全免收折舊費。"
    assert:
      - type: icontains
        value: "7"
      - type: context-faithfulness
        threshold: 0.9

  # 用例 2:考核知識庫沒寫時的誠實拒答能力(防幻覺重災區)
  - vars:
      question: "你們在慕尼黑線下直營維修點的營業時間是幾點?"
      context: "目前官方線下直營服務中心僅設於上海與深圳兩地,工作時間為每日 10:00-19:00。"
    assert:
      - type: llm-rubric
        value: "回答必須明確指出文檔未包含慕尼黑網點或僅在上海深圳設有網點,嚴禁編造任何德國營業時間。"
在終端跑一句 npx promptfoo eval 再敲 npx promptfoo view,哪道題因為多嘴腦補被 context-faithfulness 判了紅叉、扣分理由是什麼,在矩陣表格裏清清楚楚。你還可以直接寫一個小型 Python 腳本或 HTTP Provider 指向你真實跑着的後端 /api/rag/query 接口,連同真實向量召回環節一起做端到端聯測。
研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、接入 GitHub Actions:每次改提示詞提 PR 自動跑門禁
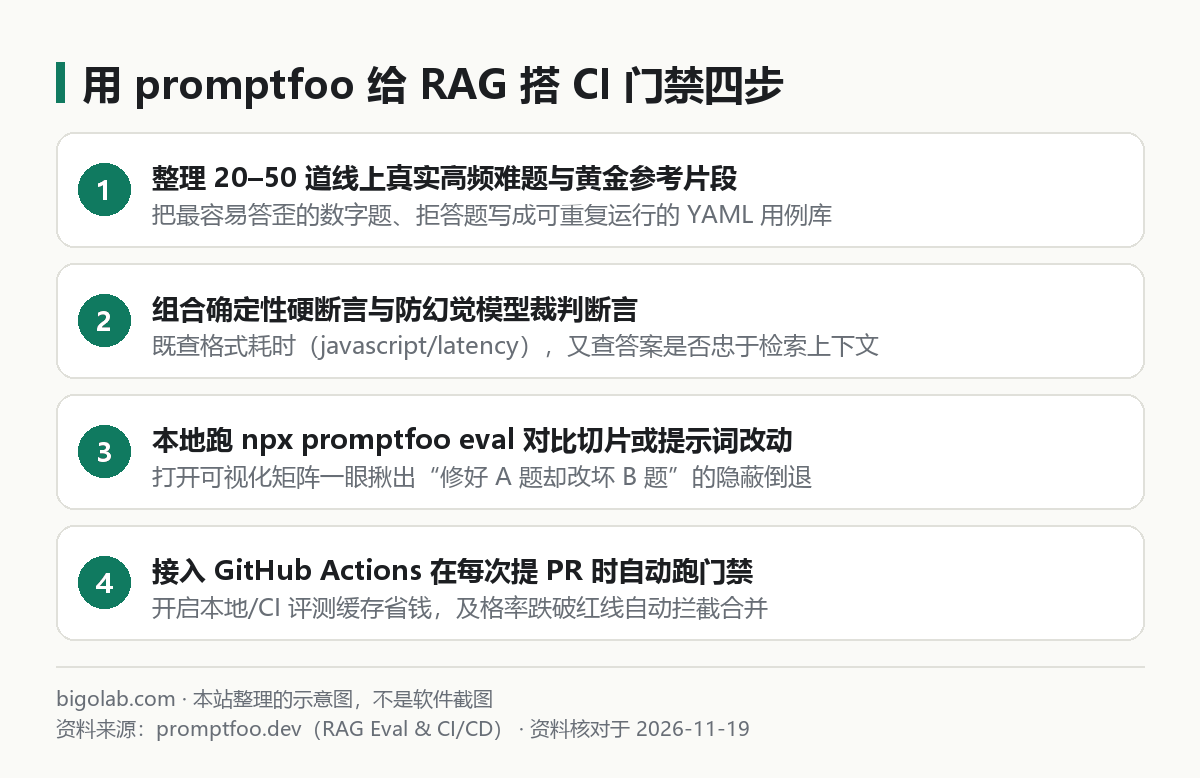
就像我們在倉庫裏配置 自動化安全掃描 CI 門禁 一樣,把這幾十道核心考題掛進 .github/workflows/prompt-eval.yml,只要 prompts/ 目錄或檢索配置發生變動就自動觸發檢驗:
yaml
name: RAG Prompt Regression Gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "src/rag/**"
      - "promptfooconfig.yaml"

jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Run promptfoo evaluation with CI cache
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          config: promptfooconfig.yaml
          cache-path: ~/.cache/promptfoo
          # 關鍵門禁開關:一旦有任何一條黃金用例斷言失敗,立即將 CI 標紅攔截合併
        env:
          PROMPTFOO_ASSERTIONS_MAX_CONCURRENCY: 4
控制 CI 評測帳單不心疼的兩個實戰竅門
很多團隊不敢在每次 PR 時跑模型評測,是怕一天提十次代碼把 API 費刷高。做好這兩步,單次流水線成本連一杯水錢都不到:
- 務必掛載評測緩存目錄(
cache-path):配合 GitHub Actions 的actions/cache,如果本次 PR 只改了第 2 個提示詞模板,未發生輸入變動的歷史用例會瞬間命中本地哈希緩存直接複用上次結果,零重複計費。 - 分層維護“冒煙快篩集”與“週末全量集”:平時每次提 PR 只跑精心挑選的 25–30 道最高頻致命紅線題(耗時不到 40 秒);幾百道長尾邊緣案例放到每週日凌晨定時觸發的 Nightly Workflow 裏全量巡檢。
在日常迭代優化業務提示詞、擴充評測紅隊題庫與編寫自動化評測流水線時,搭配高額度的旗艦大模型訂閱做交叉出題與診斷事半功倍。需要開通海外正規開發與主力對話訂閱的同學,可前往查看貝果研究社 Claude Code 訂閱與配置方案或 ChatGPT Plus 自助充值專頁。
常見問題
用大模型給大模型打分(llm-rubric / context-faithfulness),如果裁判模型自己判歪了怎麼辦?
工程上通行的做法有三條:第一,把裁判模型的 temperature 嚴格鎖死為 0 消除隨機抖動;第二,裁判模型盡量固定選用邏輯嚴密的高一檔穩定模型,不要被測模型和裁判模型同時換來換去失去基準線;第三,評分標準(Rubric)不要寫模糊的“回答語氣好不好”,而是拆成非黑即白的客觀核查項(如“必須提到退貨需保留原包裝盒,且不得承諾報銷順豐保價費”)。
題庫剛開始應該從哪兒收集,沒上線前怎麼湊齊 30 道好題?
切忌拍腦袋自己編三十句“你好請問你們是做什麼的”這種毫無區分度的簡單題。最紮實的題源分三塊:50% 來自歷史人工客服真實聊天記錄裏最常被追問的細節題、30% 專門針對文檔裏帶前置限定條件(“除定製款外……”、“滿三年以上……”)的陷阱題,剩下 20% 專門塞文檔里根本沒有的超綱問題考驗它會不會老實拒答。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 給 RAG 系統做迴歸測試不能只驗關鍵詞,務必組合
context-faithfulness(嚴防脫離原文瞎編)與llm-rubric(嚴守超綱誠實拒答)。 - 將高價值錯題沉澱進受版本管控的
promptfooconfig.yaml,告別改完提示詞靠肉眼試三條就敢上線的盲人摸象模式。 - 接入 GitHub Actions 門禁並開啟評測結果緩存、拆分“PR 30 題快篩集”與“夜間全量集”,用極低成本守住線上回答質素底線。
0 條評論
還沒有評論,來搶沙發~