
結論先說
- 別拿微調當知識庫用:官方明確指出,想讓模型掌握高頻更新的公司資料,應走檢索增強(RAG),微調並不擅長精準塞入新事實。
- 微調真正划算的三個場景:固化難以靠幾句指令描述的文風與私有格式、把旗艦大模型的優質輸出“蒸餾”給便宜快速的小模型、攻克垂直領域的複雜邏輯推理。
- 三種路線分工明確:有標準答案示範對用 SFT(監督微調);能對比“哪句回答更優”用 DPO(偏好優化);讓推理模型在試錯加評分中提分用 RFT(強化微調)。
- 數據貴精不貴多:訓練集一律用每行一個獨立 JSON 對象的
.jsonl文件;SFT 語法底線是 10 條,官方建議先打磨 50 到 100 條高水準樣本起步。 - 帳單分兩筆算:訓練階段按訓練 token 與輪數收費,產出的專屬模型(
ft:...)上線推理時按微調檔位單獨計費。 - 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
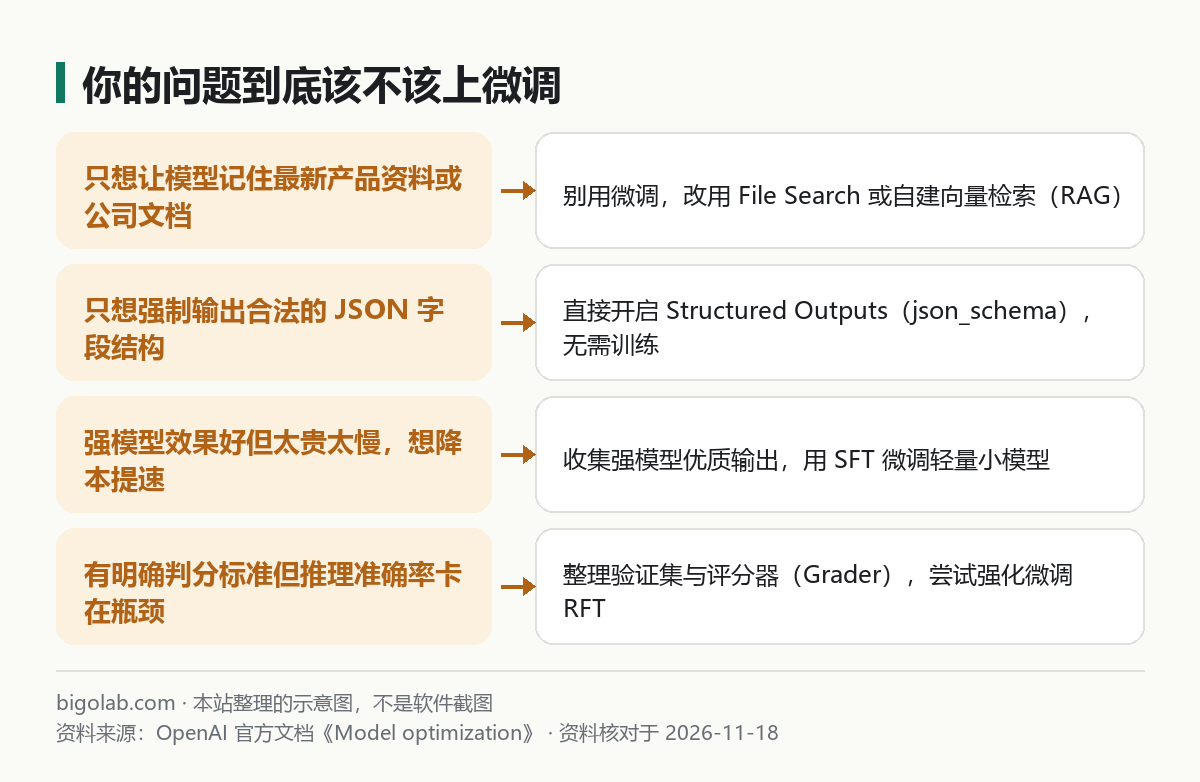
圖:本站根據 OpenAI 官方文檔:Model optimization 整理的示意圖
本文根據 OpenAI 官方文檔《Model optimization》《Supervised fine-tuning》《Reinforcement fine-tuning》與《Direct preference optimization》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 提示詞越寫越長,想把模型調成固定業務風格,或用小模型跑出大模型效果以降本提速的開發者;
- 分不清監督微調(SFT)、直接偏好優化(DPO)和強化微調(RFT)各自解決什麼問題的工程師;
- 第一次準備
.jsonl訓練集,不知道每行 JSON 該怎麼組織的人。
一、動手訓練前先排除兩個常見誤區
花時間洗數據之前,先核對訴求能不能用零訓練成本的原生功能直接搞定:
- 誤區一:為了輸出合法 JSON 去微調。直接開結構化輸出(見 /guides/openai-api-structured-outputs),靠
json_schema就能在解碼層鎖死字段格式,無需跑訓練。 - 誤區二:為了背誦內部手冊去微調。把文檔切塊建向量庫(見 /guides/openai-api-embeddings)既能隨時更新,還能返回原文引用;靠微調硬記文檔不僅貴,還容易張冠李戴。
只有當你確認改提示詞和加檢索都碰到了瓶頸,或者線上並發極大、必須把超長示例壓縮進小模型來省輸入 token 與延遲時,再進入微調環節。若你只是個人辦公想讓助手記住寫作口吻和參考資料,直接在網頁端用項目(Projects)或自定義指令即可;需要升級訂閱可查看本站 ChatGPT Plus,注意網頁會員與 API 微調分屬兩套獨立計費系統。
二、SFT、DPO 與強化微調(RFT)有什麼區別
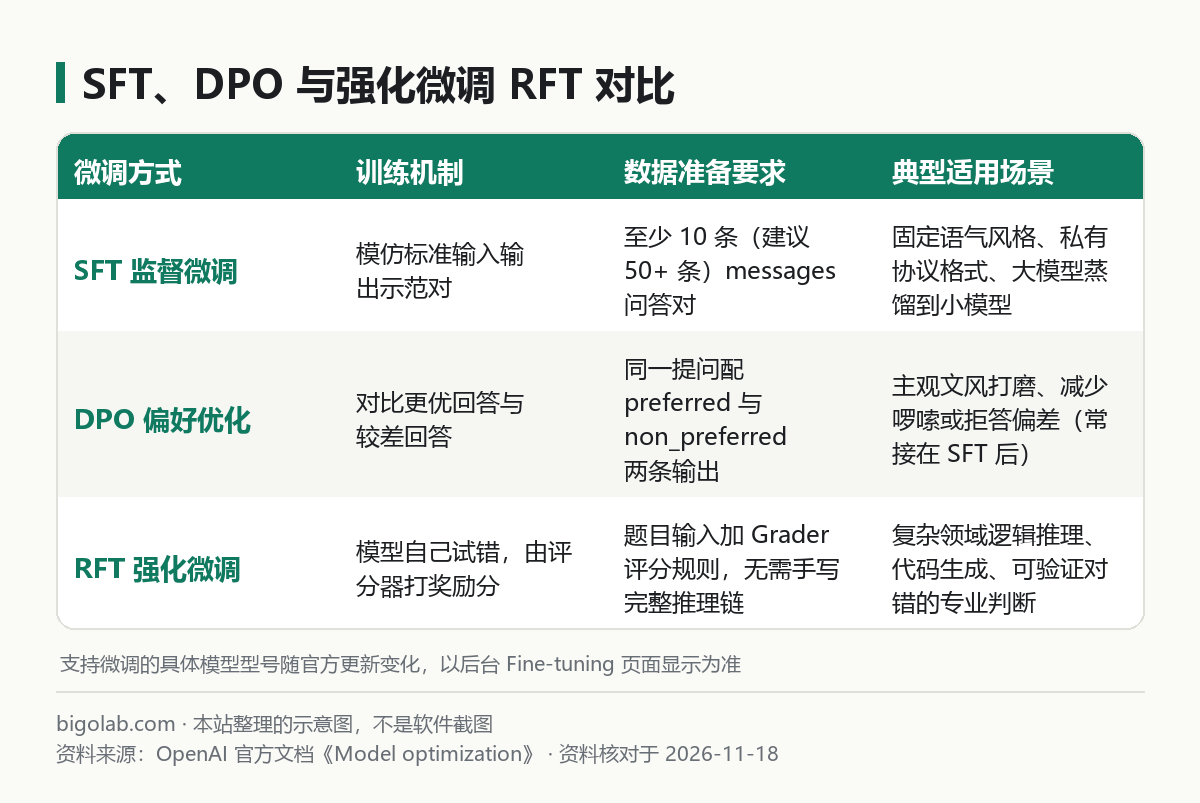
圖:本站根據 OpenAI 官方文檔:Model optimization 整理的示意圖
在實際選型時,可以按手裏能拿出什麼樣的數據來對號入座:
- 首選 SFT(監督微調):絕大多數業務微調都從這裏起步。只要你能整理出一批“遇到什麼輸入、理想答案該怎麼寫”的成對樣本,就能拿來做模型蒸餾——先用昂貴的旗艦模型跑出幾百條經人工審核的高分結果,再拿去微調輕量小模型,往往能以更低延遲和幾分之一的推理單價跑出接近的效果。
- 進階用 DPO(直接偏好優化):如果任務偏主觀(例如客服安撫話術、品牌文案),很難寫出唯一標準答案,但人工很容易挑出“A 回覆比 B 回覆更得體”,就適合用 DPO。官方推薦先做一輪 SFT 打底,再疊一輪 DPO 修整細節。
- 複雜推理看 RFT(強化微調):當你面對法律條文適用、醫療編碼、複雜代碼修復等高難度推理題,SFT 死記硬背表面格式卻學不會深層邏輯時,RFT 允許推理模型自己生成多條解題路徑,由你配置的評分器(Grader)自動判分反饋,靠獎勵信號把領域推理準確率推上去。
本站訂閱與團隊開通提示:如果你在國內遇到銀行卡被拒或急需提升對話與推理配額,可前往本站 ChatGPT Plus 充值說明頁 或 ChatGPT Pro 5x/20x 充值頁 自助獲取卡密完成開通(全程無需交出帳號密碼,可開增值稅發票);企業多成員協作可直接查看 ChatGPT Business 團隊定製方案。
三、訓練數據的 .jsonl 標準格式與提交代碼
訓練文件後綴必須是 .jsonl,整個文件外層不要加方括號 [],每一行單獨寫一個無換行的 JSON 對象。
1. SFT 與 DPO 單行格式對照
SFT 每行是一個 messages 對話列表,system 提示詞要與線上實際調用保持一致:
json
{"messages": [{"role": "system", "content": "你是工單提取器,僅輸出故障部件與訴求"}, {"role": "user", "content": "耳機左耳沒聲了,請換新"}, {"role": "assistant", "content": "部件:左耳單元;訴求:換貨"}]}
DPO 則在一條 input 後同時給出 preferred_output(更優回答)和 non_preferred_output(較差回答);官方建議先跑一輪 SFT 再接 DPO 微調語氣。至於面向推理模型的 RFT,每行提供題目與參考標準字段,並在作業配置裏綁定評分器(Grader)給模型生成的推理結果打 0 到 1 的獎勵分。
2. 用 Python 上載並啟動 SFT 作業
配好密鑰(見 /guides/openai-api-key)後,上載文件時 purpose 固定填 "fine-tune":
python
from openai import OpenAI

client = OpenAI()

train_file = client.files.create(
    file=open("sft_train_data.jsonl", "rb"),
    purpose="fine-tune",
)

job = client.fine_tuning.jobs.create(
    training_file=train_file.id,
    model="gpt-4o-mini-2024-07-18",
)
print("作業 ID:", job.id, "狀態:", job.status)
提交後可在後台 Dashboard → Fine-tuning 觀察損失曲線。狀態變為 succeeded 後會生成 ft: 開頭的專屬模型 ID,直接填進業務代碼的 model 參數即可調用,單價請提前核對 /guides/openai-api-price-official-table。
常見問題
問:微調產出的專屬模型會被別人看到或調用嗎?
不會。ft: 模型歸屬於你所在的組織與項目(Project),只有擁有該項目權限的密鑰能調用,也可隨時在後台刪除。
問:訓練完反而比原來更笨是怎麼回事?
常見於髒數據混入、訓練輪數(n_epochs)過大導致小樣本過擬合,或線上調用漏傳了訓練時的 system 提示詞。建議留出 10% 到 20% 樣本作為 validation_file 監控過擬合。
問:強化微調(RFT)提示沒有權限怎麼辦?
部分推理基座與 RFT 功能要求達到指定用量層級或先完成後台組織身份驗證(Organization Verification),請按控制檯提示核對資格。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
- OpenAI API 結構化輸出(Structured Outputs)怎麼寫
- OpenAI Embeddings 向量怎麼用
- OpenAI API 價格表與計費說明
- OpenAI API Key 怎麼獲取
參考資料
- OpenAI 官方文檔:Model optimization — https://developers.openai.com/api/docs/guides/model-optimization
- OpenAI 官方文檔:Supervised fine-tuning — https://developers.openai.com/api/docs/guides/supervised-fine-tuning
- OpenAI 官方文檔:Reinforcement fine-tuning — https://developers.openai.com/api/docs/guides/reinforcement-fine-tuning
- OpenAI 官方文檔:Direct preference optimization — https://developers.openai.com/api/docs/guides/direct-preference-optimization
0 條評論
還沒有評論,來搶沙發~