
結論先說
- 官方主力審核模型是
omni-moderation-latest,基於多模態底座構建,支持在同一次/v1/moderations請求裏同時傳入文本與圖片(舊版text-moderation-latest僅支持純文本)。 - 審核接口本身免費調用:官方定價頁明確標註 Moderation API 不收 token 費用,但每分鐘請求數(RPM)和每分鐘 token 數(TPM)仍受你帳號當前用量層級的限制。
- 先審後調能節省主模型成本:在把用戶輸入發往高單價推理或生成模型之前先調審核接口,一旦返回
flagged: true直接在業務層禮貌攔截,既降低帳號違規風險,也省去後續生成開銷。 - 返回對象提供四組關鍵字段:總判定布爾值
flagged、各細分維度布爾值categories、0 到 1 的連續分數category_scores,以及指出由哪種輸入模態觸發標記的category_applied_input_types。 - 留意模態覆蓋邊界:當前支持文本與圖片(公開 HTTPS 連結或 Base64 數據),不支持直接傳入音頻;其中
illicit(違規行為指導類)目前只對文本輸入生效。 - 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
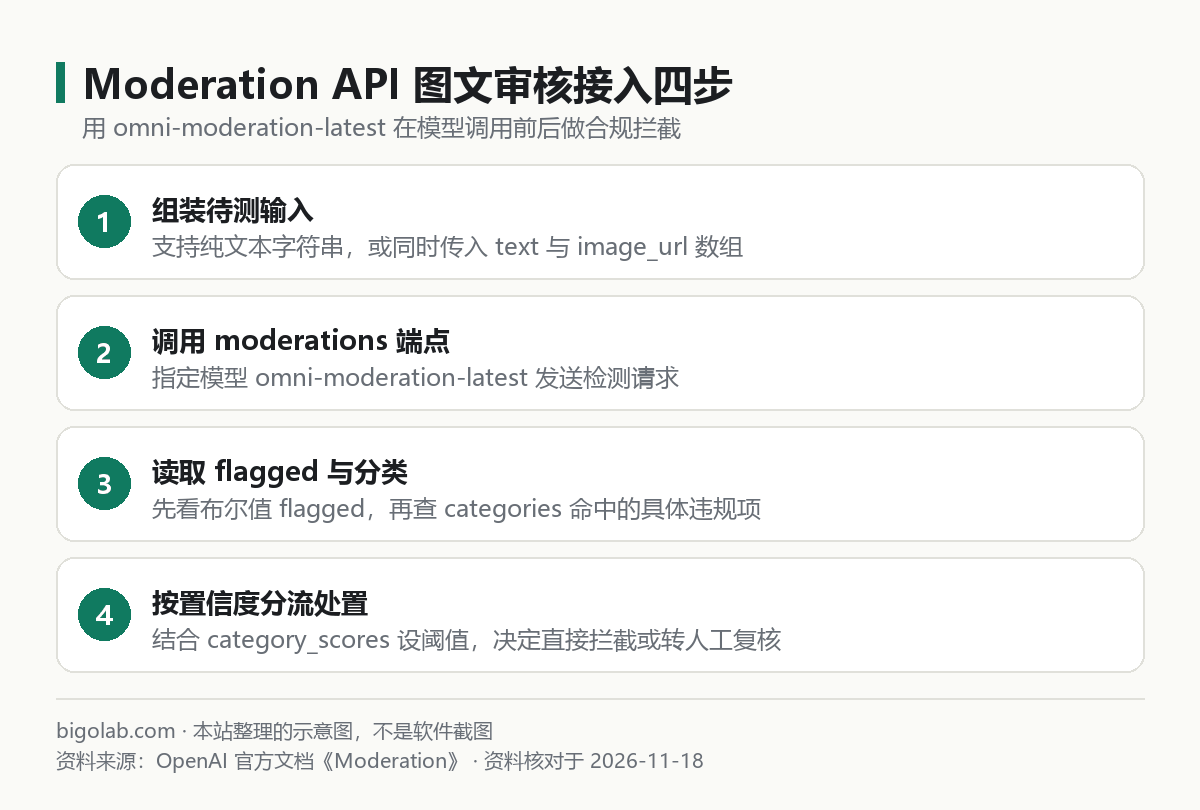
圖:本站根據 OpenAI 官方文檔:Moderation 整理的示意圖
本文根據 OpenAI 官方文檔《Moderation》與官方定價頁整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 開發面向外部用戶的對話助手、表單處理或圖文生成應用,需要在把內容發給主模型之前先做一層合規過濾的開發者;
- 之前只用過舊版純文本審核接口,想知道怎麼在一次請求裏同時檢測文字與圖片的工程師;
- 擔心增加安全護欄會讓 API 調用帳單顯著上漲的人。
一、純文本與圖文混合調用代碼(Python)
調用前請確保已在環境變量配置好 OPENAI_API_KEY(還沒跑通過首個 API 請求的讀者可先看 /guides/openai-api-python-quickstart)。
1. 檢測單條或批量純文本
input 參數既可以傳單個字符串,也可以傳字符串數組,一次批量檢測多條用戶留言:
python
from openai import OpenAI

client = OpenAI()

resp = client.moderations.create(
    model="omni-moderation-latest",
    input="這裏放入待檢測的用戶提問或生成文本",
)

result = resp.results[0]
print("是否命中攔截規則:", result.flagged)
2. 在一次請求裏同時檢測文字與圖片
當你的產品允許用戶附帶截圖或照片提問時(常規視覺傳圖規範見 /guides/openai-api-image-input),可以把 input 組裝成包含 text 與 image_url 的多模態數組,圖片支持公開網址或 Base64 編碼的 Data URI:
python
resp = client.moderations.create(
    model="omni-moderation-latest",
    input=[
        {"type": "text", "text": "請幫我為這張活動配圖寫一段宣傳文案"},
        {
            "type": "image_url",
            "image_url": {"url": "https://example.com/poster-draft.png"},
        },
    ],
)

res = resp.results[0]
if res.flagged:
    print("命中風險項,觸發來源模態:", res.category_applied_input_types)
二、返回結構拆解:怎麼看懂四個核心字段
每次調用 moderations.create 返回的 results 列表裏,每個元素都包含四塊結構化數據:
| 返回字段 | 數據類型 | 業務用途說明 |
|---|---|---|
flagged | 布爾值 | 只要任一細分風險維度超過官方預設判定線即為 true,適合做快速總開關 |
categories | 鍵值布爾字典 | 列出 hate、harassment、violence、illicit 等官方一級與二級分類各自的布爾判定結果,完整鍵名列表以官方文檔表為準 |
category_scores | 鍵值浮點字典 | 給出每個分類 0 到 1 之間的模型置信度得分,便於業務方按自身嚴格度重設閾值 |
category_applied_input_types | 鍵值數組字典 | 圖文混傳時標明某分類是由 ["text"]、["image"] 還是兩者共同觸發,方便前端給出精準提示 |
關於 OpenAI 平台整體禁止哪些內容場景,可對照閱讀 /guides/chatgpt-restricted-content-usage-policy。如果你並非接入 API,而是在日常使用網頁端時關心訂閱帳號權限與升級方式,可查看本站 ChatGPT Plus 說明頁,注意個人會員訂閱與開發者 API 屬於兩套獨立系統。
本站訂閱與團隊開通提示:如果你在國內遇到銀行卡被拒或急需提升對話與推理配額,可前往本站 ChatGPT Plus 充值說明頁 或 ChatGPT Pro 5x/20x 充值頁 自助獲取卡密完成開通(全程無需交出帳號密碼,可開增值稅發票);企業多成員協作可直接查看 ChatGPT Business 團隊定製方案。
三、工程落地時的分流與防踩坑建議
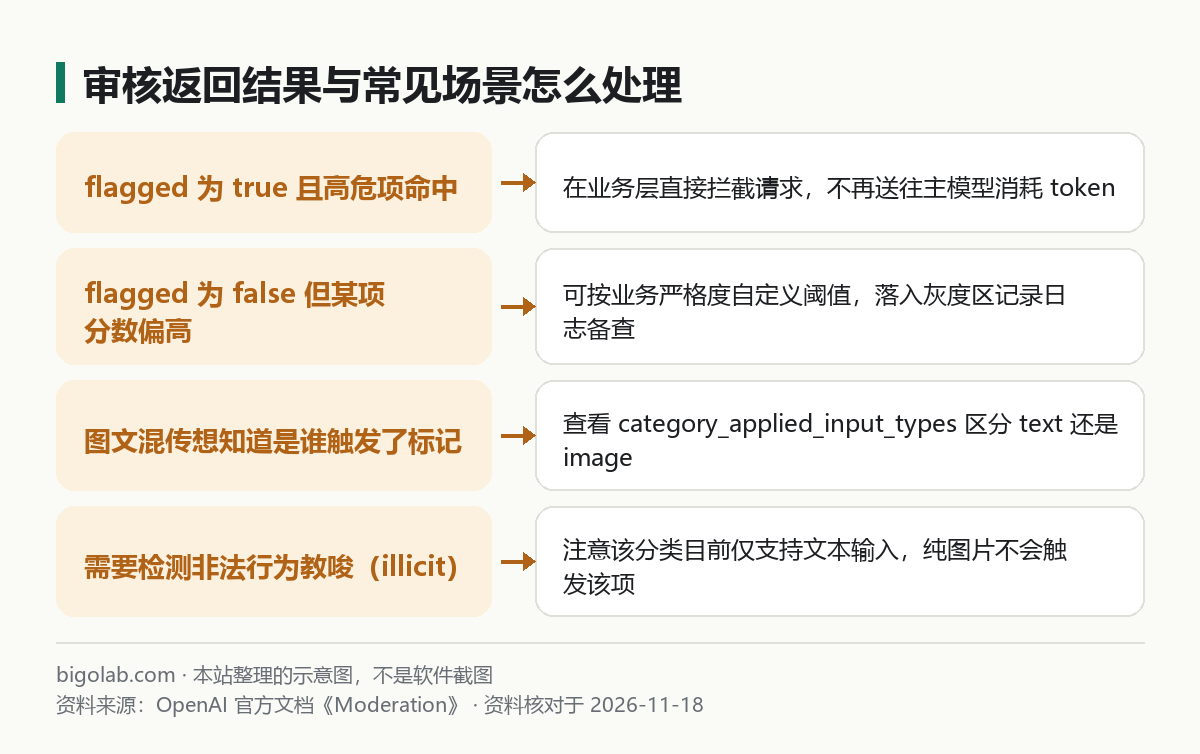
圖:本站根據 OpenAI 官方文檔:Moderation 整理的示意圖
把審核接口真正放進生產鏈路時,建議做好以下三件事:
- 輸入與輸出雙端設防:除了在調主模型前做輸入側檢查(Input Guardrail),對安全要求嚴苛的公開應用還可以把主模型吐出的草稿再過一遍審核接口,確認無誤後再返回給終端頁面,也可異步並行執行以減少首字等待。
- 按業務場景微調分數線:不同行業對邊界內容的容忍度差異很大。兒童教育類應用可以把
category_scores的攔截閾值調得比預設flagged更嚴;而新聞摘要、法學檢索類工具若遇到正常專業術語誤報,可設定灰度分數區間轉人工抽檢。 - 預留速率餘量並處理長文:新建或低層級 API 帳號的每分鐘請求上限較低,高並發上線前請核對 /guides/openai-api-usage-tiers-rate-limits。另外遇到上萬字長文檔時,單句違規內容容易被大段常規敘述稀釋分數,建議按自然段落切分後放進數組批量送檢。
常見問題
問:既然 Moderation API 免費,能拿來單獨審核與 OpenAI 無關的普通社區回帖嗎?
不建議。按 OpenAI 官方使用政策說明,該免費端點旨在幫助開發者保障圍繞 OpenAI 構建的應用安全;脫離 OpenAI 模型調用場景、單純把它當作第三方免費內容審核接口高頻刷量,可能觸發平台限制或違反使用條款。
問:底層模型迭代後,我寫死在代碼裏的分數閾值需要改嗎?
需要定期覆核。omni-moderation-latest 指向持續更新的最新快照,官方明確提示模型升級後同一段文本的概率校準值可能發生變化;依賴自定義 category_scores 閾值的系統,應在模型更新後用固定測試集重測一遍。
問:傳入中文或中英混排內容能正常識別嗎?
可以。相比早期側重英文的舊版純文本審核模型,基於多模態底座的新模型對中文等主流語種的語義理解能力提升明顯,日常中文問答和常見圖文場景可直接接入。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
參考資料
- OpenAI 官方文檔:Moderation — https://developers.openai.com/api/docs/guides/moderation
- OpenAI 官方定價頁 — https://developers.openai.com/api/docs/pricing
0 條評論
還沒有評論,來搶沙發~