
結論先說
- File Search 是 Responses API 內置的託管檢索工具,配合向量庫(Vector Stores)使用,由 OpenAI 自動完成文檔解析、分塊、向量化(Embedding)以及語義加關鍵詞混合檢索。
- 接入只需四步:上載文件拿到
file_id、創建vector_store並掛載文件、等狀態變為completed、在responses.create的tools裏加上file_search和vector_store_ids。 - 支持返回精確引用與原始片段:模型回答正文裏的
annotations會附帶file_citation(來源文件 ID 與文件名);想在調試時拿到命中的原始文本塊,請求裏加include=["file_search_call.results"]。 - 單文件上限 512 MB(最多 500 萬 token),預設按約 800 token 一塊、400 token 重疊自動切分,也支持自定義分塊大小與按元數據(Metadata)過濾文件。
- 計費分三塊:向量庫存儲費(官方提供前 1 GB 免費額度,超出按日按 GB 計費)、
file_search工具調用費,以及檢索出的文本塊送進上下文產生的常規輸入 token 費。 - 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
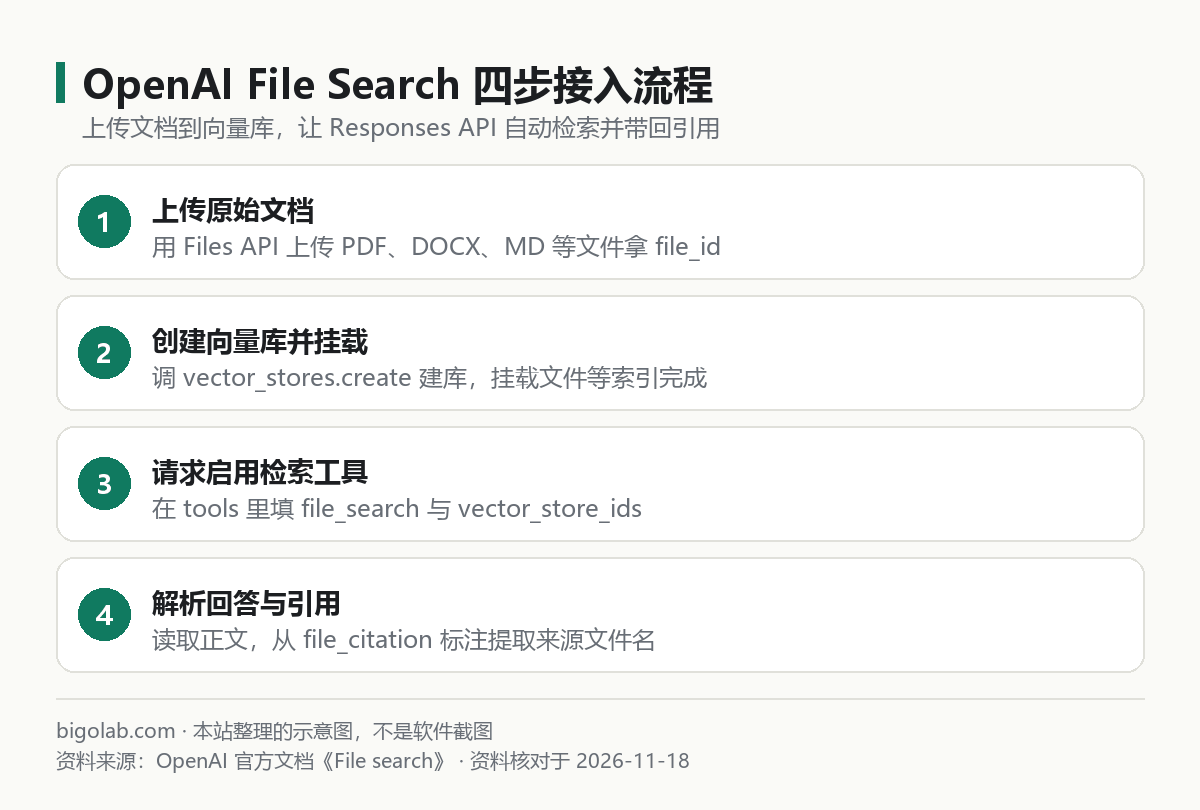
圖:本站根據 OpenAI 官方文檔:File search 整理的示意圖
本文根據 OpenAI 官方文檔《File search》與官方定價頁整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 有多份產品手冊、規章制度或技術文檔,想在 OpenAI API 裏做知識庫問答(RAG)卻不想自己搭向量數據庫的開發者;
- 用過單次文件輸入(見 /guides/openai-api-file-inputs-pdf),發現每次把整份大文件塞進請求既慢又費 token 的人;
- 需要在前端展示回答具體引用了哪份文檔片段的人。
一、它和直接傳文件、自建向量庫有什麼區別
在決定要不要用 File Search 之前,先看清官方提供的三條路徑各自適合什麼情況:
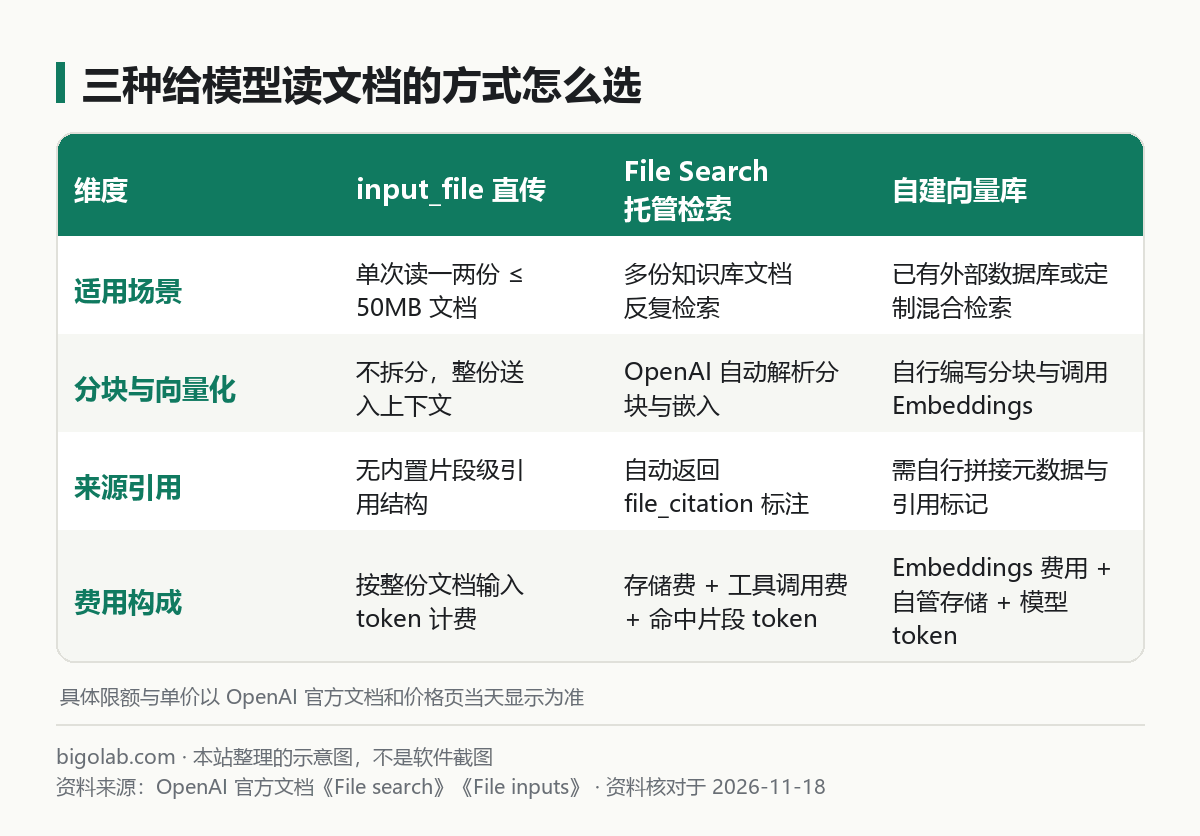
圖:本站根據 OpenAI 官方文檔:File search 與《File inputs》整理的示意圖
簡單判斷:只讓模型總結手頭一兩份 50 MB 以內的 PDF,直接用 input_file 最省事;有一批知識庫文檔要反覆跨文件查細節,用本文的 File Search 最快落地;如果公司數據必須留在自有 PostgreSQL 或本地庫裏,再自己調 /guides/openai-api-embeddings 建庫。
如果你並不打算自己寫代碼調 API,只是日常辦公想把幾份資料放進項目空間反覆提問,可以直接在 ChatGPT 網頁端的項目(Projects)裏傳文件使用;需要更高對話與文件額度時,可以在本站了解 ChatGPT Plus,注意網頁會員訂閱與本文講的開發者 API 帳單完全分開計算。
二、完整 Python 接入步驟(創建向量庫到發起檢索)
前提是已經在平台拿到密鑰並配好環境變量 OPENAI_API_KEY(未配置的可先看 /guides/openai-api-key)。
1. 上載文檔並創建向量庫
先把本地文檔傳到 Files API(用於檢索工具時,purpose 填 assistants),再創建向量庫並把文件掛進去。官方 SDK 提供了帶輪詢的輔助方法,不用自己手寫循環等索引完成:
python
from openai import OpenAI

client = OpenAI()

# 1. 創建向量庫(Vector Store)
vector_store = client.vector_stores.create(name="產品售後知識庫")

# 2. 上載文檔並掛入向量庫,等待解析與分塊完成
with open("return_policy.pdf", "rb") as f:
    file_batch = client.vector_stores.file_batches.upload_and_poll(
        vector_store_id=vector_store.id,
        files=[f],
    )

print("批次狀態:", file_batch.status)
print("文件統計:", file_batch.file_counts)
只有當狀態變成 completed 後,新傳的文檔才能被搜到。官方支持 PDF、DOCX、TXT、Markdown、JSON 及多種常見代碼文件,單文件最大 512 MB、上限 500 萬 token。
2. 在 Responses API 裏啟用 file_search
把剛拿到的 vector_store.id 放進 tools 列表即可(Responses API 的基礎結構見 /guides/openai-responses-api):
python
response = client.responses.create(
    model="gpt-4o",  # 請替換為官方模型頁當前推薦的型號
    input="拆封後的配件支持幾天內退換?有什麼限制條件?",
    tools=[
        {
            "type": "file_search",
            "vector_store_ids": [vector_store.id],
            "max_num_results": 5,
        }
    ],
    include=["file_search_call.results"],
)

print(response.output_text)
模型會自動判斷當前問題需不需要查庫:需要時先生成檢索詞去向量庫拉取片段,再結合片段生成回答。
本站訂閱與團隊開通提示:如果你在國內遇到銀行卡被拒或急需提升對話與推理配額,可前往本站 ChatGPT Plus 充值說明頁 或 ChatGPT Pro 5x/20x 充值頁 自助獲取卡密完成開通(全程無需交出帳號密碼,可開增值稅發票);企業多成員協作可直接查看 ChatGPT Business 團隊定製方案。
三、怎麼讀取來源引用(Annotations)與原始片段
返回結果裏的 response.output 通常包含兩類關鍵項:
file_search_call:記錄這次工具調用的 ID、狀態;如果請求時加了include=["file_search_call.results"],這裏還會列出命中的原始文本塊、得分和所屬文件名,排查“為什麼答偏了”全靠看這一項。message(模型回答):在正文內容塊的annotations數組裏,每處引用的類型都是file_citation,包含file_id、filename和字符位置索引。前端可以據此渲染“參考來源:《xxx.pdf》”。
四、控制成本與精度的三個常用參數
- 限制召回塊數(
max_num_results):檢索出來的每一塊文本都會塞進模型上下文按輸入 token 計費。把max_num_results調小(例如設為 4 到 8)能明顯降低延遲和單次 token 開銷,但設得太小可能漏掉跨段落資訊。 - 元數據過濾(
filters):給向量庫裏的文件打上鍵值對屬性(如category: "billing"或年份),提問時在file_search工具裏傳filters條件,只搜指定範圍的文檔,減少無關干擾。 - 設定過期清理(
expires_after):如果是給臨時會話建的向量庫,創建時設好閒置自動過期天數,防止廢棄庫一直佔着容量產生按日存儲費。各檔位具體單價請核對 /guides/openai-api-price-official-table。
常見問題
問:文檔剛傳上去就提問,為什麼模型說找不到相關內容?
大PDF解析、切塊和算向量需要時間。文件還在 in_progress 狀態時搜不到,務必用 upload_and_poll 或先查 vector_stores.files 確認狀態已是 completed,若變成 failed 需檢查文件是否加密損壞或超出 500 萬 token 上限。
問:掃描版純圖片 PDF 能用 File Search 檢索嗎?
File Search 依賴從文件裏提取出的文本建索引;純掃描件若沒有內嵌文字層,提取出的文本為空就無法檢索。這類帶大量版面圖像的少頁數 PDF,改用 input_file 走視覺解析更合適。
問:刪除向量庫(Vector Store)會把原始上載的文件一起刪掉嗎?
不會。向量庫只是索引容器,刪掉向量庫只會停止繼續計收該庫的向量存儲費,Files API 裏的原始文件仍保留在後台,需要徹底清理時另調 client.files.delete。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
參考資料
- OpenAI 官方文檔:File search — https://developers.openai.com/api/docs/guides/tools-file-search
- OpenAI 官方定價頁 — https://developers.openai.com/api/docs/pricing
0 條評論
還沒有評論,來搶沙發~