
結論先說
- Responses API 提供三種多輪狀態管理路徑:傳
previous_response_id串聯響應、用Conversations接口建持久會話對象、或客戶端手動把歷史條目拼進input數組。 previous_response_id最省代碼但有兩個坑:第一,它不繼承上一輪的頂層instructions,每輪仍需傳;第二,鏈條中帶入的前序上下文依然照常計收輸入 token 費。- 需要類似舊 Threads 的持久線程管理,用
Conversations接口:先調client.conversations.create()拿到會話 ID,後續請求傳conversation參數即可自動追加消息。 - 開啟
store: false(或零數據保留 ZDR)時必須手動拼數組:若使用推理模型且不落盤,還需請求返回並原樣回傳帶encrypted_content的加密推理條目。 - 從零認識 Responses API 與舊接口差異,可先讀 /guides/openai-responses-api。
- 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
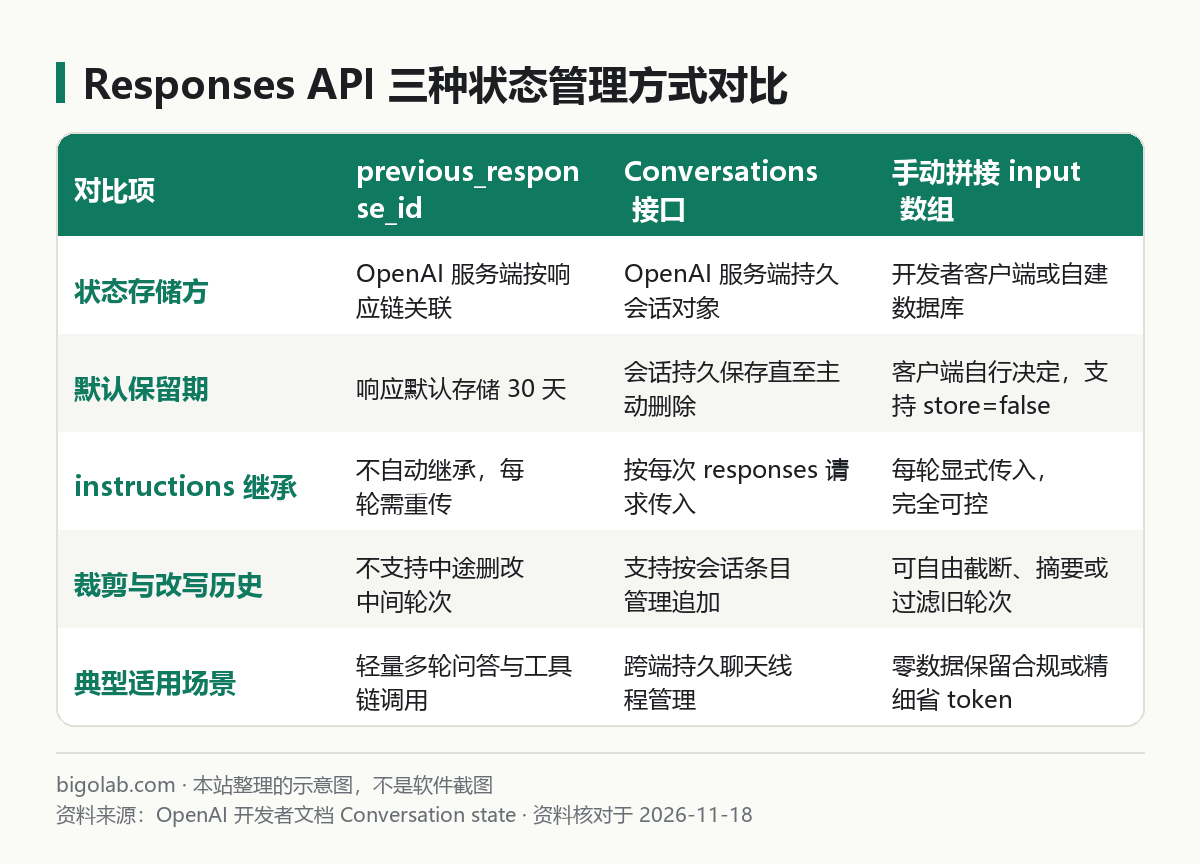
圖:本站根據 OpenAI 開發者文檔:Conversation state 整理的示意圖
本文根據 OpenAI 開發者文檔《Conversation state》《Migrate to the Responses API》與 API Reference 整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 從 Chat Completions 或舊版 Assistants API 遷到 Responses API,糾結怎麼儲存多輪聊天上下文的開發者;
- 用了
previous_response_id後發現第二輪系統人設失效、或者誤以為服務端託管歷史能免掉舊消息 token 費的人; - 需要在合規零存儲(
store: false)、持久聊天室與輕量工具循環之間選型的團隊。
一、三種狀態管理方式完整對比
在舊的 Chat Completions 裏,多輪對話只有「客戶端自己存全量 messages 數組每輪重發」這一種辦法;而在 Responses API 中,輸入輸出統一抽象為條目(Items),你可以按業務形態三選一:
| 對比維度 | previous_response_id | Conversations 接口 | 手動拼接 input 數組 |
|---|---|---|---|
| 誰存歷史記錄 | OpenAI 服務端按響應鏈串聯 | OpenAI 服務端獨立會話容器 | 開發者自己的客戶端或數據庫 |
| 預設保留時間 | 單條響應預設存儲 30 天 | 持久保留直至調接口刪除 | 完全由你控制,可配 store=False |
| 能否分叉對話 | 極方便(指向任意舊響應 ID 即可分叉) | 線性追加為主 | 自由複製切片數組即可分叉 |
| 能否裁剪中間舊消息 | 不支持直接刪改鏈條中間節點 | 可通過會話條目接口管理 | 完全自由截斷、做摘要壓縮 |
| 歷史上下文計費 | 按實際送入模型的歷史輸入 token 計費 | 按實際送入模型的輸入 token 計費 | 按你傳過去的 input token 計費 |
需要提醒的是:無論由服務端代存還是本地重傳,模型在生成新回覆時都要重讀前文,因此歷史上下文均會計入輸入 token(好在重複長前綴會自動享受提示詞緩存摺扣,單價參考 /guides/openai-api-price-official-table)。API 按量扣費與網頁訂閱互不通用,若只是個人日常在網頁端對話直接開通 ChatGPT Plus 即可,區別見 /guides/chatgpt-subscription-vs-openai-api。
二、方式一與方式二:服務端託管寫法示例
1. 用 previous_response_id 輕量串聯(支持隨時分叉)
適合單次用戶請求內部的多步工具調用循環,或無需長期超過 30 天儲存的短對話。注意每輪顯式帶上 instructions:
python
from openai import OpenAI

client = OpenAI()
SYS_RULE = "用簡明中文回答,每次不超過三句話。"

turn1 = client.responses.create(
    model="gpt-6-astra",
    instructions=SYS_RULE,
    input="PostgreSQL 裏的 MVCC 是做什麼的?",
)

# 第二輪傳入上一輪的 id,同時重新傳入 instructions
turn2 = client.responses.create(
    model="gpt-6-astra",
    instructions=SYS_RULE,
    previous_response_id=turn1.id,
    input="它為什麼會產生膨脹,怎麼清理?",
)
print(turn2.output_text)
2. 用 Conversations 接口管理持久聊天線程
Assistants API 下線後,需要持久化會話列表(例如客服工單會話、跨裝置同步聊天窗口)的應用應改用 Conversations 接口。注意在同一請求裏,conversation 與 previous_response_id 二選一,不要同時傳:
python
from openai import OpenAI

client = OpenAI()

# 1. 創建持久會話對象(可寫入業務 metadata 便於檢索)
conv = client.conversations.create(metadata={"user_id": "u_10086"})

# 2. 綁定 conversation ID 發起多輪對話,服務端自動把輸入輸出追加進該會話
r1 = client.responses.create(
    model="gpt-6-astra",
    conversation=conv.id,
    input="幫我擬一份三天的京都步行路線。",
)

r2 = client.responses.create(
    model="gpt-6-astra",
    conversation=conv.id,
    input="把第二天改成以宇治喝茶為主。",
)
print(r2.output_text)本站訂閱與團隊開通提示:如果你在國內遇到銀行卡被拒或急需提升對話與推理配額,可前往本站 ChatGPT Plus 充值說明頁 或 ChatGPT Pro 5x/20x 充值頁 自助獲取卡密完成開通(全程無需交出帳號密碼,可開增值稅發票);企業多成員協作可直接查看 ChatGPT Business 團隊定製方案。
三、方式三:手動拼 input 數組與無狀態(store: false)注意要點
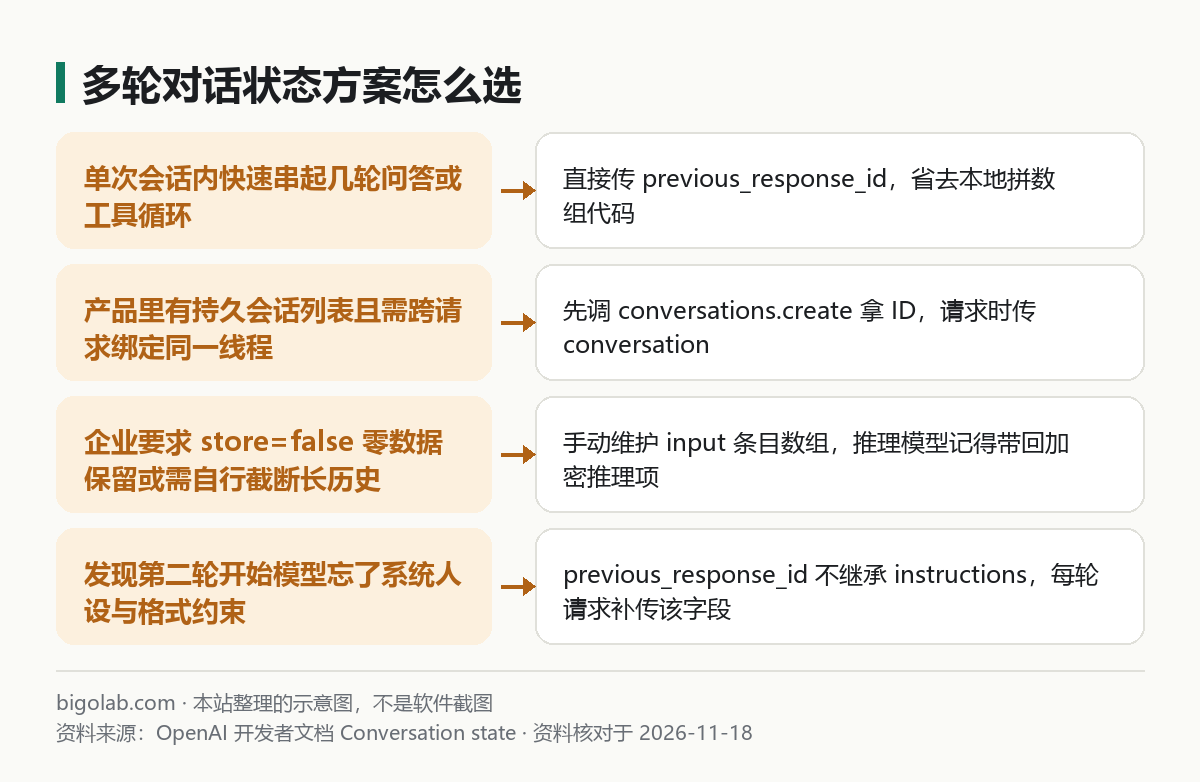
圖:本站根據 OpenAI 開發者文檔:Conversation state 整理的示意圖
在兩類場景下,手動維護 input 列表依然不可替代:一是長對話超過幾萬字後你想在本地把早期閒聊壓縮成摘要省錢(計數方式見 /guides/openai-api-token-count-estimate);二是企業有嚴格私隱要求,必須設定 store=False(零數據保留組織預設強制不存儲)。
手動拼接時千萬別隻取 output_text 純文字往回塞,而要把 response.output 裏的結構化條目(含工具調用項與推理項)整體保留:
python
history = [{"role": "user", "content": "查一下訂單 ORD-99 的物流狀態"}]

resp = client.responses.create(
    model="gpt-6-astra",
    store=False,
    include=["reasoning.encrypted_content"],  # 不落盤時跨輪保留推理狀態
    input=history,
)

# 把模型本輪產生的推理條目、工具調用或回覆條目完整拼入歷史
history.extend(resp.output)
如果涉及自定義函數調用,還要把本地執行後的 function_call_output(帶對應 call_id)一併追加進 history,完整工具回傳寫法見 /guides/openai-api-function-calling。
常見問題
問:用了 previous_response_id 之後,為什麼第二輪模型突然不遵守第一輪設的 JSON 格式或語氣要求了?
答:官方遷移文檔特別提醒,頂層參數 instructions 只作用於當前這一次請求,不會順着 previous_response_id 往後遺傳。後續每輪請求都需要帶上相同的 instructions。
問:響應預設存 30 天,超過 30 天再傳舊的 previous_response_id 會怎樣?
答:過期後該響應對象無法再被引用,接口會返回找不到資源報錯。需要跨月保留的長期對話請改用 Conversations 接口,或在自己的數據庫落盤消息記錄。
問:能把 conversation 和 previous_response_id 同時寫進同一個請求裏嗎?
答:不能。兩者分別代表兩種互斥的服務端上下文裝載機制,同一次 responses.create 調用只能選其中一種。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
- OpenAI Responses API 是什麼:和 Chat Completions 的區別與遷移要點
- OpenAI API 函數調用(function calling)怎麼寫
- OpenAI API 的 token 怎麼算、怎麼估算費用
- OpenAI API 價格是多少:各型號每百萬 token 價格表
參考資料
- OpenAI 開發者文檔:Conversation state — https://developers.openai.com/api/docs/guides/conversation-state
- OpenAI 開發者文檔:Migrate to the Responses API — https://developers.openai.com/api/docs/guides/migrate-to-responses
- OpenAI API Reference:Create a response — https://developers.openai.com/api/reference/resources/responses/methods/create
0 條評論
還沒有評論,來搶沙發~