
结论先说
- 绝不要让语言模型直接手写时间轴,用「编号解耦 + Python 回填」彻底锁死时间码:把字幕文件上传给 ChatGPT,先用 Python 抽成
编号 + 原文列表,翻译完成后再由脚本按编号严格拼回原时间轴,错误率可降到零。 - 先抽术语表、再分批精校,杜绝前后译名打架:40 分钟以上的视频动辄上千条字幕,先让模型扫描全文列出高频人名、产品名与行业黑话,人工确认统一译法后再每 60 到 100 条分批精校。
- 保留上下文滑动窗口,解决「一句话被切成两段字幕」的语序灾难:语音识别常把完整长句拦腰斩断,必须在提示词中要求参考前后相邻两句的语境来组织中文,同时保持字幕条数与原文一一对应。
- 导出前务必区分 SRT 与 VTT 语法,并做格式自动化校验:SRT 毫秒用英文逗号且必须有序号,WebVTT 首行必须有
WEBVTT且毫秒用英文句点;用 Python 校验一遍条数一致、空行规范与单行字数后再下载。 - 批量处理长视频多份字幕并反复调用 Python 脚本会较快触及免费档限额:国内无外币卡用户可通过本站 ChatGPT Plus 自助充值 或 ChatGPT Plus 会员直充 获得更高的文件解析与连续长对话额度。
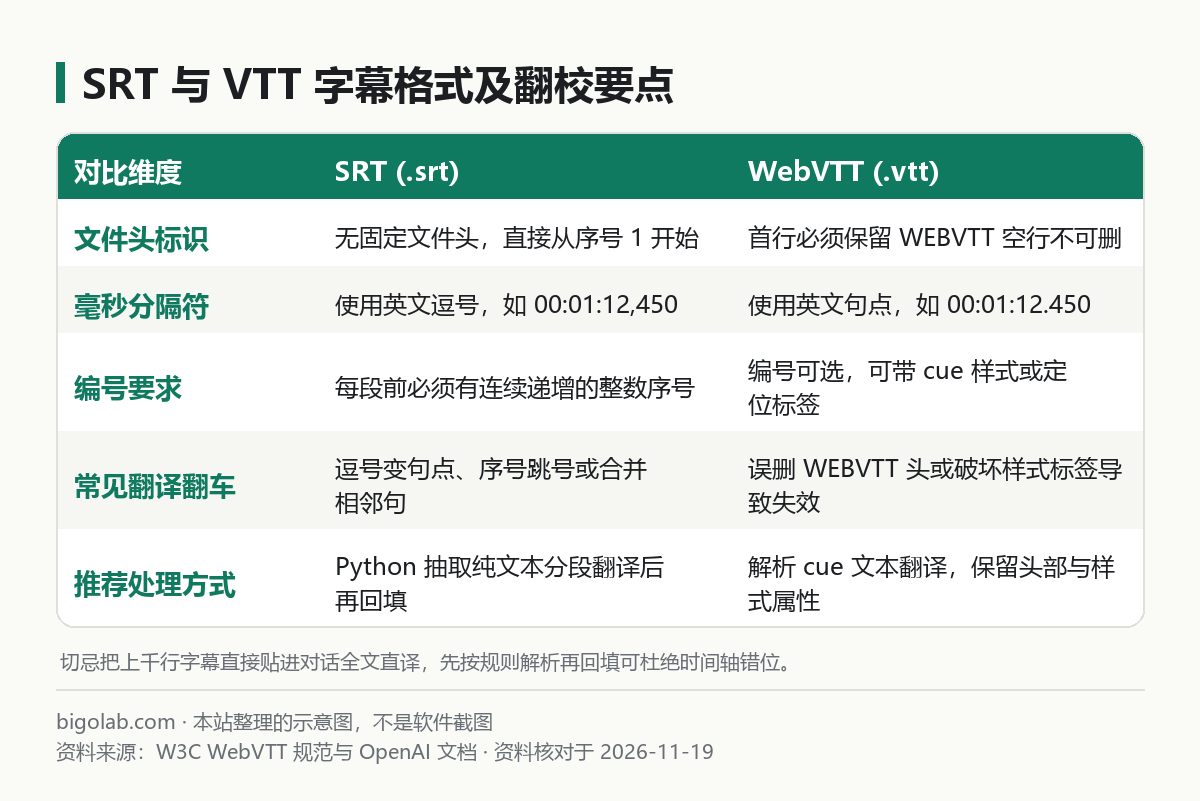
图:本站根据 W3C WebVTT 规范 与 OpenAI 帮助中心文档整理的示意图
本文根据 W3C《WebVTT》规范及 OpenAI 帮助中心《File Uploads FAQ》《Data analysis with ChatGPT》整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 视频创作者、B 站 / YouTube 搬运精译博主与课程制作人,需要把英文演讲、技术公开课或采访视频的
.srt/.vtt字幕做成高质量中英双语字幕的人; - 播客主理人与字幕组成员,希望先修正语音转写里的错听专有名词,再按自然口语意群翻出不生硬的译文,同时保住每一毫秒时间轴不偏移的人;
- 试过把几百行字幕直接粘进对话框要求「翻译成双语」,结果后半段序号消失、时间戳被改乱、导入剪映或 Premiere 报错的创作者。
一、为什么直接贴字幕翻译容易乱跳行
如果你还没有拿到字幕原稿,可以先按 ChatGPT 音频转文字教程 生成初版文字稿;如果只是想先快速看懂视频主旨,可参考 用 ChatGPT 拆解长视频与播客字幕要点。但一旦进入「可直接压制上线的双语字幕」环节,直接把原文件粘进对话框通常会出现三类故障:
- 时间戳漂移或格式破坏:模型在长输出中偶尔会把
00:12:03,450误写成00:12:03.450,或者漏掉-->两侧空格,导致剪辑软件拒读整段后续字幕; - 擅自合并短句导致序号断层:看到两条紧密相连的半句话,模型习惯自动合成一条翻译,结果原文有 420 条、译文只剩 385 条,后半截声画彻底错位;
- 输出截断与译风漂移:单次回复超过长度上限后会触发截断,点击继续时经常重复或跳过中间几条,前后术语风格也容易割裂。
解决思路非常清晰:让 Python 管格式、编号与时间轴,让 ChatGPT 专注做语音错词精校与地道双语翻译。
二、第一步:上传字幕文件,提取术语表与拆批次
把原始的 episode01.srt(或 .vtt)直接作为附件上传,先执行下面这条预处理提示词,建立统一术语表并按固定条数切分文本块(通用文档翻译术语表技巧也见 ChatGPT 翻译与术语表设置方法):
text
我上传了一份英文字幕文件 episode01.srt。请先使用 Python 解析该文件,不要直接翻译全文,按以下步骤完成准备:
1. 统计总字幕条数、总时长,检查是否存在时间戳格式异常、重叠或空文本条目;
2. 扫描全部台词,识别疑似语音识别错听的高频词(如品牌名、技术缩写、人名),输出一份待确认的《术语与人名对照草案表》(列:原文/疑似错听词|建议修正英文|建议中文译名|出现次数);
3. 保持原始序号与时间轴不动,将字幕按每 80 条为一组,打包成仅包含 `id` 和 `en` 字段的 JSON 结构保存在沙盒工作目录,方便我确认术语后逐批精校翻译。
花一分钟扫一眼草案表,把模型猜错的人名或专业术语改成你想要的固定译法,比如指定 Prompt 保留英文不翻、Agent 统一译为「智能体」,再进入批量精校。
额度与订阅提示:一条一小时的播客或课程视频往往包含 800 至 1500 条字幕,需要多轮分批精校与脚本回填校验,免费账户很容易中途触发对话限速或代码沙盒次数耗尽。国内无外币卡用户可通过本站 ChatGPT Plus 充值指南、ChatGPT Plus 续费直充 或免交密码的 ChatGPT Plus 卡密兑换 稳定扩容额度。
三、第二步:带上下文锁定编号的精校翻译提示词
确认术语表后,按批次让 ChatGPT 精校翻译(每批 60–100 条最稳,长输出续写技巧可配合 ChatGPT 分段结构化输出与无损续写指令)。复制下面这条精校提示词:
text
术语表已确认如下:
- [在此粘贴你确认后的术语对照表]

现在请读取沙盒中第 1 批字幕(id 1 至 80),严格按照以下要求输出双语精校结果(仅输出 JSON 数组,每项包含 `id`、`en_clean`、`zh` 三个字段):
1. 严格保持条目总数与原始 `id` 一一对应,严禁合并、拆分、增删任何一条 `id`;
2. `en_clean`:仅修正明显语音识别错词与缺失标点,保持口语原意,不擅自改写长短;
3. `zh`:结合前后相邻 2 条字幕的完整语境翻译成自然流畅的中文口语字幕;如果一个长英文句跨了两条字幕,请按中文阅读习惯合理分配到对应的两条 `zh` 中,禁止把整句全塞进前一条而让后一条留空;
4. 单条中文尽量控制在 22 个汉字以内,删去多余句末句号和冗余语气词,适合手机竖屏与横屏阅读;
5. 翻译完第 1 批后,请把结果存入沙盒变量并汇报「已完成 id 1–80,校验条目数 80/80 无缺失」,等待我指令继续下一批。
这里最关键的设计是把「跨条长句拆分」与「禁止留空」写进硬规则,同时通过编号总数校验确保一条不丢。若任务很长想更省额度,可按 ChatGPT 任务拆分与省额度技巧 合并同主题轻度校对步骤。
四、第三步:用 Python 无损回填时间轴并自动质检导出
所有批次翻译完毕后,让 ChatGPT 运行脚本把 en_clean 和 zh 严格回填回原始时间轴,并一次性导出可下载的双语字幕文件:
text
全部批次的 `id`、`en_clean`、`zh` 已经完成。请运行 Python 脚本将译文无损回填到原始 episode01.srt 的时间轴中,并完成以下校验与导出:
1. 生成两份 UTF-8(无 BOM)可下载文件:
   - `episode01_bilingual_zh_top.srt`(中文在上、英文在下)
   - `episode01_zh_only.srt`(纯中文字幕)
2. 如果是 `.vtt` 源文件,保留首行 `WEBVTT` 及原有 cue 样式属性,时间码毫秒维持英文句点;如果是 `.srt` 文件,确保序号从 1 连续递增、时间码毫秒维持英文逗号、段落间有且仅有一个空行;
3. 自动运行质检报告:输出总条数是否与原文件 100% 相等、是否存在空译文条目、列出中文超过 26 字的偏长条目编号,方便我做最后微调。
下载后把 .srt 或 .vtt 直接拖进剪映、Premiere、Final Cut Pro 或本地播放器,时间轴和音画能够做到毫秒级对齐。
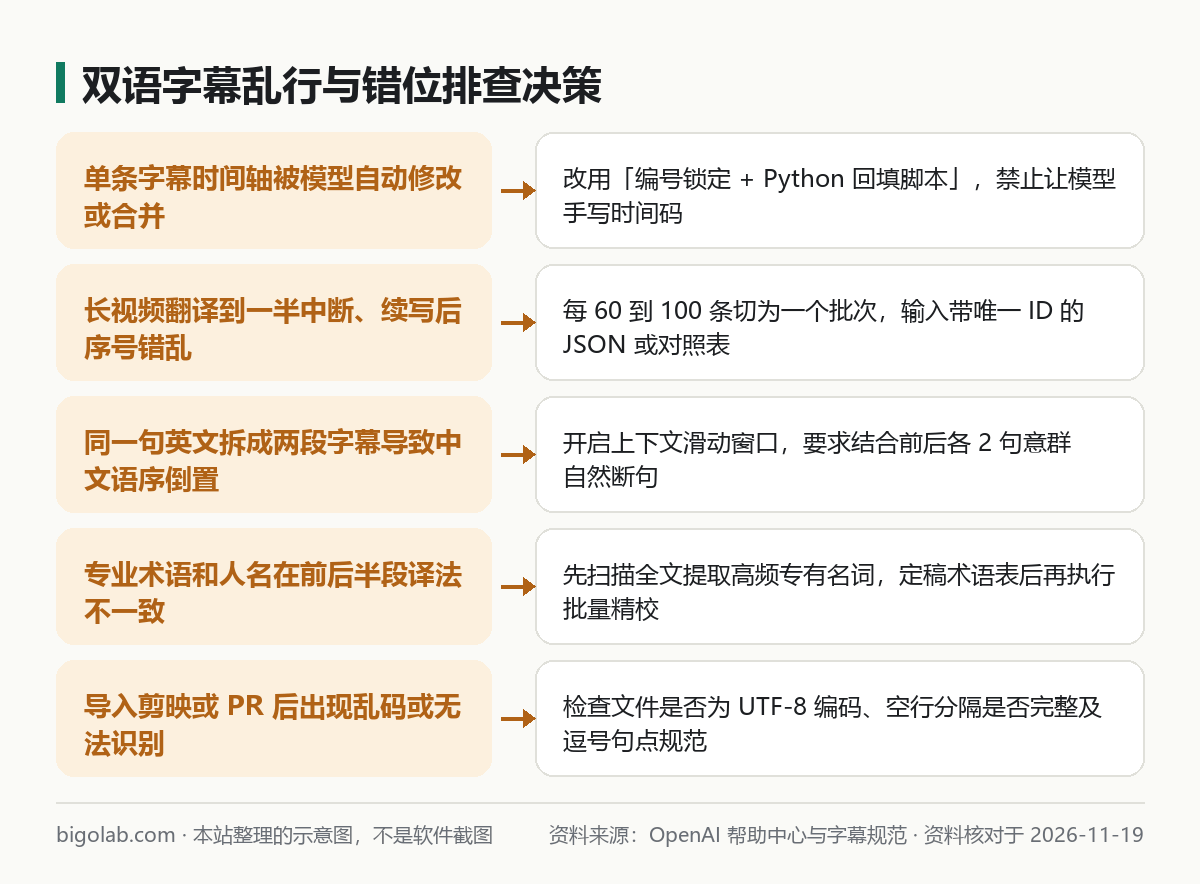
图:本站根据 OpenAI 帮助中心:Data analysis with ChatGPT 整理的示意图
常见问题
问:为什么不直接让 ChatGPT 写一个 Python 脚本在沙盒里调用翻译 API,而是让我分批在对话里翻?
答:ChatGPT 的内置 Python 沙盒默认处于无外网访问隔离环境,无法直接对外调用外部翻译接口。因此最优分工是「沙盒里的 Python 负责切块、组装、校验格式与导出下载,对话里的 ChatGPT 主模型负责结合上下文做高质量语义精校翻译」。
问:视频里有多位嘉宾轮流发言,字幕里出现 [Speaker 1] 或换行符 -\s 怎么保留?
答:在第一步解析脚本里明确说明「保留行首说话人前缀或 - 对话横杠标记,并在中译文对应位置补齐 - 」,同时不要删掉 HTML 样式标签(如斜体 <i>)或让脚本在解析时先提取标签、回填时再包回去。
问:导出的双语字幕导入剪映或某些播放器后中文显示乱码怎么办?
答:多数情况下是文件编码问题。在导出脚本中明确指定使用 utf-8-sig(带 BOM 的 UTF-8,对 Windows 旧版播放器与部分剪辑软件兼容性更好)或标准 utf-8,并检查换行符是否统一为 \r\n 或 \n 即可解决。
问:国内没有外币卡,怎么稳定开通 ChatGPT Plus / Pro 或团队版以解锁多文件上传与高阶模型?
答:可前往本站 AI 会员充值总览 选择 ChatGPT Plus 充值专区 获取日常长字幕解析与 Python 沙盒额度;若你是日更视频工作室或长播客团队,需要超高上下文与重度推理配额,可进一步查看 ChatGPT Pro 充值方案 或直接下单 ChatGPT Pro 会员直充。站内支持支付宝、微信支付与 AlipayHK,免外币卡即可稳定订阅。实时价格以页面展示为准;订阅期内若掉订阅按剩余天数折退,因违反官方条款导致的封号不在质保范围内。
相关教程
- 用 ChatGPT 快速拆解长视频与播客要点:提取字幕、按时间轴总结与反问提炼核心观点
- ChatGPT 翻译怎么用:整篇文档翻译、翻译指令与术语表
- ChatGPT 音频转文字:上传录音生成文字稿、会议纪要与摘要
- ChatGPT 回答写到一半截断、点继续又衔接错位怎么办:分段结构化输出与无损续写指令
- ChatGPT Work(工作模式)怎么用最省额度:任务拆分、中途纠偏与成品文档/PPT/表格实战
参考资料
- OpenAI 帮助中心:File Uploads FAQ — https://help.openai.com/en/articles/8555545-file-uploads-faq
- OpenAI 帮助中心:Data analysis with ChatGPT — https://help.openai.com/en/articles/8437071-data-analysis-with-chatgpt
- W3C 规范:WebVTT: The Web Video Text Tracks Format — https://www.w3.org/TR/webvtt1/
0 条评论
还没有评论,来抢沙发~