
结论先说
- 百页 PDF 一把传上去直接问「帮我总结全文」,漏页几乎是必然的:按 OpenAI 文件处理机制,超长文档往往通过后台分块检索(按关键词捞取最相关的若干片段)进入对话,而不是把 300 页逐字平铺进单次上下文(上下文容量边界见 ChatGPT 上下文长度与记忆限制说明)。
- 「编造页码」大多有两个真凶:一是模型只看到了检索片段却没拿到真实页脚编号于是自己估算页码,二是封面与目录占了十几页,导致「PDF 阅读器物理页码」和「正文印刷页码」天生错位。
- 防漏页的核心铁律就三条:「先验可复制文本 + 按 20–40 页拆章 + 强制附 15 字以上原文引句」:只要模型给出逐字原文引句,你在本地 PDF 阅读器里
Ctrl+F搜索,3 秒就能验证它到底有没有编造。 - 遇到纯扫描件标书或模糊盖章页,先 OCR 再上传:直接把几百页图片型 PDF 扔给 ChatGPT 极易报无法提取文本或看串数字(排查与转换方法见 扫描版 PDF 无法提取文本 OCR 修复指南)。
- 长文档高频分析档位入口:单月常规分析论文或标书可在 ChatGPT Plus 充值专题页 选择 ChatGPT Plus iOS 订阅通道卡密;如果每天连读多份数百页招股书、需要更大文件并发与高阶推理配额,直接看 ChatGPT Pro 充值专题页。
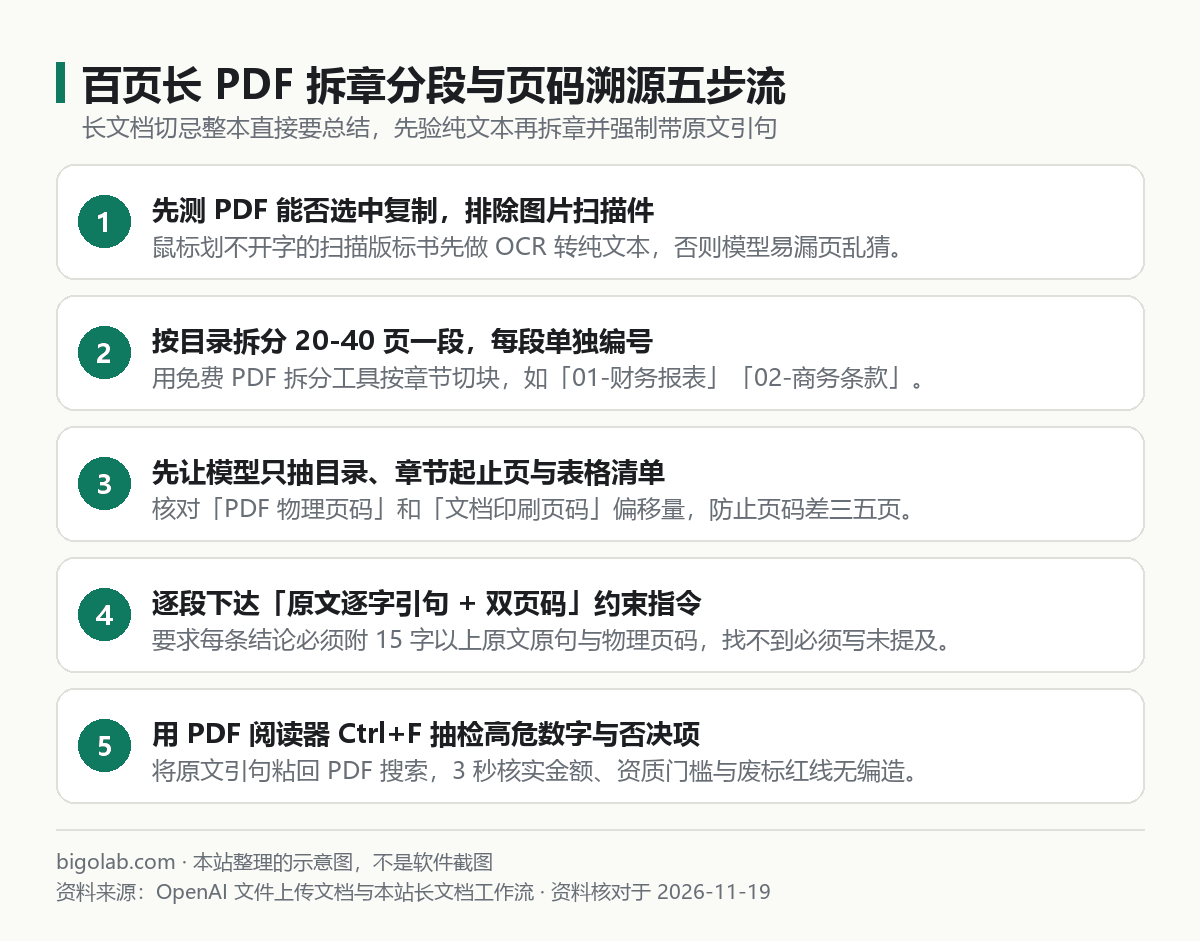
图:本站根据 OpenAI File Uploads FAQ 与本站长文档实战整理的示意图
本文根据 OpenAI 帮助中心《File Uploads FAQ》《File storage and library in ChatGPT》《OpenAI Academy: Working with Files》及本站长文档实务整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 需要通读 100–400 页招股书、上市公司年报、招标文件或硕博长论文,怕模型跳过关键废标条款或核心实验数据的职场人与研究生;
- 吃过「ChatGPT 信誓旦旦说在第 68 页,翻开第 68 页完全是另一件事」的亏,想彻底杜绝编造页码的人;
- 上传整本 PDF 后发现表格数字错行、或者系统提示无法提取正文文本的文档分析用户。
一、五步防跳页漏读与防编造页码工作流
处理任何超过 50 页的重要 PDF(尤其是标书、尽调材料和长论文),本站建议放弃「整本一锅炖」,严格按这五步推进(基础 PDF 提炼技巧另见 ChatGPT 总结 PDF 文档指南):
- 先做 10 秒文本体检,排除扫描图片件:在电脑打开 PDF,用鼠标拖选正文和表格里的几行数字,看能否顺利选中并复制成正常中文。如果点上去整页变蓝或粘出来全是乱码,立刻先用本地 OCR 工具转为可检索文本 PDF 再继续。
- 按目录把长 PDF 拆成 20–40 页一段的章节文件:把 200 页招股书或标书按大目录拆成 5–7 个小文件(例如
01-投标人须知_P1-35.pdf、02-商务与废标项_P36-70.pdf)。拆完后每个小文件完全落入模型高精度通读区间,不再依赖碎片化抽样。 - 先让模型用 Python 解析脚本提取「物理页码 + 章节锚点」:上传拆分后的章节文件时,让它优先借助内置代码解释器逐页读取文本并核对页码偏移量,避免「阅读器第 18 页」和「书页脚第 5 页」混为一谈。
- 每章必加「原文逐字引句 + 找不到写未提及」防编造模板:
text
请逐页通读这份拆分章节 PDF(如可用,请用 Python 脚本逐页提取文本核对),提取所有与 [废标条件/违约责任/核心财务假设] 相关的条款,严格按以下四列输出表格:
1. 条款要点(不超过 40 字);
2. PDF 物理页码(第几页)与正文印刷页码;
3. 原文逐字摘录(必须直接复制文档内 15-30 字连续原句,严禁改写);
4. 风险等级或备注。
规则:严禁推测或补全文档未写明的信息;如果本章节未出现相关内容,请直接回复「本章节未提及」。- 本地
Ctrl+F抽检与多章归并:拿到每章表格后,把高风险条目的「原文逐字摘录」粘进本地 PDF 阅读器按Ctrl+F核验。能搜到就 100% 真实无误;搜不到立刻定位并人工补看。所有分章表审完后,另开一个干净的新对话,把各章核验通过的纯文本表格合在一起做最终总览,避免单次对话过长忘掉前面章节。
开通与选购提示:法务、投研或咨询从业者频繁拆分处理上百页长文档时,Plus 单日文件与高阶模型次数较易见顶(差异见 ChatGPT Plus 与 Pro 档位区别)。当前已有在期 Plus 需要立刻顶掉扩容可选 ChatGPT Pro 5x iOS 可覆盖档,已退回 Free 的干净空白号可选 ChatGPT Pro 5x 信用卡不可覆盖档,日均超大文档批处理重度用户可看 ChatGPT Pro 20x 充值档位,实时售价均以页面标价为准。
二、漏页、读歪表格或编造页码排障分流
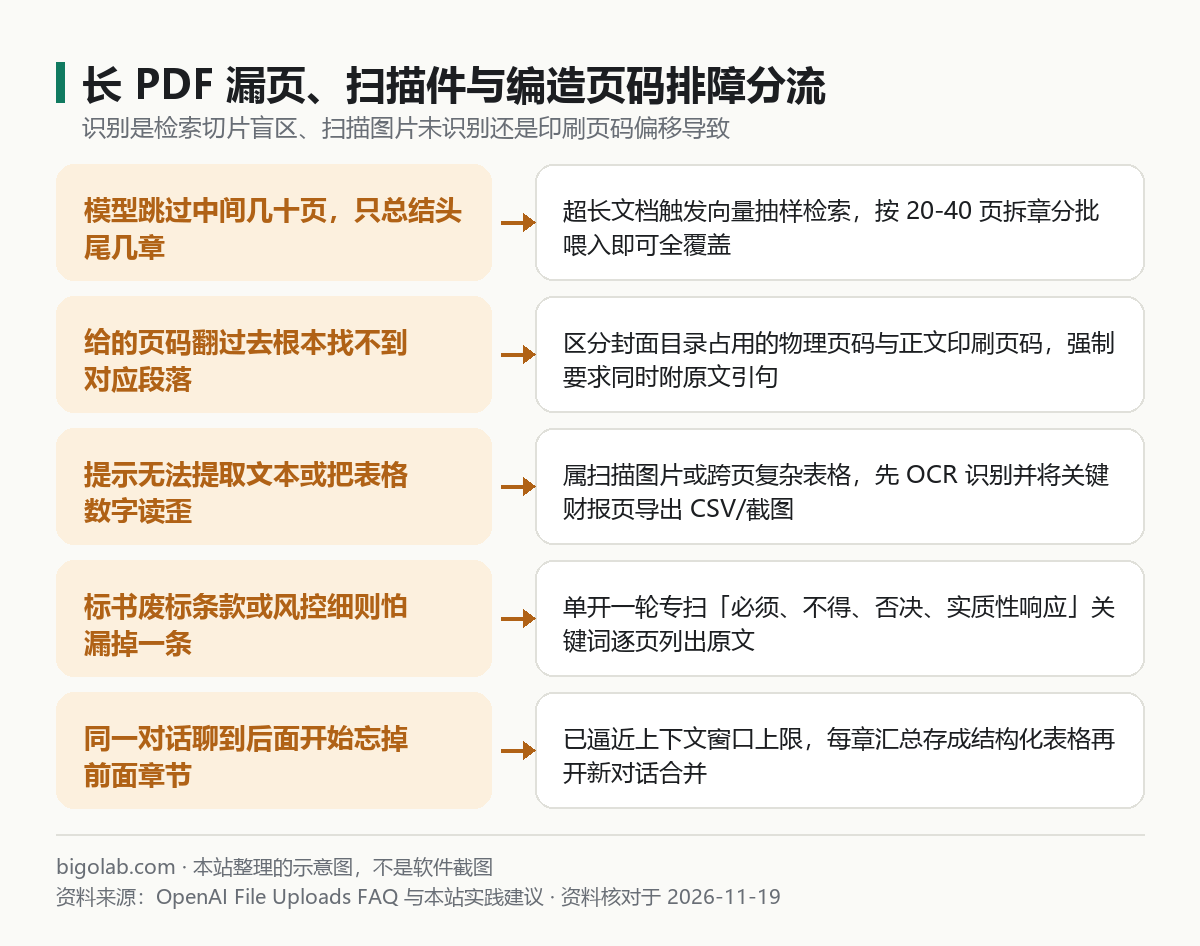
图:本站根据 OpenAI Working with Files 与实务排障经验整理的示意图
尤其提醒标书和招股书读者:跨页合并单元格的财务大表是所有大模型最容易读错行的薄弱环节。涉及营收、毛利率、报价上限表等关键数字页,最稳的做法是把那 2–3 页表格单独截图或转成 Excel/CSV 再上传,并让模型做行列加总交叉校验,把算术错误挡在交付之前。
常见问题
问:为什么有时候我在同一个对话里连传了 5 个章节 PDF,到第 4 个就开始张冠李戴?
答:这是长对话上下文拥挤造成的注意力稀释。本站建议把每个重要章节的提取结果复制保存到本地文档,每跑完 2–3 个章节就开一个新对话继续后续章节,最后再把提炼好的结构化摘要汇总分析,准确度远高于在一个百轮超长窗口里死磕。
问:用 ChatGPT 读公司涉密标书或未公开招股书,数据会不会被拿去训练模型?
答:个人 Plus / Pro 账号默认需在「Settings > Data Controls」手动关闭模型训练选项;如果文档涉及严格商业保密义务,优先对客户名和报价做脱敏处理,或者使用默认「业务数据不用于模型训练」的 ChatGPT Business 团队工作空间。
问:国内没有外币卡怎么开通 ChatGPT Plus / Pro / Business,可否开具增值税发票报销及售后规则?
答:前往本站 AI 会员充值总览 即可用支付宝、微信支付或 AlipayHK 自助下单,免海外信用卡且免交账号密码,所有档位实时价格以页面标价为准。个人干净空白号日常用首选 ChatGPT Plus 信用卡通道自助卡密,3 人以上法务、投研或教研团队需要保密工作区、对公转账与服务合同请对接 ChatGPT Business 团队定制。全线均支持由国内经营主体开具增值税发票(标价不含税,另付 6% 税费;收据不加税)。售后遵循公示条款:未使用卡密可按规则退换,已核销卡密不退;订阅期内非自身原因掉订阅按剩余天数折退,封号不在质保范围。
相关教程
- ChatGPT 怎么总结长 PDF 文档:上传限制、分段方法与提问技巧
- ChatGPT 提示无法提取 PDF 文本怎么办:扫描版文档 OCR 识别修复
- ChatGPT 上下文长度限制是多少:长对话失忆原因与分段策略
- ChatGPT Plus 与 Pro 档位区别:额度、深度研究与适用人群对比
0 条评论
还没有评论,来抢沙发~