
结论先说
- 安全第一铁律:只读限制必须在「数据库账号与引擎层」硬锁死,绝不能只靠提示词或 MCP 的只读参数。早期部分开源数据库 MCP 实现曾曝出多语句拼接绕过只读检查的隐患,只有数据库角色本身缺乏写权限,才构成真正的硬防线。
- 严禁直连生产主库,优先连本地脱敏库、预发库或只读从库。并同时配置语句超时(如
10s)防止一条缺索引的全表扫描打满数据库 CPU。 - 凭据一律通过系统环境变量 +
env_vars注入,绝不把密码明文写进项目config.toml。详细config.toml字段与加载层级可参考 /guides/codex-mcp-config 与 /guides/codex-config-toml-complete-guide。 - 让 Codex 只读查结构、看执行计划,但把优化结果输出成仓库里的 SQL 迁移脚本。禁止通过 MCP 直接在线建索引或改表结构,所有 DDL 变更必须走团队正常代码审查与发布流程。
- 连续分析多表 Schema、解读复杂执行计划与改写 ORM 代码会频繁占用上下文额度。国内缺少外币卡或原套餐限额不足时,可在本站按需开通 ChatGPT Plus 充值 或更高配额的 ChatGPT Pro 充值,团队协作可了解 ChatGPT Business 团队定制。
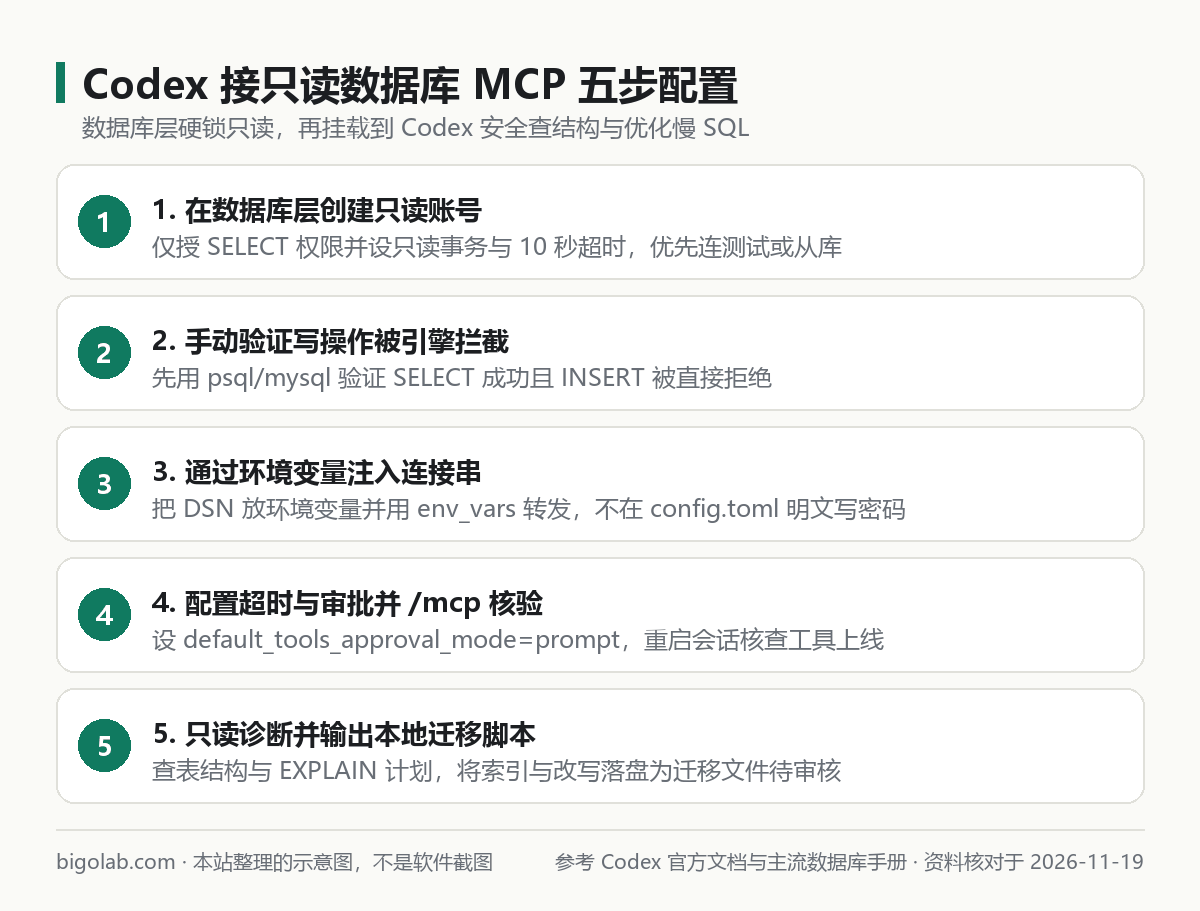
图:本站根据 OpenAI Codex MCP 文档 及三款数据库安全规范整理的示意图
本文根据 OpenAI Codex 官方文档《Model Context Protocol》《Configuration Reference》及 PostgreSQL、MySQL、SQLite 官方权限与连接文档整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 写复杂联表查询或排查慢接口时,需要反复手动复制
CREATE TABLE、索引定义和执行计划给 Codex 的后端与数据研发; - 想把 PostgreSQL、MySQL 或本地 SQLite 通过 MCP 接进 Codex,同时死守「绝对不能误删改数据、不能拖慢生产主库」红线的团队;
- 担心在
config.toml里明文写死数据库密码泄露凭据的开发者。
一、第一步:在数据库层建立硬只读账号(三库实操)
无论选用哪款活跃维护的开源数据库 MCP 服务端(注意早期官方示例 @modelcontextprotocol/server-postgres 仓库已归档,建议选用当前持续维护的数据库 MCP 包或官方兼容发行版),接入前都必须先配好最小权限只读身份:
1. PostgreSQL:专用只读角色 + 会话级强保护
sql
CREATE ROLE ai_reader LOGIN PASSWORD 'replace-with-strong-password';
GRANT CONNECT ON DATABASE app_staging TO ai_reader;
GRANT USAGE ON SCHEMA public TO ai_reader;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO ai_reader;
ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO ai_reader;

-- 强制会话默认只读并限制单条 SQL 最长执行 10 秒
ALTER ROLE ai_reader SET default_transaction_read_only = ON;
ALTER ROLE ai_reader SET statement_timeout = '10s';
ALTER ROLE ai_reader SET idle_in_transaction_session_timeout = '30s';
2. MySQL 8+:仅授予目标库 SELECT 与查看视图权限
sql
CREATE USER 'ai_reader'@'127.0.0.1' IDENTIFIED BY 'replace-with-strong-password';
GRANT SELECT, SHOW VIEW ON app_staging.* TO 'ai_reader'@'127.0.0.1';
FLUSH PRIVILEGES;
建议把该账号指向只读从库或独立测试库,并在会话或服务端开启 max_execution_time 超时保护。
3. SQLite:URI 只读标志 + 副本隔离
本地排查 SQLite 时,优先拷贝一份快照文件(如 ./tmp/app-readonly.db),连接字符串显式带上官方只读模式参数 file:./tmp/app-readonly.db?mode=ro,并在系统文件权限上设为只读。
建完账号后,先用命令行客户端(psql / mysql / sqlite3)手动验证一次 SELECT 成功且 INSERT / DELETE 被数据库拒绝,再进行下一步。
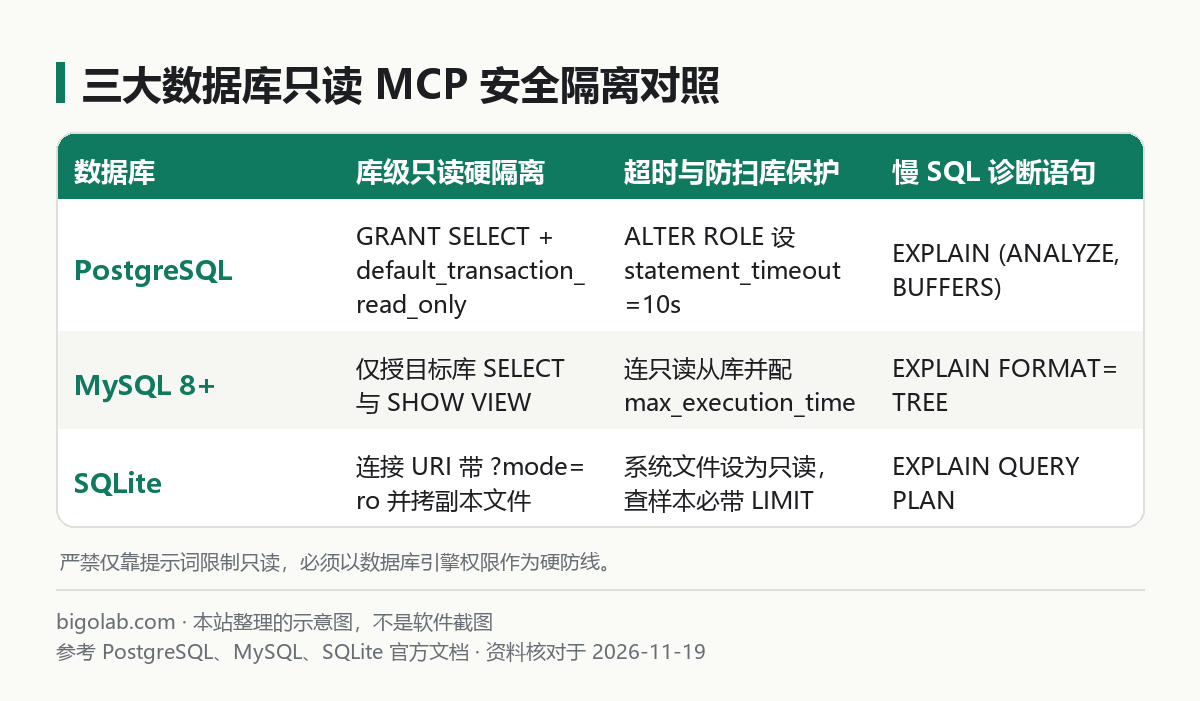
图:本站根据三款数据库官方文档整理的安全配置对比示意图
二、第二步:在 ~/.codex/config.toml 安全挂载数据库 MCP
不要把数据库密码直接硬编码在配置里。先在当前终端导出环境变量(例如 export STAGING_PG_DSN="postgresql://ai_reader:[email protected]:5432/app_staging"),再在 ~/.codex/config.toml 中通过 env_vars 转发给 MCP 子进程(以支持环境变量读取连接串的数据库 MCP 为例,具体包名与参数请以所选维护中项目的最新文档为准):
toml
[mcp_servers.staging_db]
command = "npx"
args = ["-y", "@bytebase/dbhub", "--transport", "stdio", "--readonly"]
env_vars = ["DSN"]
startup_timeout_sec = 30
tool_timeout_sec = 30
default_tools_approval_mode = "prompt"
enabled = true
启动 Codex 前将 STAGING_PG_DSN 赋给 DSN 即可,或在只针对个人本机使用的 ~/.codex/config.toml(确保不提交到 Git 且权限仅当前用户可读)里配置独立隔离的本地测试库。进入会话后输入 /mcp,确认只读查询与表结构读取工具已经上线;若连接失败或报环境变量缺失,可对照 /guides/codex-mcp-connection-failed-no-tools-fix 排查。
订阅与账号准备提示:当表数量较多、执行计划嵌套很深且需要同步重构后端 ORM 代码时,单次任务会消耗较多配额(额度规则见 /guides/codex-usage-limits)。重度后端与数据调优可在本站升级 ChatGPT Pro 5x iOS 可覆盖档 或 ChatGPT Pro 5x 信用卡不可覆盖档;新账号首次开通 Codex 若卡在手机验证步骤,可查看 Codex 注册手机验证服务。
三、第三步:查表结构与慢 SQL 优化的标准提示词规范
为防止 Codex 顺手查出上万行明文业务数据塞爆上下文或暴露用户隐私,本站建议在提示词和 AGENTS.md 中固定三条查询规矩:先查元数据、抽样必带 LIMIT 5、分析走 EXPLAIN 而不拉原始隐私列。
text
请使用 staging_db MCP 排查仓库 src/repositories/orderRepo.ts 中 listOrdersByMerchant 的慢查询问题:
1. 先读取 orders 与 order_items 两张表的字段定义、现有索引与近似行数(不要拉取用户手机号、邮箱等隐私列);
2. 对该查询执行只读 EXPLAIN(PostgreSQL 可用 EXPLAIN (ANALYZE, BUFFERS),MySQL 可用 EXPLAIN FORMAT=TREE,SQLite 可用 EXPLAIN QUERY PLAN),找出全表扫描、回表或排序瓶颈;
3. 结合业务过滤条件和排序字段,给出建议新增的复合索引(含最左前缀列顺序说明)与改写后的 SQL / ORM 代码;
4. 严禁尝试执行任何建索引或改表语句,请将建议的索引 DDL 写入本地新迁移文件草案中等待我人工审查。
同时保持 default_tools_approval_mode = "prompt"(工具审批与沙箱边界见 /guides/codex-permissions-sandbox),每次 Codex 准备发 SQL 前你都能肉眼确认语句安全无越界。
常见问题
问:PostgreSQL 执行 EXPLAIN ANALYZE 会真的把语句跑一遍,会不会有风险?
答:EXPLAIN ANALYZE 确实会实际执行该查询以统计真实耗时与扫描页数。如果误对 UPDATE/DELETE 跑 EXPLAIN ANALYZE 会真的改写数据——这正是本文强调必须在数据库层用 default_transaction_read_only = ON 和纯 SELECT 账号硬隔离的原因,即便模型误写改数据语句也会被引擎直接拦截,同时 statement_timeout 能防止大查询长时间占用资源。
问:为什么不建议把公司 200 张表的完整 DDL 一次性让 Codex 全查一遍?
答:一次性拉取上百张表结构会瞬间吃掉大量上下文窗口并消耗高额配额,还会降低模型对关键表的注意力。正确方式是先告知 Codex 相关业务模块涉及的 3 到 5 张核心表名,按需查询目标表及其关联外键表即可。
问:国内没有外币信用卡,或后端团队需要统一采购开具增值税发票,怎么开通 ChatGPT / Codex 订阅?
答:可通过本站 AI 会员充值总览 按需选购 ChatGPT Plus、ChatGPT Plus 自助卡密 或高配额 ChatGPT Pro,支持支付宝、微信支付及 AlipayHK,提供卡密自助兑换(无需交出账号密码)与客服协助,并支持开具增值税发票;多人研发团队也可咨询 Business 团队定制方案。实时价格以商品页展示为准,售后遵循掉订阅按剩余天数折退、封号不在质保范围规则。
相关教程
- Codex 怎么配置 MCP:codex mcp add 命令与 config.toml 写法
- Codex config.toml 完整详解:文件层级、常用键与 profiles 切换
- Codex MCP 连接失败或找不到工具怎么办:超时与环境变量排查
- Codex 权限与沙箱设置:审批模式与安全边界
参考资料
- OpenAI Codex 官方文档:Model Context Protocol — https://learn.chatgpt.com/docs/extend/mcp
- OpenAI Codex 官方文档:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- PostgreSQL 官方文档:CREATE ROLE — https://www.postgresql.org/docs/current/sql-createrole.html
- MySQL 8.4 官方文档:Privileges Provided by MySQL — https://dev.mysql.com/doc/refman/8.4/en/privileges-provided.html
- SQLite 官方文档:Uniform Resource Identifiers — https://www.sqlite.org/uri.html
0 条评论
还没有评论,来抢沙发~