
结论先说
--output-schema <路径>用于强制约束codex exec的最终输出结构。按官方文档说明,传入 Schema 文件后,模型在标准输出(stdout)返回的最终结果会严格匹配定义好的字段名与类型。- 它和
--json参数用途完全不同。--output-schema把最终答案变成单个业务 JSON 对象;而--json是把整个执行期间的会话启动、工具调用和消息输出变成逐行 JSONL 事件流。 - 编写 Schema 时每个对象层级都要写严约束。参照 OpenAI 结构化输出规范,根对象及嵌套对象均需设置
additionalProperties为false,并把当前层所有属性列入required数组。 - 提取报告时建议搭配
--sandbox read-only。只读沙箱能防止 Codex 在分析过程中修改业务代码,保证流水线检查安全可控。 - 自动化审查流水线对账号额度消耗较集中。国内缺少外币卡或绑卡受阻的用户,可在本站自助开通 ChatGPT Plus 或更高额度的 ChatGPT Pro,团队集中采购可咨询 ChatGPT Business 团队定制。
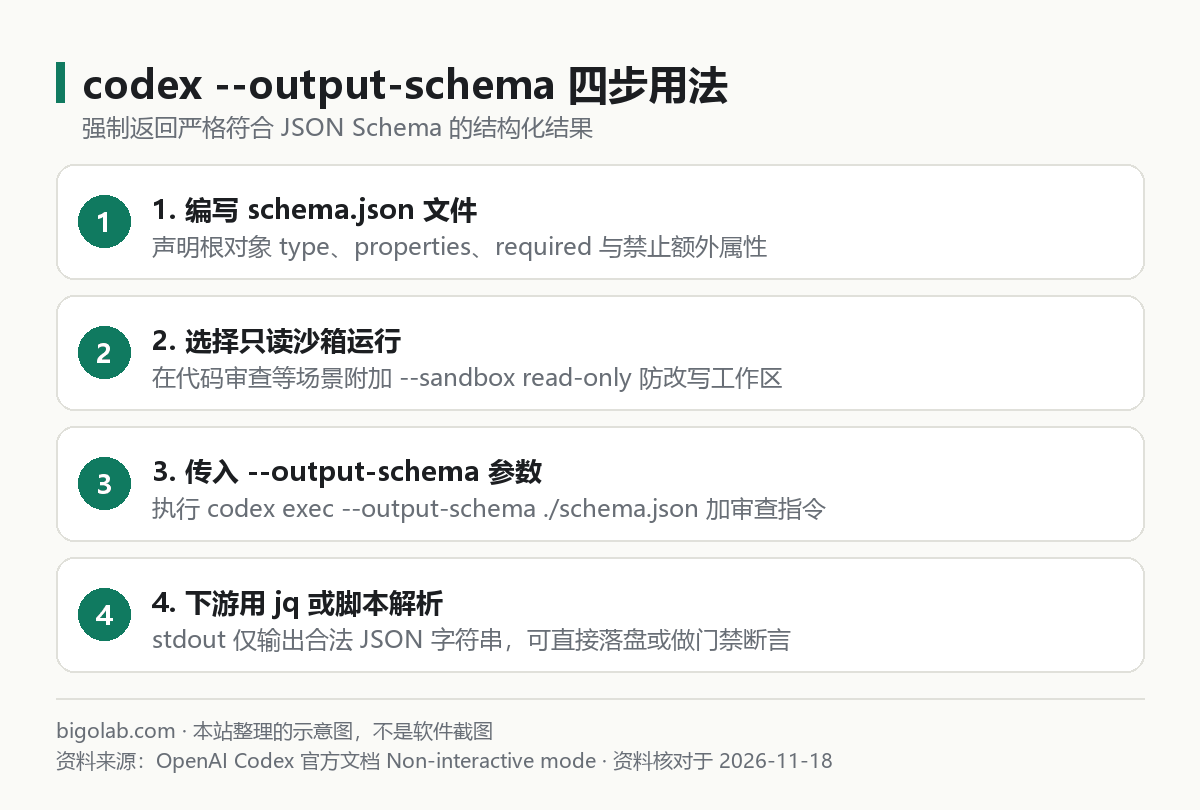
图:本站根据 OpenAI Codex 官方文档:Non-interactive mode 整理的示意图
本文根据 OpenAI Codex 官方文档《Non-interactive mode》《Command line options》及 OpenAI API《Structured Outputs》指南整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 在 GitHub Actions、GitLab CI 或本地脚本里调用
codex exec,需要下游程序稳定解析返回字段的开发者; - 用提示词要求只输出 JSON,却仍偶发遇到多余代码块围栏或字段缺漏的人;
- 分不清
codex exec里--output-schema与--json两个参数各自用途的用户。
一、--output-schema 与 --json 参数对比
查阅命令帮助(见 /guides/codex-cli-commands-cheatsheet)时容易混淆这两个选项,核心差异如下:
| 对比项 | --output-schema ./schema.json | --json |
|---|---|---|
| 输出格式 | 单个符合自定义 Schema 的 JSON 对象 | 多行换行分隔的 JSONL 系统事件流 |
| 关注重点 | 业务结论的字段结构(如问题列表、严重级别) | 运行全链路轨迹(思考、读文件、跑命令事件) |
| 下游解析方式 | 直接交给 jq 或脚本 json.load 解析 | 按行流式读取并过滤末尾完成事件 |
| 典型场景 | 自动生成审查单、变更元数据、风险评级卡 | 自研外部监控面板、审计代理每一步动作 |
若业务脚本只关心最终审查结论,直接使用 --output-schema 最稳妥。底层 Schema 语法规则可参考 /guides/openai-api-structured-outputs。
二、实战步骤:提取标准格式代码审查报告
第 1 步:生成 review-schema.json
在项目根目录用 Python 生成标准 Schema 文件,确保根类型为 object 且所有属性列入 required:
python
import json

schema = dict(
    type='object',
    additionalProperties=False,
    required=['passed', 'summary', 'issues'],
    properties=dict(
        passed=dict(type='boolean'),
        summary=dict(type='string'),
        issues=dict(
            type='array',
            items=dict(
                type='object',
                additionalProperties=False,
                required=['file', 'line', 'severity', 'reason'],
                properties=dict(
                    file=dict(type='string'),
                    line=dict(type='integer'),
                    severity=dict(type='string', enum=['high', 'medium', 'low']),
                    reason=dict(type='string'),
                ),
            ),
        ),
    ),
)
json.dump(schema, open('review-schema.json', 'w', encoding='utf-8'), indent=2)
第 2 步:结合 git diff 执行审查并做门禁判断
bash
git diff origin/main...HEAD | codex exec \
  --sandbox read-only \
  --output-schema ./review-schema.json \
  "审查当前分支相对于 main 的变更。存在 high 级别缺陷时将 passed 设为 false,用中文填写 summary 与 reason。" \
  > review-report.json

jq -e '.passed == true' review-report.json >/dev/null || exit 1
专用审查命令对比也可查看 /guides/codex-code-review。
订阅与账号准备提示:在本地和脚本里批量跑结构化代码审查会持续占用模型推理配额。遇到额度见底时,可在本站自助升级 ChatGPT Pro 充值 或选用 ChatGPT Pro 5x 空白号档;日常轻量审查开通 ChatGPT Plus 会员 即可满足需求。
三、常见 Schema 报错与排错决策
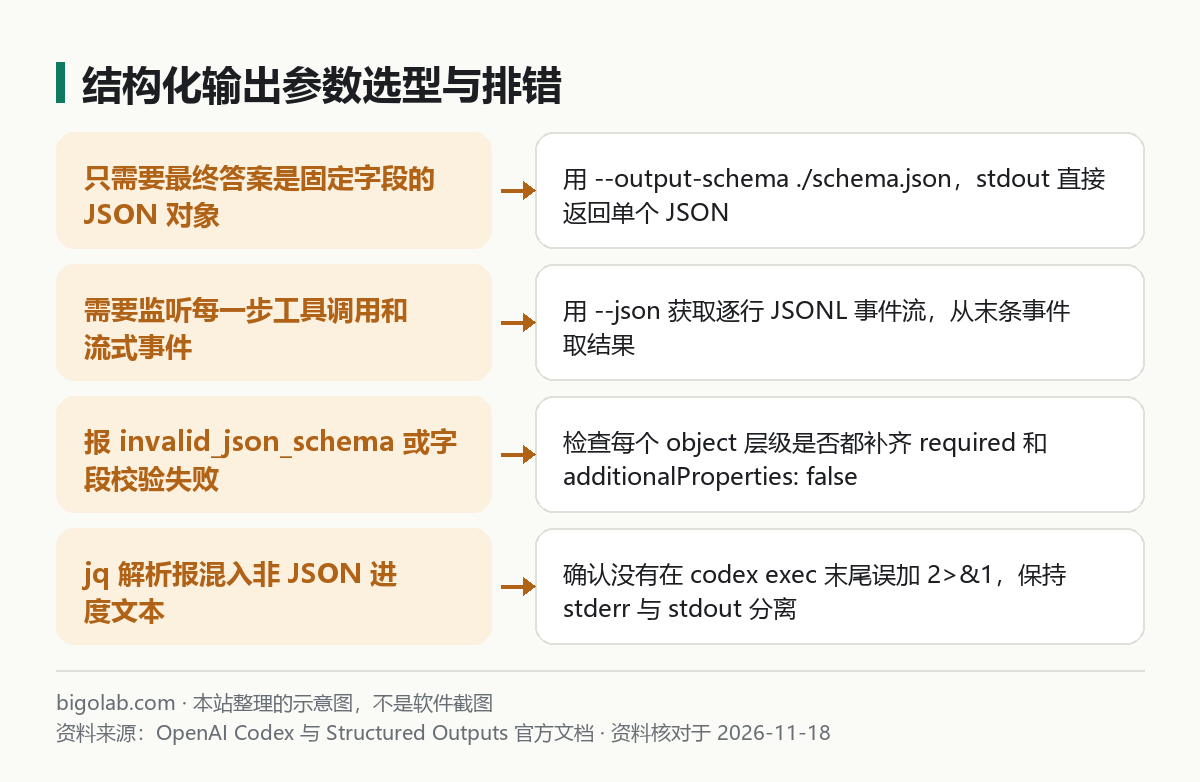
图:本站根据 OpenAI Structured Outputs 官方指南 整理的示意图
遇到命令报错或解析失败时(更多错误见 /guides/codex-common-errors-summary),按三点核查:
- 报
invalid_json_schema400 错误:通常是嵌套对象漏写了additionalProperties: false,或properties里的字段未全部放进required。需要可空字段时,把类型设为['string', 'null']并保留在required中。 - 根节点写成了
array:结构化输出顶层必须是object,返回列表时包一层issues属性即可。 - 输出文件混入进度日志:检查是否在
codex exec右侧误加了2>&1。保持默认分离才能让stdout只输出纯 JSON。 - 字段描述(
description)写得含糊导致取值偏离预期:虽然 Schema 能锁死字段名和数据类型,但对于评分口径、严重等级划分标准等语义边界,建议在每个属性的description字段中用一两句中文写清判定依据(例如明确写出「仅当可导致线上崩溃、数据越权或资金计算错误时标为 high,代码风格建议一律标为 low」),能显著减少误报拦截。 - 超长差异导致响应缓慢或超时:当合并请求包含自动生成的锁文件(如
package-lock.json、pnpm-lock.yaml)或编译产物时,直接将全量git diff塞进管道会拖慢审查速度;上游命令可用路径排除语法(如git diff origin/main...HEAD -- . ':(exclude)lock')提前过滤无关文件。
常见问题
问:--output-schema 支持所有 JSON Schema 校验语法吗?
答:它遵循 OpenAI Structured Outputs 支持子集,基础类型、enum 枚举、嵌套对象与数组均支持;若包含不受支持的关键字,接口会返回 400 并指出具体字段。
问:能不能用命令行参数直接指定输出文件路径?
答:可以。除标准输出重定向外,官方命令参考中 codex exec 也支持输出文件选项,具体参数名可运行 codex exec --help 核对当前 CLI 版本。
问:国内没有境外信用卡,或团队需要开增值税发票报销,怎么开通订阅?
答:可前往本站 AI 会员充值总览 选用 ChatGPT Plus 或 ChatGPT Pro,支持支付宝、微信支付及 AlipayHK 结算,提供卡密自助兑换(无需交出密码)与团队定制,支持开具增值税发票。实时价格以页面显示为准;售后遵循掉订阅按剩余天数折退、封号不在质保范围的规则。
相关教程
参考资料
- OpenAI Codex 官方文档:Non-interactive mode — https://learn.chatgpt.com/docs/non-interactive-mode
- OpenAI Codex 官方文档:Command line options — https://learn.chatgpt.com/docs/developer-commands
- OpenAI API 官方文档:Structured Outputs — https://platform.openai.com/docs/guides/structured-outputs
0 条评论
还没有评论,来抢沙发~