
结论先说
- 想直接肉眼看选
chat.html,想按关键词秒搜或二次处理选conversations.json。两者存的是同一批历史对话,只是一个排成了静态网页,一个是原始结构化数据。 chat.html超过二三十 MB 时浏览器很容易卡死,因为它把你几年来的所有对话一次性渲染在同一张网页里;用记事本或 VS Code 直接打开几百 MB 的单行conversations.json同样会卡顿。- 重度用户的压缩包里可能没有单个
conversations.json,而是conversations-000.json、conversations-001.json等多个编号文件——这是官方在数据量大时的自动分片。 - **最稳妥的检索办法是用本地 Python 脚本流式读取
conversations.json*,遍历里面的mapping节点树,把包含关键词的对话单独存成几 KB 的.md文件,离线执行、不联网、不泄露隐私。 - 国内免境外卡开通入口:若没有境外银行卡或遇到支付被拒,可在本站通过支付宝、微信支付或 AlipayHK 自助获取兑换码开通 ChatGPT Plus 或 ChatGPT Pro,团队多席位支持联系客服定制 ChatGPT Business 团队版。
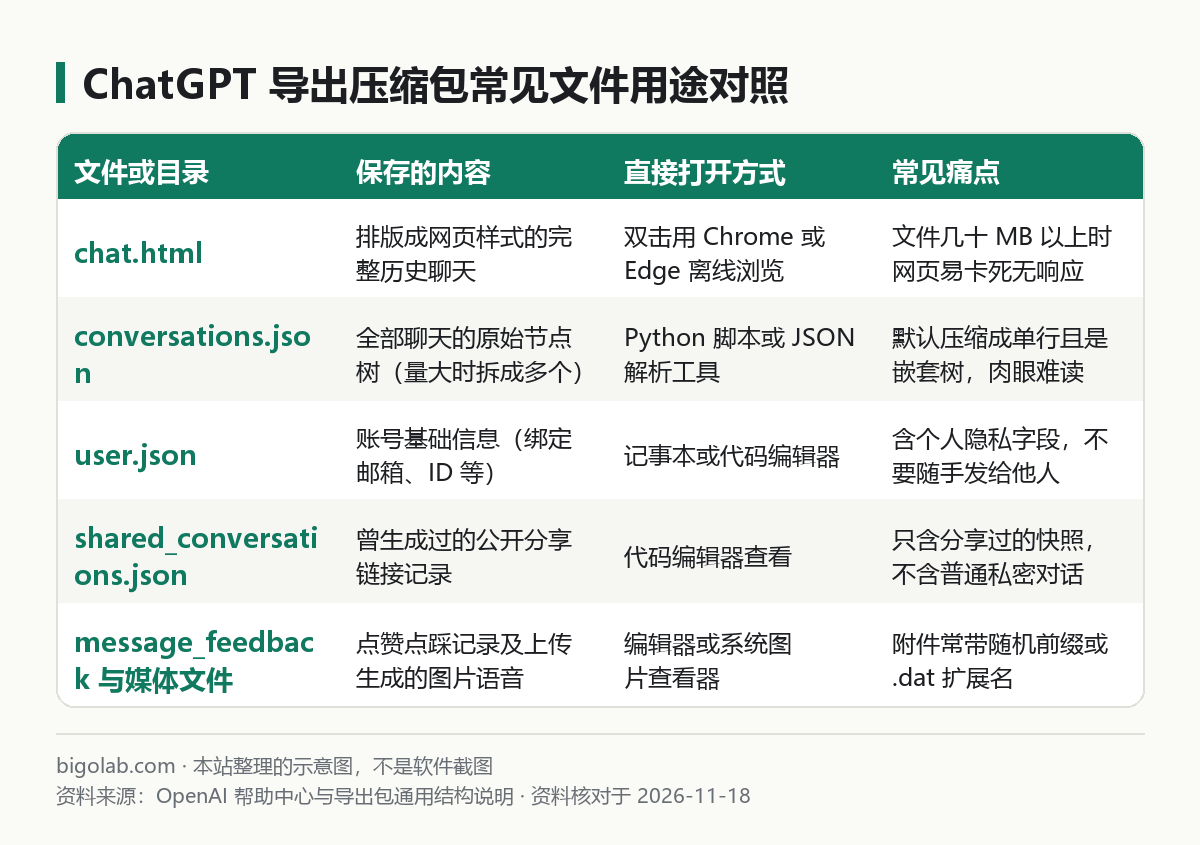
图:本站根据 OpenAI 帮助中心:Exporting your ChatGPT history and data 整理的示意图
本文根据 OpenAI 帮助中心《Exporting your ChatGPT history and data》《Transfer exported conversations between ChatGPT accounts》整理,并补充导出包本地解析方法,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 已经从邮件下载并解压了 ChatGPT 导出的 ZIP 压缩包,看着一堆
.json和.html文件不知道点哪个的人; - 双击
chat.html后浏览器一直转圈、白屏或提示「页面无响应」,根本没法按关键词查旧对话的人; - 想从几百兆的
conversations.json里挑出某几段重要历史记录,转成干净的 Markdown 保存或传给新账号参考的人。
还没申请导出、或者没收到下载邮件的读者,请先看前置步骤教程:ChatGPT 聊天记录怎么导出:申请步骤与下载链接说明。
一、解压后的目录里都有什么文件
先把下载回来的 .zip 完整解压到一个普通文件夹(不要直接在压缩软件预览窗口里双击文件,否则大文件容易解压不全或路径报错)。OpenAI 帮助中心说明包内包含聊天记录及其他相关账号数据,常见文件如下:
chat.html:把所有对话拼在一起的离线网页文件,不需要联网即可在 Chrome、Edge、Safari 中浏览。conversations.json(或带编号的多个 JSON):核心对话数据库。每条对话包含标题(title)、创建与修改时间戳,以及一个叫mapping的树形字典——因为 ChatGPT 支持「重新生成回答」和「修改提问产生分支」,所以消息不是简单数组,而是靠父子节点 ID 串起来的树。user.json:账号注册邮箱、用户 ID 等基础资料,含个人隐私,备份时注意保管。shared_conversations.json:你在账号里点过「分享(Share)」生成的链接快照记录。message_feedback.json:你给某条回答点过赞或点过踩的反馈记录。- 图片、语音或
dalle-generations等子目录:对话中上传过的附件、生成的图片或语音片段(部分文件带file-前缀或.dat扩展名)。
如果你本来只想把当前某一个正在聊的对话存成文档,不必每次都走长达数天的全量导出,日常单聊保存方法见 ChatGPT 单个对话怎么导出。
二、chat.html 怎么打开、卡死怎么办
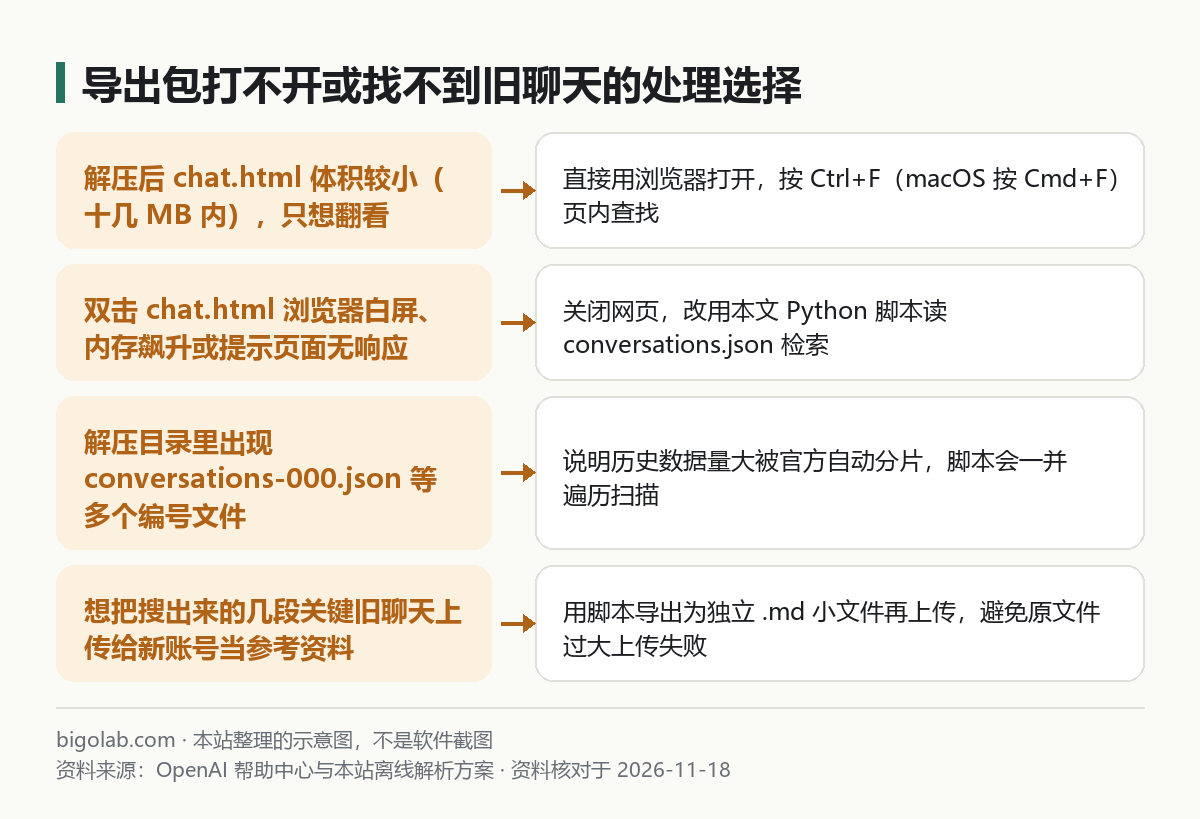
图:本站根据 OpenAI 帮助中心:Transfer exported conversations between ChatGPT accounts 与本站离线解析方案整理的示意图
- 轻量记录(
chat.html在 20 MB 以内):右键选 Chrome 或 Edge 打开,等几秒钟加载完毕后,按快捷键Ctrl + F(macOS 按Cmd + F)输入关键词即可定位。 - 大体积记录(几十 MB 到几百 MB):浏览器需要一次性创建数十万个网页节点,内存占用会瞬间飙到几个 GB 并弹出「页面无响应(Page Unresponsive)」。这时不要硬等,直接关掉标签页,改用下一节的 Python 脚本解析
conversations.json。
三、用 Python 脚本检索 conversations.json 并导出 Markdown
下面这段脚本只用到 Python 自带标准库(无需 pip install 任何第三方包),会自动扫描同目录下的 conversations.json 或所有分片 conversations-*.json,顺着每段对话当前激活的 current_node 还原完整上下文,按关键词筛出匹配的对话并导出为干净的 Markdown 文件。
操作步骤
- 确认电脑已安装 Python 3(终端输入
python --version或python3 --version能看到版本号); - 在解压出来的文件夹里新建一个
search_chats.py,粘贴以下代码并保存:
python
import glob, json, os, re
from datetime import datetime

KEYWORD = "装修预算"  # 改成你要搜的关键词;留空字符串 "" 则导出全部对话
OUT_DIR = "matched_markdown"

def extract_messages(conv):
    mapping = conv.get("mapping") or {}
    node_id = conv.get("current_node")
    chain = []
    while node_id and node_id in mapping:
        node = mapping[node_id]
        msg = node.get("message")
        if msg and msg.get("author", {}).get("role") in ("user", "assistant"):
            parts = (msg.get("content") or {}).get("parts") or []
            text = "\n".join(p for p in parts if isinstance(p, str)).strip()
            if text:
                chain.append((msg["author"]["role"], text))
        node_id = node.get("parent")
    chain.reverse()
    return chain

os.makedirs(OUT_DIR, exist_ok=True)
files = sorted(glob.glob("conversations*.json"))
if not files:
    raise SystemExit("当前目录下没找到 conversations*.json,请把脚本放进解压目录运行")

kw = KEYWORD.lower()
count = 0
for fp in files:
    with open(fp, "r", encoding="utf-8") as f:
        data = json.load(f)
    for conv in data:
        title = (conv.get("title") or "未命名对话").strip()
        msgs = extract_messages(conv)
        full_blob = title + "\n" + "\n".join(t for _, t in msgs)
        if kw and kw not in full_blob.lower():
            continue
        count += 1
        ts = conv.get("create_time")
        date_str = datetime.fromtimestamp(ts).strftime("%Y-%m-%d") if ts else "unknown-date"
        safe_title = re.sub(r'[\\/:*?"<>|]+', "_", title)[:50]
        out_path = os.path.join(OUT_DIR, f"{date_str}_{count:04d}_{safe_title}.md")
        with open(out_path, "w", encoding="utf-8") as out:
            out.write(f"# {title}\n\n- 创建日期:{date_str}\n\n---\n\n")
            for role, text in msgs:
                speaker = "提问" if role == "user" else "ChatGPT"
                out.write(f"### {speaker}\n\n{text}\n\n")

print(f"扫描完成,共导出 {count} 段匹配对话到 ./{OUT_DIR}/ 目录")- 在该文件夹下打开终端(Windows 可在资源管理器地址栏输入
powershell回车),运行:
powershell
python search_chats.py
几秒钟后,文件夹下会生成 matched_markdown 目录,里面每一篇都是按「创建日期 + 标题」命名的 .md 文件,用任意笔记软件(如 Obsidian、Typora 或记事本)都能秒开。
四、搜出来的旧对话怎么传给新账号接着用
按 OpenAI 官方《Transfer exported conversations between ChatGPT accounts》文档说明,ChatGPT 不支持把导出包导回侧边栏恢复成历史列表,但支持把导出的文件作为附件上传到新账号的对话或项目里当背景资料。
相比直接把几百 MB 的原始 conversations.json 硬传上去(很容易触发单文件大小或上下文截断限制),用上面的脚本先把相关主题的几段对话筛出来存成几个小 .md 文件,再传进新账号的「项目(Projects)」里提问,准确率高得多。如果新账号需要更高的文件上传限额、更长的上下文窗口或多人共享项目空间,可以在本站开通 ChatGPT Plus,团队协同场景也可以了解 ChatGPT Business 团队版定制。
常见问题
问:在 conversations.json 里搜不到某段记得很清楚的对话,是怎么回事?
分两种情况:一是你在申请导出前已经手动删掉了那段对话,官方明确说明已删除的记录无法通过导出恢复;二是对话还在账号里,但用的是临时聊天(不会留存),或者你搜的词恰好在图片附件里而非纯文字中。若怀疑只是在网页侧边栏被隐藏了,可按 ChatGPT 归档聊天查找与恢复教程 检查。
问:脚本里的 current_node 是什么意思,会不会漏掉我点过「重新生成」的旧版回答?
current_node 指向你在那段对话最后停留在的那个分支末端,顺着它往回找 parent 得到的正是你在网页上看到的那条完整主线。如果你连废弃分支里的旧回答也想找出来,可以把脚本改为直接遍历 mapping.values() 里的所有节点。
问:账号里的「记忆(Memory)」和自定义指令在哪看?
自定义指令包含在导出数据包的相关配置字段中;如果你只是想整理或迁移日常积累的个人记忆条目,直接在网页设置里复制更直观,操作方法见 ChatGPT 记忆已满:导出、清理与迁移教程。
问:国内没有境外信用卡,怎么开通或续费 ChatGPT Plus / Pro?
答:可在本站使用支付宝、微信支付或 AlipayHK 下单获取卡密自助兑换(支持 ChatGPT Plus、Pro 5x 可覆盖档 与 Pro 5x 空白号档),实时价格、兑换前提与售后规则(掉订阅按剩余天数折退,封号不在质保范围)以对应页面说明为准。
相关教程
- ChatGPT 聊天记录怎么导出:导出数据步骤、下载链接与迁移到新账号
- ChatGPT 单个对话怎么导出:导出 PDF、Markdown、Word 有哪些办法
- ChatGPT 聊天记录不见了怎么办:归档的聊天在哪、怎么搜索和恢复
- ChatGPT 记忆已满怎么办:导出、清理、迁移与关闭记忆
参考资料
- OpenAI 帮助中心:Exporting your ChatGPT history and data — https://help.openai.com/en/articles/7260999-exporting-your-chatgpt-history-and-data
- OpenAI 帮助中心:Transfer exported conversations between ChatGPT accounts — https://help.openai.com/en/articles/9106926-transfer-exported-conversations-between-chatgpt-accounts
0 条评论
还没有评论,来抢沙发~