
结论先说
- 价格直接打五折:官方 Batch API 的输入与输出 token 单价均为标准实时调用价格的 50%,不要求毫秒级响应的离线任务都值得切过来。
- 目标完成时间在
24 小时以内:任务提交后进入后台异步队列,大多数中小型批次几分钟到几十分钟就能跑完,但不承诺实时返回,不能拿来接在线聊天框。 - 小批量用内联列表,大批量传
JSONL文件:总请求体小于20 MB的几百条数据可直接传数组;几万条规模的大任务先用 Files API 上传.jsonl(最大2 GB),跑完下载结果文件按key对齐。 - 文本生成与 Embeddings 向量都支持批处理:除了
generateContent批任务,官方文档也提供了批量生成向量的异步接口。 - 谷歌账号准备与多工具订阅入口:使用 Gemini、Google AI Studio 与 Antigravity 需具备符合地区与年龄要求的个人谷歌账号,缺号可查看本站 谷歌账号购买说明(含带 2FA 的 谷歌邮箱成品号),跨平台付费订阅总览见 AI 会员充值中心。
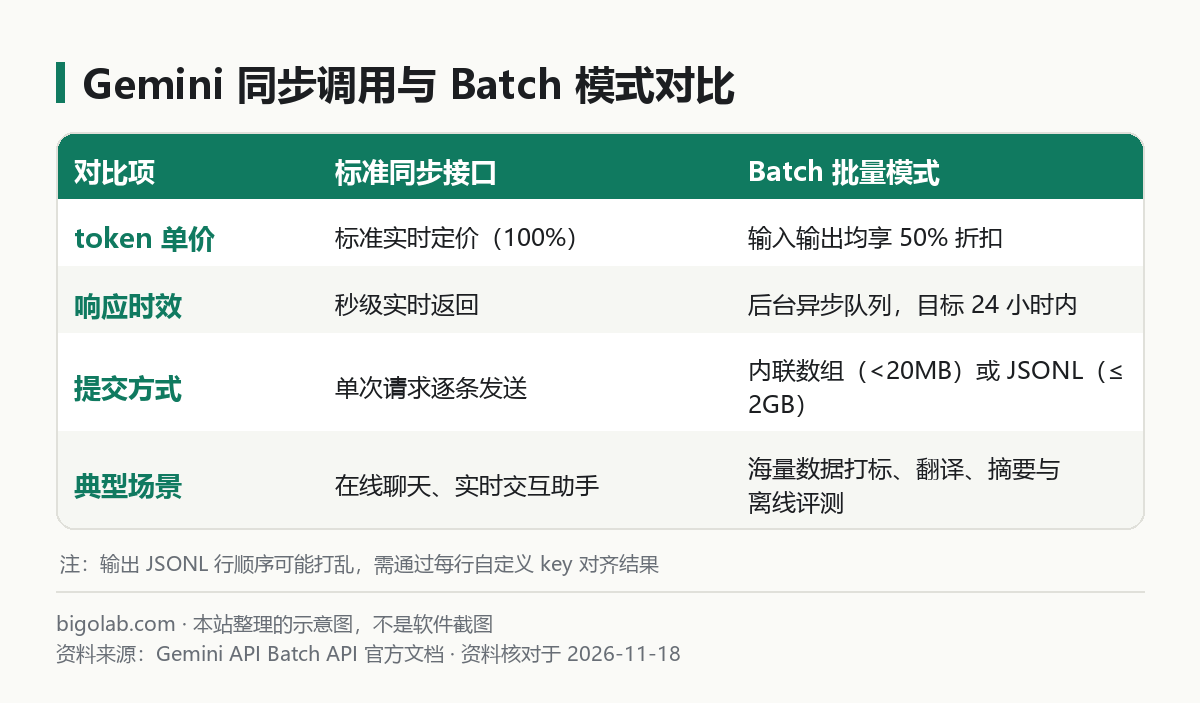
图:本站根据 Gemini API 官方文档:Batch API 整理的示意图
本文根据 Google AI for Developers 官方文档《Batch API》《Gemini Developer API pricing》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Google 官方网站。
适用于谁
- 要批量处理几千到几十万条商品打标、文本翻译、情感分类、数据集蒸馏或离线评测的开发者;
- 经常在并发跑脚本时撞上同步接口
429 RESOURCE_EXHAUSTED速率限制,想改成异步队列稳妥跑完的人; - 搜「gemini api batch 批量请求」,想对比内联请求(Inline)与
.jsonl文件两种写法怎么选的人。
一、什么时候该用 Batch Mode,两种提交方式怎么选
在实时接口里开多线程硬刷大批量数据,既容易触发每分钟请求数(RPM)限流,又要付全价。只要业务符合「结果晚几十分钟甚至几小时出来也不影响」的特征——例如夜间定时清洗评论库、给全站旧文章补摘要、跑模型提示词基准评测——就应该改走 client.batches。
官方 SDK 提供两种入参方式,选型标准很明确:
| 对比项 | 内联提交(Inline Requests) | JSONL 文件提交(File Input) |
|---|---|---|
| 传入方式 | 代码里直接传请求字典列表 | 先拼 .jsonl 文件,经 Files API 上传后传文件引用 |
| 体积边界 | 适合总载荷 小于 20 MB 的轻量批次 | 单文件支持最大 2 GB,适合生产级海量数据 |
| 结果对齐 | 按返回数组顺序一一对应 | 每行自带唯一 key,输出乱序也能精准还原 |
| 结果获取 | 直接读 batch_job.dest.inlined_responses | 调用 client.files.download 下载输出 .jsonl |
如果你同时也在评估其他大模型的离线批处理接口,可以横向对照本站整理过的 OpenAI Batch API 批量请求教程 与 Claude API Message Batches 教程。
二、写法一:几百条小任务直接用内联请求
还没配置好运行环境的开发者,请先完成 Gemini API Python SDK 安装与密钥配置。数据量不大时,不用落盘写临时文件,直接把多条请求塞进 src 列表创建任务即可:
python
import time
from google import genai

client = genai.Client()

inline_requests = [
    {"contents": [{"parts": [{"text": "把这段评价归类为正面或负面:发货很快,包装严实。"}]}]},
    {"contents": [{"parts": [{"text": "把这段评价归类为正面或负面:用了两天就充不进电了。"}]}]},
]

batch_job = client.batches.create(
    model="gemini-2.5-flash",
    src=inline_requests,
    config={"display_name": "review-sentiment-demo"},
)
print("已创建批任务:", batch_job.name)

completed_states = {"JOB_STATE_SUCCEEDED", "JOB_STATE_FAILED", "JOB_STATE_CANCELLED", "JOB_STATE_EXPIRED"}
while batch_job.state.name not in completed_states:
    time.sleep(15)
    batch_job = client.batches.get(name=batch_job.name)

if batch_job.state.name == "JOB_STATE_SUCCEEDED":
    for idx, resp in enumerate(batch_job.dest.inlined_responses):
print(f"第 {idx + 1} 条结果:", resp.response.text)谷歌开发账号与主力编程订阅提示:若当前账号卡在地区不支持、手机核验或工作空间限制,可在本站选购已配置两步验证的 谷歌账号成品号(即时发货,质保首登,到手请按指引先登后改密);日常搭配主力模型开发,也可同步了解免境外卡自助兑换的 ChatGPT Plus 与 Claude Pro。
三、写法二:生产级大批量用 JSONL 文件提交与取回
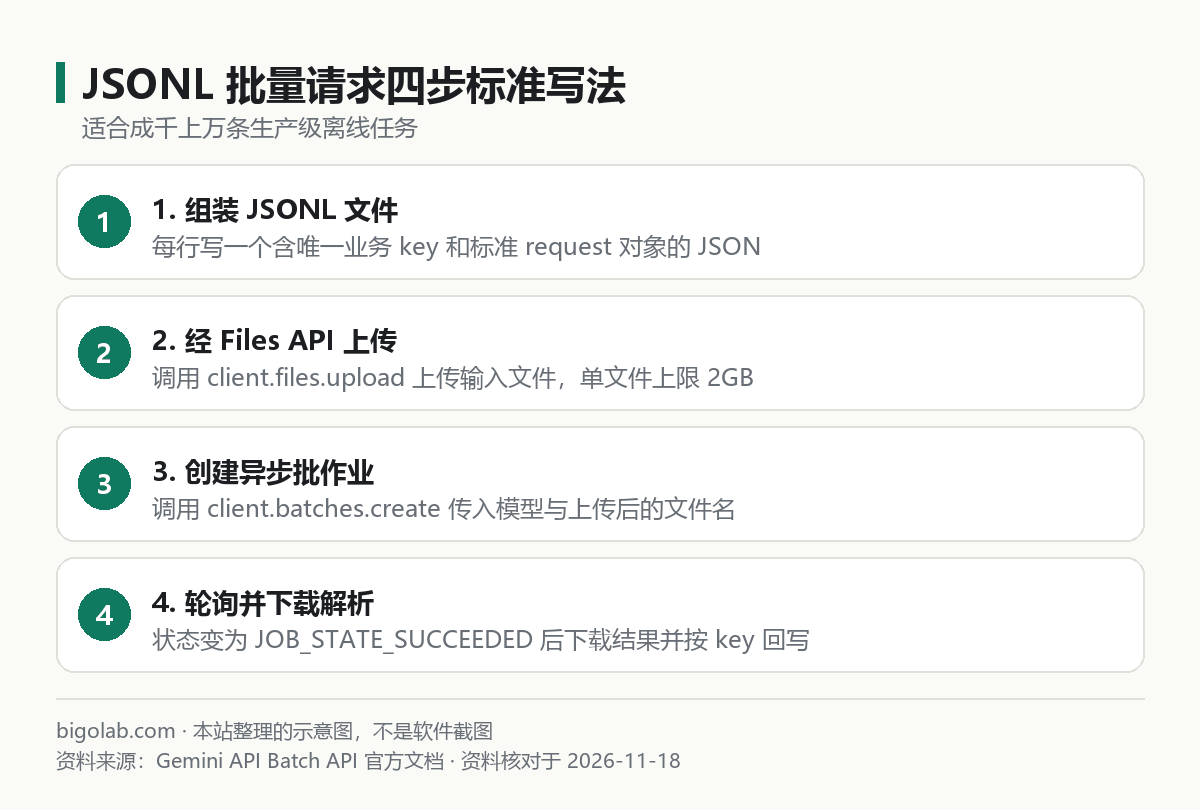
图:本站根据 Gemini API 官方文档:Batch API 整理的示意图
跑成千上万条记录时,建议用 JSON Lines(.jsonl)格式:一行一个独立 JSON 对象,包含自定义业务主键 key(如订单号)和标准 request 体。注意同一批次所有行共用创建作业时指定的模型:
json
{"key": "item-1001", "request": {"contents": [{"parts": [{"text": "提取关键词:无线降噪蓝牙耳机续航40小时"}]}]}}
{"key": "item-1002", "request": {"contents": [{"parts": [{"text": "提取关键词:机械键盘红轴热插拔三模连接"}]}]}}
上传文件、启动批处理并在完成后下载解析结果的完整代码:
python
import json, time
from google import genai
from google.genai import types

client = genai.Client()

uploaded_input = client.files.upload(
    file="batch_input.jsonl",
    config=types.UploadFileConfig(display_name="product-kw-input", mime_type="jsonl"),
)

job = client.batches.create(
    model="gemini-2.5-flash",
    src=uploaded_input.name,
    config={"display_name": "product-kw-job"},
)

done_states = {"JOB_STATE_SUCCEEDED", "JOB_STATE_FAILED", "JOB_STATE_CANCELLED", "JOB_STATE_EXPIRED"}
while job.state.name not in done_states:
    time.sleep(30)
    job = client.batches.get(name=job.name)

if job.state.name == "JOB_STATE_SUCCEEDED":
    raw_bytes = client.files.download(file=job.dest.file_name)
    for line in raw_bytes.decode("utf-8").splitlines():
        if not line.strip():
            continue
        row = json.loads(line)
        if "response" in row:
            text = row["response"]["candidates"][0]["content"]["parts"][0]["text"]
            print(row.get("key"), "=>", text.strip())
        else:
print(row.get("key"), "单条失败:", row.get("error"))由于后台分布式并发执行,输出文件行顺序不一定与输入一致,解析时请按每行的 key 字段回写数据库。
四、任务管理、计费前提与注意事项
- 计费层级与预付费准备:Batch API 面向开启结算的项目提供高吞吐配额与五折单价;开通计费、预充值(Prepay)与设预算上限见 Gemini API 计费与预付费设置教程,各模型价格见 Gemini API 价格速查。需要准备独立谷歌账号绑定项目时,可参考本站 谷歌账号购买页。
- 取消与清理:任务还在排队时可调用
client.batches.cancel(name=job.name)取消;跑完后用client.batches.delete(name=job.name)清理记录。 - 及时下载结果文件:Files API 托管文件默认保留期有限(通常 48 小时),任务变为
JOB_STATE_SUCCEEDED后请及时把结果下载落盘。
常见问题
问:一批 JSONL 里如果混进了几条异常数据,会导致整批全部失败吗?
答:不会整批作废。只要输入 JSONL 语法合法成功入队,单条请求失败会在输出对应行返回 error 对象,其余正常行照常返回 response。
问:Batch Mode 里能用结构化 JSON 输出(response_schema)和系统指令吗?
答:可以。在每行 request 对象的配置与 system_instruction 字段里按标准结构写入即可,批量抽取字段建议加上 JSON Schema。
问:为什么提交后一直显示 JOB_STATE_PENDING?
答:这代表作业正在异步资源池排队。官方目标周转窗口是 24 小时内,高峰期排队数十分钟至数小时均属正常;若超 24 小时未完成则会过期且不对未完成部分扣费。
问:没有可用的个人谷歌账号,或者同时想开其他主流 AI 会员怎么办?
答:本站提供即买即发的 谷歌邮箱成品号(登录方法见 谷歌账号购买页),同时支持支付宝、微信支付与 AlipayHK 自助充值 ChatGPT Plus、Claude Code 等主流服务,实时价格与质保细则以各商品页说明为准。
相关教程
- Gemini API 怎么收费:按 token 计费、预付费充值与支出上限设置
- Gemini API 价格:各模型每百万 tokens 多少钱、免费层和付费层差在哪
- Gemini API 429 错误怎么解决:RESOURCE_EXHAUSTED 原因与排查表
- OpenAI Batch API 批量请求怎么用:50% 折扣与 24 小时规则对比
- Claude API 批量请求(Message Batches)用法与计费规则
参考资料
- Gemini API 官方文档:Batch API — https://ai.google.dev/gemini-api/docs/batch-api
- Gemini Developer API pricing — https://ai.google.dev/gemini-api/docs/pricing
0 条评论
还没有评论,来抢沙发~