
结论先说
- 加一个参数即可异步执行:在
responses.create请求里传background=True,接口会立刻返回带resp_前缀的响应 ID 和初始状态,无需一直占着网络连接苦等。 - 硬性前提是允许服务端存储:Background 模式要求
store=True(默认值);如果业务开启了零数据保留(ZDR)或传了store=False,接口会报错拒绝。 - 取回结果有两条正路:生产环境优先配平台 Webhook 监听
response.completed等事件;本地脚本或内网服务则每隔几秒调用responses.retrieve(id)轮询,直到脱离queued和in_progress。 - 本地断开不代表服务端停机:直接关掉终端或跳出轮询循环,OpenAI 后台仍会继续跑完并扣费;确定不要结果时必须显式调用
responses.cancel(id)。 - 它不打折但即时排队:Background 按标准 API 单价计费,图的是分钟级在线任务防超时;若是成千上万条不着急的离线任务想省一半费用,应选 Batch API。
- 国内免境外卡开通入口:若没有境外银行卡或遇到支付被拒,可在本站通过支付宝、微信支付或 AlipayHK 自助获取兑换码开通 ChatGPT Plus 或 ChatGPT Pro,团队多席位支持联系客服定制 ChatGPT Business 团队版。
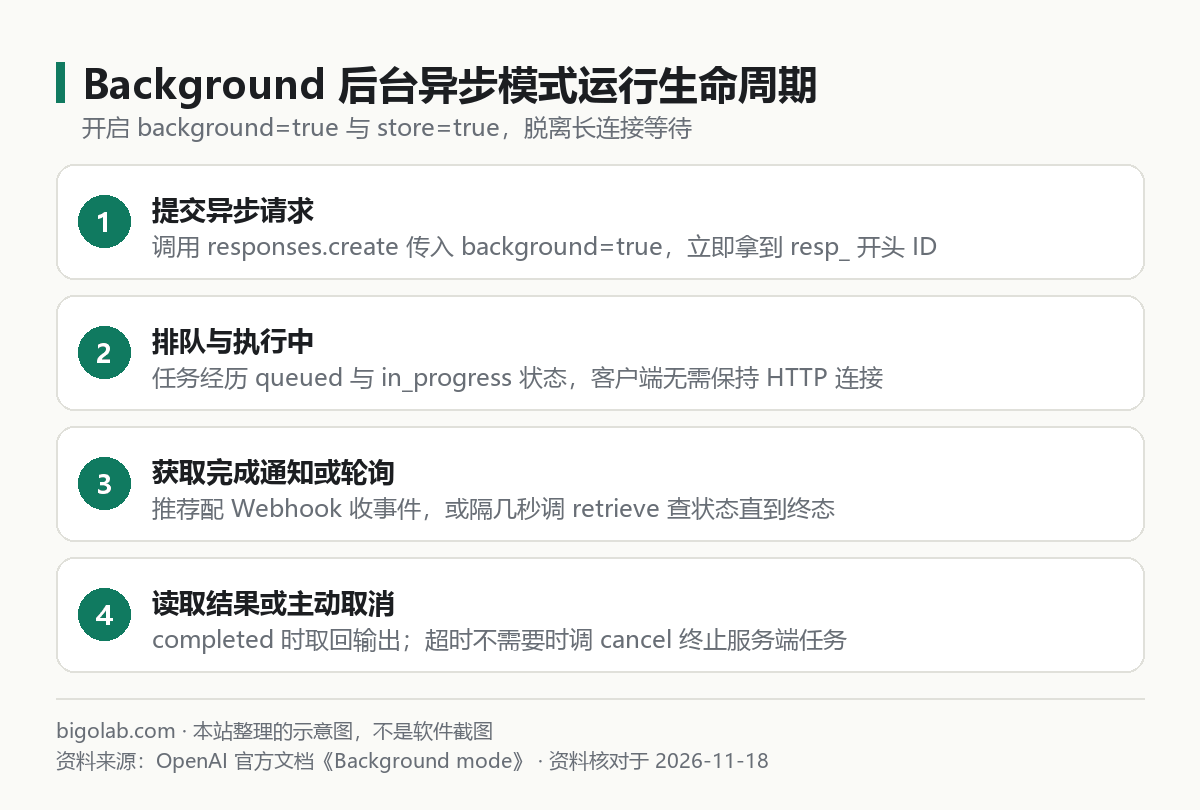
图:本站根据 OpenAI 官方文档:Background mode 整理的示意图
本文根据 OpenAI 官方文档《Background mode》与《Webhooks》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 调用深度推理模型或复杂多步工具链,单次运行动辄几分钟、经常撞上网关或客户端 HTTP 超时的开发者;
- 不希望前端长连接一断就白跑一次昂贵请求,需要任务在服务端稳妥跑完再取结果的人;
- 分不清何时该用常规流式、Background 后台模式和 Batch API 批量接口的人。
一、流式、Background 与 Batch 三种模式怎么选
很多刚上手 Responses API(基础见 /guides/openai-responses-api)的开发者容易把异步后台和批处理混为一谈,先按官方定义看清边界:
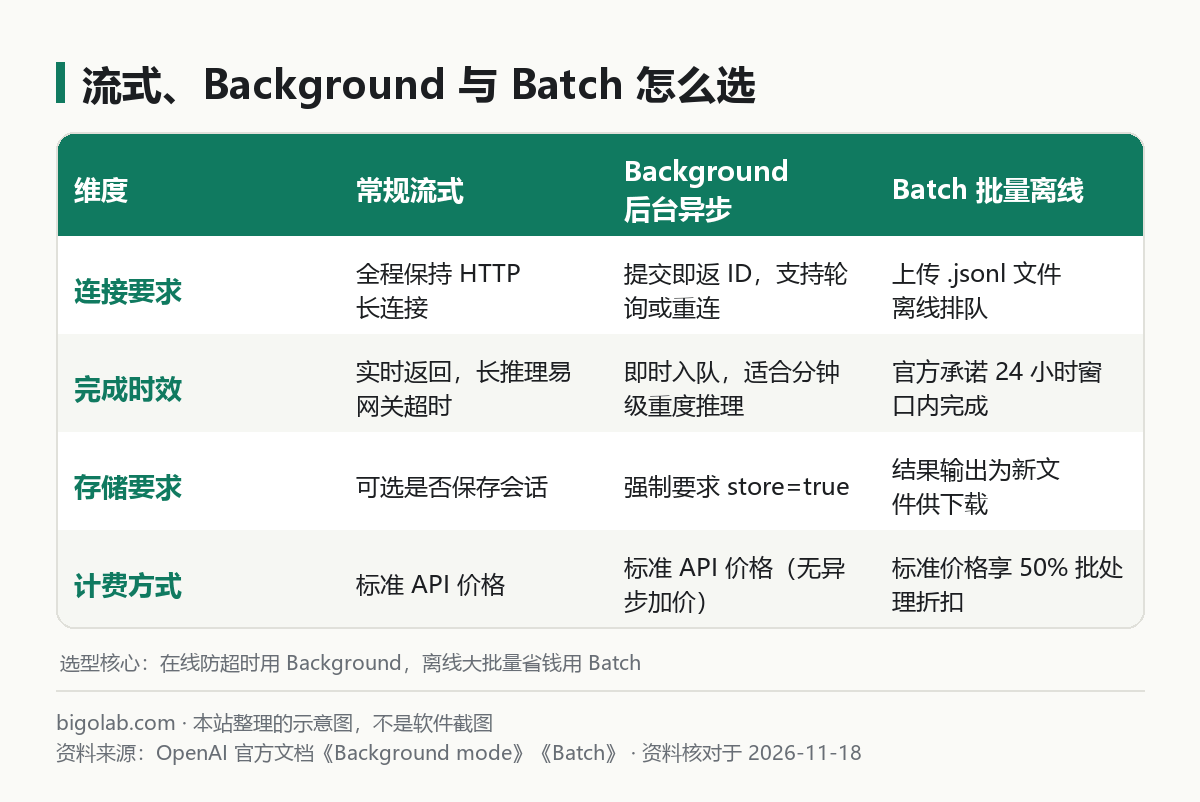
图:本站根据 OpenAI 官方文档:Background mode 与《Batch》整理的示意图
需要离线跑大批量数据集、享受 50% 折扣的做法见 /guides/openai-api-batch;常规实时吐字的写法见 /guides/openai-api-streaming。
如果你并不是写后端服务的开发者,只是自己做课题调研时想跑长耗时的深度研究(Deep Research)或高强度推理任务,直接在 ChatGPT 网页或桌面客户端发起即可,客户端自带后台运行提醒;需要升级订阅额度时可查看本站的 ChatGPT Plus 或 ChatGPT Pro,注意个人订阅与开发者 API 余额互不通用。
二、最小可用代码:提交任务与轮询状态
先确保已配置好 OPENAI_API_KEY(获取步骤见 /guides/openai-api-key)。下面的 Python 示例演示提交一个后台推理任务,并用轮询等它跑完:
python
import time
from openai import OpenAI

client = OpenAI()

# 1. 提交后台异步请求(store 默认为 True,不可设为 False)
resp = client.responses.create(
    model="o3",  # 请按官方模型页替换为你要调的推理或主力模型
    input="请对比微服务架构下三种分布式事务方案的边界条件,并给出故障恢复检查表。",
    background=True,
)

print(f"任务已提交,ID: {resp.id},初始状态: {resp.status}")

# 2. 当状态处于排队或执行中时,间隔轮询
while resp.status in ("queued", "in_progress"):
    time.sleep(3)
    resp = client.responses.retrieve(resp.id)
    print("当前状态:", resp.status)

# 3. 到达终态后检查结果
if resp.status == "completed":
    print("生成结果:\n", resp.output_text)
else:
    print(f"任务未正常完成,终态: {resp.status},详情: {resp.error}")
六种生命周期状态说明
- 非终态(继续等):
queued(已入队等待调度)、in_progress(模型正在推理或调工具)。 - 终态(停止轮询):
completed(成功完成)、failed(执行报错)、cancelled(已被主动取消)、incomplete(因达到max_output_tokens等上限提前截断)。
轮询间隔不要设成几百毫秒死循环,否则容易触发请求频率限制(429 排查见 /guides/openai-api-error-codes),建议从 2 到 5 秒起步并做退避递增。生产环境更推荐在开发者后台(Settings → Webhooks)配好接收地址,勾选 response.completed、response.failed、response.cancelled 和 response.incomplete 四类事件:每次收到推送时先用官方 SDK 的 client.webhooks.unwrap 校验签名防伪造,拿到事件里的 data.id 后再去拉取完整响应正文,这样你的业务服务器完全不用跑常驻轮询协程。
三、怎么中途取消任务与配合流式重连
1. 主动取消后台任务
用户关掉了页面,或者任务卡在 queued 太久决定放弃重试时,调用 cancel 接口把服务端状态强制推到 cancelled:
python
cancelled_resp = client.responses.cancel(resp.id)
print("取消后状态:", cancelled_resp.status)
对已经处于 completed 等终态的响应重复调取消接口属于幂等操作,直接返回当前对象。
2. 后台模式也能边跑边流式读取
如果既想让前端实时看到输出进度,又怕中途断网前功尽弃,创建请求时可以同时传 background=True 和 stream=True。消费流式事件时记录每个事件的 sequence_number 作为游标;一旦网络闪断,调用 responses.retrieve(resp.id, stream=True, starting_after=游标号) 就能从断点接着往下收,不必重头再跑一遍。
常见问题
问:开 background=True 会比普通请求慢一点启动吗?
会有轻微的入队调度延迟。因为后台请求走异步队列池,遇到平台算力高峰时可能在 queued 停留几秒甚至更久;只有几秒就能答完的短对话没必要开后台模式,直接用同步或常规流式响应更快。
问:为什么传了 background=True 直接报 400 错误?
先检查请求里是不是同时传了 store=False,或者你的组织默认开启了不落盘的零数据保留策略。后台任务必须把中间与最终状态持久化在 OpenAI 服务端才能供后续拉取。
问:任务在 in_progress 阶段被我调用 cancel 取消了,还要付钱吗?
取消前模型已经实际消耗掉的推理与输出 token 仍会按实际发生量计费,但及时调 cancel 能阻止它继续往后生成几千字,避免无谓浪费。
问:国内没有境外信用卡,怎么开通或续费 ChatGPT Plus / Pro?
答:可在本站使用支付宝、微信支付或 AlipayHK 下单获取卡密自助兑换(支持 ChatGPT Plus、Pro 5x 可覆盖档 与 Pro 5x 空白号档),实时价格、兑换前提与售后规则(掉订阅按剩余天数折退,封号不在质保范围)以对应页面说明为准。
相关教程
参考资料
- OpenAI 官方文档:Background mode — https://developers.openai.com/api/docs/guides/background
- OpenAI 官方文档:Webhooks — https://developers.openai.com/api/docs/guides/webhooks
0 条评论
还没有评论,来抢沙发~