
结论先说
- Responses API 提供三种多轮状态管理路径:传
previous_response_id串联响应、用Conversations接口建持久会话对象、或客户端手动把历史条目拼进input数组。 previous_response_id最省代码但有两个坑:第一,它不继承上一轮的顶层instructions,每轮仍需传;第二,链条中带入的前序上下文依然照常计收输入 token 费。- 需要类似旧 Threads 的持久线程管理,用
Conversations接口:先调client.conversations.create()拿到会话 ID,后续请求传conversation参数即可自动追加消息。 - 开启
store: false(或零数据保留 ZDR)时必须手动拼数组:若使用推理模型且不落盘,还需请求返回并原样回传带encrypted_content的加密推理条目。 - 从零认识 Responses API 与旧接口差异,可先读 /guides/openai-responses-api。
- 国内免境外卡开通入口:若没有境外银行卡或遇到支付被拒,可在本站通过支付宝、微信支付或 AlipayHK 自助获取兑换码开通 ChatGPT Plus 或 ChatGPT Pro,团队多席位支持联系客服定制 ChatGPT Business 团队版。
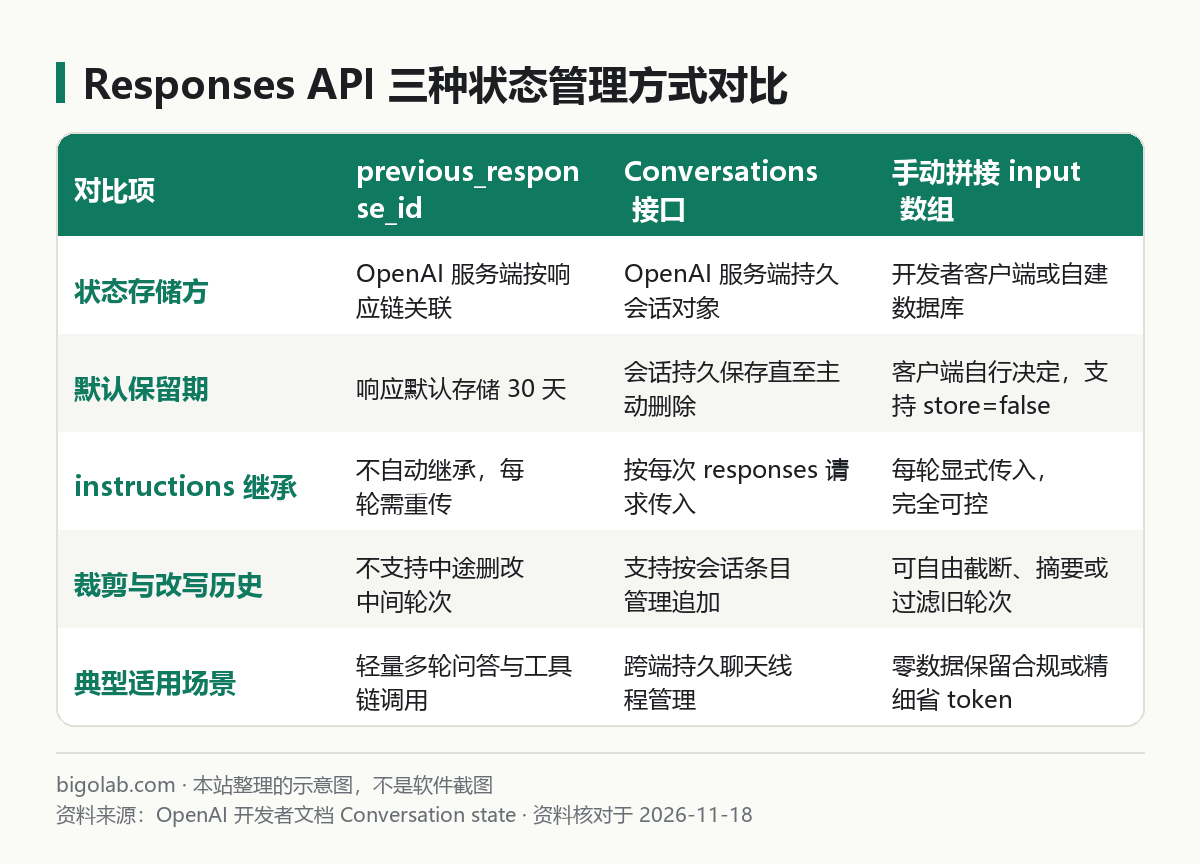
图:本站根据 OpenAI 开发者文档:Conversation state 整理的示意图
本文根据 OpenAI 开发者文档《Conversation state》《Migrate to the Responses API》与 API Reference 整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 从 Chat Completions 或旧版 Assistants API 迁到 Responses API,纠结怎么保存多轮聊天上下文的开发者;
- 用了
previous_response_id后发现第二轮系统人设失效、或者误以为服务端托管历史能免掉旧消息 token 费的人; - 需要在合规零存储(
store: false)、持久聊天室与轻量工具循环之间选型的团队。
一、三种状态管理方式完整对比
在旧的 Chat Completions 里,多轮对话只有「客户端自己存全量 messages 数组每轮重发」这一种办法;而在 Responses API 中,输入输出统一抽象为条目(Items),你可以按业务形态三选一:
| 对比维度 | previous_response_id | Conversations 接口 | 手动拼接 input 数组 |
|---|---|---|---|
| 谁存历史记录 | OpenAI 服务端按响应链串联 | OpenAI 服务端独立会话容器 | 开发者自己的客户端或数据库 |
| 默认保留时间 | 单条响应默认存储 30 天 | 持久保留直至调接口删除 | 完全由你控制,可配 store=False |
| 能否分叉对话 | 极方便(指向任意旧响应 ID 即可分叉) | 线性追加为主 | 自由复制切片数组即可分叉 |
| 能否裁剪中间旧消息 | 不支持直接删改链条中间节点 | 可通过会话条目接口管理 | 完全自由截断、做摘要压缩 |
| 历史上下文计费 | 按实际送入模型的历史输入 token 计费 | 按实际送入模型的输入 token 计费 | 按你传过去的 input token 计费 |
需要提醒的是:无论由服务端代存还是本地重传,模型在生成新回复时都要重读前文,因此历史上下文均会计入输入 token(好在重复长前缀会自动享受提示词缓存折扣,单价参考 /guides/openai-api-price-official-table)。API 按量扣费与网页订阅互不通用,若只是个人日常在网页端对话直接开通 ChatGPT Plus 即可,区别见 /guides/chatgpt-subscription-vs-openai-api。
二、方式一与方式二:服务端托管写法示例
1. 用 previous_response_id 轻量串联(支持随时分叉)
适合单次用户请求内部的多步工具调用循环,或无需长期超过 30 天保存的短对话。注意每轮显式带上 instructions:
python
from openai import OpenAI

client = OpenAI()
SYS_RULE = "用简明中文回答,每次不超过三句话。"

turn1 = client.responses.create(
    model="gpt-6-astra",
    instructions=SYS_RULE,
    input="PostgreSQL 里的 MVCC 是做什么的?",
)

# 第二轮传入上一轮的 id,同时重新传入 instructions
turn2 = client.responses.create(
    model="gpt-6-astra",
    instructions=SYS_RULE,
    previous_response_id=turn1.id,
    input="它为什么会产生膨胀,怎么清理?",
)
print(turn2.output_text)
2. 用 Conversations 接口管理持久聊天线程
Assistants API 下线后,需要持久化会话列表(例如客服工单会话、跨设备同步聊天窗口)的应用应改用 Conversations 接口。注意在同一请求里,conversation 与 previous_response_id 二选一,不要同时传:
python
from openai import OpenAI

client = OpenAI()

# 1. 创建持久会话对象(可写入业务 metadata 便于检索)
conv = client.conversations.create(metadata={"user_id": "u_10086"})

# 2. 绑定 conversation ID 发起多轮对话,服务端自动把输入输出追加进该会话
r1 = client.responses.create(
    model="gpt-6-astra",
    conversation=conv.id,
    input="帮我拟一份三天的京都步行路线。",
)

r2 = client.responses.create(
    model="gpt-6-astra",
    conversation=conv.id,
    input="把第二天改成以宇治喝茶为主。",
)
print(r2.output_text)本站订阅与团队开通提示:如果你在国内遇到银行卡被拒或急需提升对话与推理配额,可前往本站 ChatGPT Plus 充值说明页 或 ChatGPT Pro 5x/20x 充值页 自助获取卡密完成开通(全程无需交出账号密码,可开增值税发票);企业多成员协作可直接查看 ChatGPT Business 团队定制方案。
三、方式三:手动拼 input 数组与无状态(store: false)注意要点
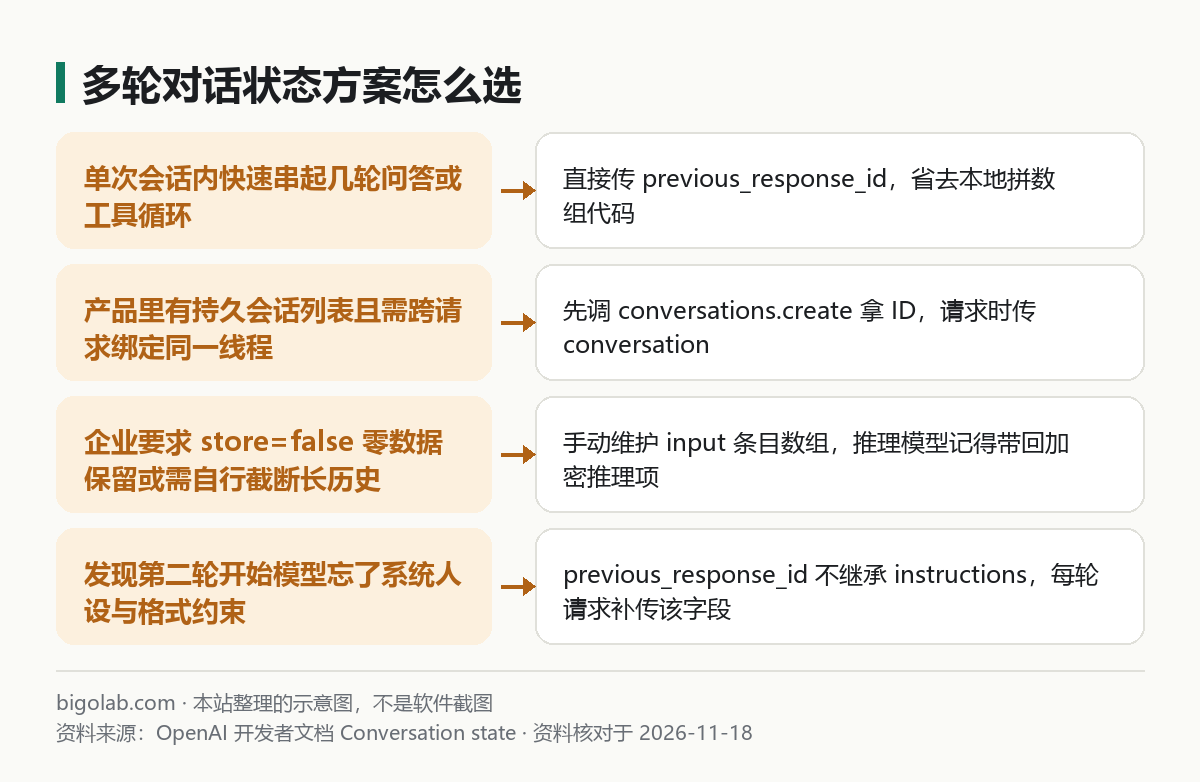
图:本站根据 OpenAI 开发者文档:Conversation state 整理的示意图
在两类场景下,手动维护 input 列表依然不可替代:一是长对话超过几万字后你想在本地把早期闲聊压缩成摘要省钱(计数方式见 /guides/openai-api-token-count-estimate);二是企业有严格隐私要求,必须设置 store=False(零数据保留组织默认强制不存储)。
手动拼接时千万别只取 output_text 纯文字往回塞,而要把 response.output 里的结构化条目(含工具调用项与推理项)整体保留:
python
history = [{"role": "user", "content": "查一下订单 ORD-99 的物流状态"}]

resp = client.responses.create(
    model="gpt-6-astra",
    store=False,
    include=["reasoning.encrypted_content"],  # 不落盘时跨轮保留推理状态
    input=history,
)

# 把模型本轮产生的推理条目、工具调用或回复条目完整拼入历史
history.extend(resp.output)
如果涉及自定义函数调用,还要把本地执行后的 function_call_output(带对应 call_id)一并追加进 history,完整工具回传写法见 /guides/openai-api-function-calling。
常见问题
问:用了 previous_response_id 之后,为什么第二轮模型突然不遵守第一轮设的 JSON 格式或语气要求了?
答:官方迁移文档特别提醒,顶层参数 instructions 只作用于当前这一次请求,不会顺着 previous_response_id 往后遗传。后续每轮请求都需要带上相同的 instructions。
问:响应默认存 30 天,超过 30 天再传旧的 previous_response_id 会怎样?
答:过期后该响应对象无法再被引用,接口会返回找不到资源报错。需要跨月保留的长期对话请改用 Conversations 接口,或在自己的数据库落盘消息记录。
问:能把 conversation 和 previous_response_id 同时写进同一个请求里吗?
答:不能。两者分别代表两种互斥的服务端上下文装载机制,同一次 responses.create 调用只能选其中一种。
问:国内没有境外信用卡,怎么开通或续费 ChatGPT Plus / Pro?
答:可在本站使用支付宝、微信支付或 AlipayHK 下单获取卡密自助兑换(支持 ChatGPT Plus、Pro 5x 可覆盖档 与 Pro 5x 空白号档),实时价格、兑换前提与售后规则(掉订阅按剩余天数折退,封号不在质保范围)以对应页面说明为准。
相关教程
- OpenAI Responses API 是什么:和 Chat Completions 的区别与迁移要点
- OpenAI API 函数调用(function calling)怎么写
- OpenAI API 的 token 怎么算、怎么估算费用
- OpenAI API 价格是多少:各型号每百万 token 价格表
参考资料
- OpenAI 开发者文档:Conversation state — https://developers.openai.com/api/docs/guides/conversation-state
- OpenAI 开发者文档:Migrate to the Responses API — https://developers.openai.com/api/docs/guides/migrate-to-responses
- OpenAI API Reference:Create a response — https://developers.openai.com/api/reference/resources/responses/methods/create
0 条评论
还没有评论,来抢沙发~