
結論先說
- 先看重要狀態變化:按 OpenAI 官方棄用時間表,平台託管版 Evals 控制檯與
/v1/evals接口已於 2026-10-31 轉為只讀(僅支持查看與導出歷史評測數據),並定於 2026-11-30 正式停服。 - 官方推薦的新去向是 Promptfoo:做提示詞與模型對比評測時,OpenAI 官方遷移文檔建議改用開源工具 Promptfoo 在本地或 CI 流水線裏維護測試集。
- Graders(評分器)概念並未作廢:OpenAI 定義的
string_check、text_similarity、label_model、score_model四類評分器,目前仍是強化微調(RFT)打獎勵分的核心組件,設計思路也與主流評測框架完全相通。 - 手裏還有舊 Evals 數據的請抓緊導出:在 2026-11-30 徹底關停前,去只讀控制檯把歷史 JSONL 樣本和期望輸出備份下來,轉成
promptfooconfig.yaml即可無縫接續。 - 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
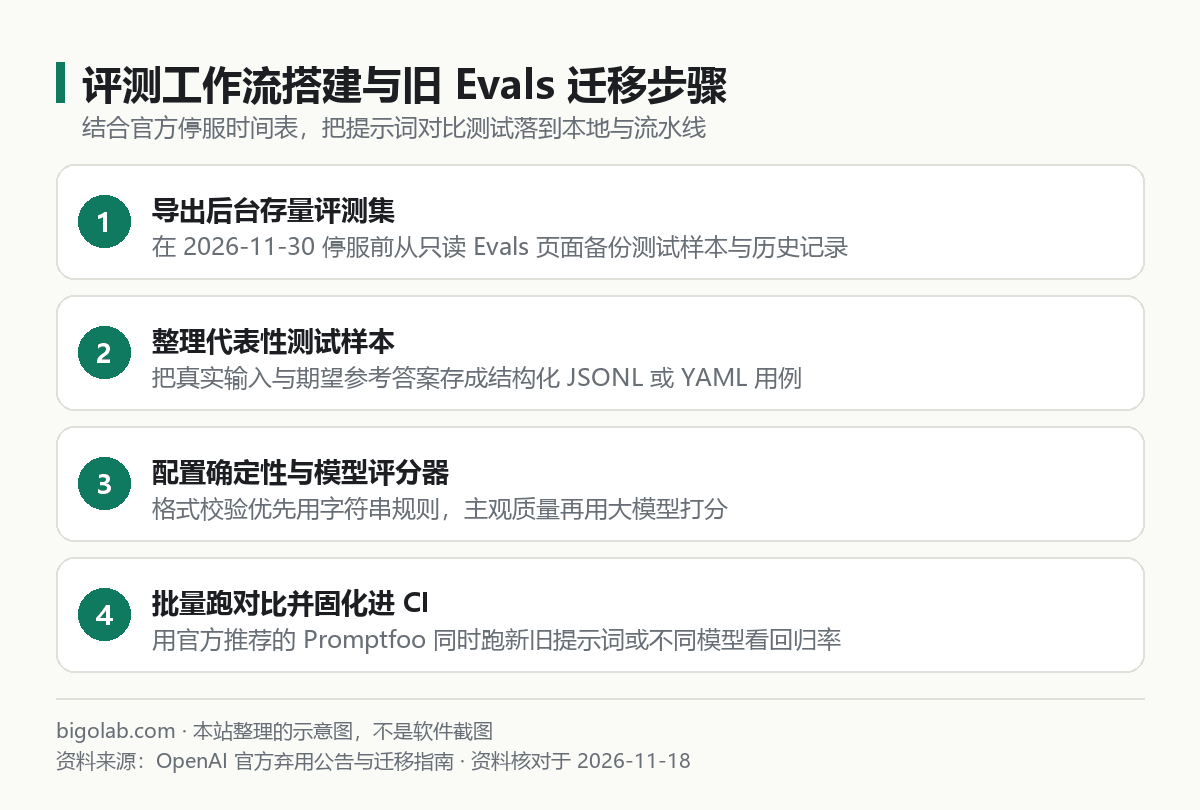
圖:本站根據 OpenAI 官方棄用公告 與《Graders》文檔整理的示意圖
本文根據 OpenAI 官方《Deprecations》《Graders》與《Evals》文檔整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 打開
platform.openai.com的 Evals 頁面想建測試集,卻發現新建和運行按鈕已不可用的開發者; - 需要系統對比兩版提示詞(Prompt)或兩個模型誰更準,不想每次靠肉眼挑幾條試跑的人;
- 想搞懂 OpenAI 的評分器(Graders)怎麼寫,以便在強化微調或本地自動化評測裏複用的人。
一、為什麼託管版 Evals 建不了新任務
早期 OpenAI 在開發者後台提供了可視化的 Evals 面板和 /v1/evals 接口,允許上載測試集、綁定模板並在線出報表。但在 2026 年公佈的平台收斂計劃中,官方決定下線託管評測面板,讓開發者把評測用例放回自己的代碼倉庫和持續集成(CI)流程裏版本化管理。
兩個關鍵時間節點務必記清:
- 2026-10-31 起:現有託管評測變為只讀(Read-only),不能再通過網頁後台或
/v1/evals新建評測、修改規則或觸發新運行,但仍可查閱和下載存量記錄; - 2026-11-30 起:託管版 Evals 面板與對應 API 端點全面關閉。
順帶區分一個容易重名的項目:OpenAI 在 GitHub 上早年開源過名為 openai/evals 的基準評測倉庫,那是本地運行的命令行代碼庫;而官方在遷移指南里針對“日常應用改提示詞、對比多模型”首先推薦的替代工具是 Promptfoo(詳細安裝與基礎用法見 /guides/promptfoo-compare-prompts-models-eval)。
二、讀懂四類評分器(Graders)與替代寫法對照
不管用哪套工具做自動化評測,核心都是“測試數據集(Dataset)+ 評分器(Grader)”。OpenAI 官方《Graders》文檔將評分邏輯劃為四大類,即便託管面板下線,你在做強化微調或寫本地斷言時依然會直接用到它們:
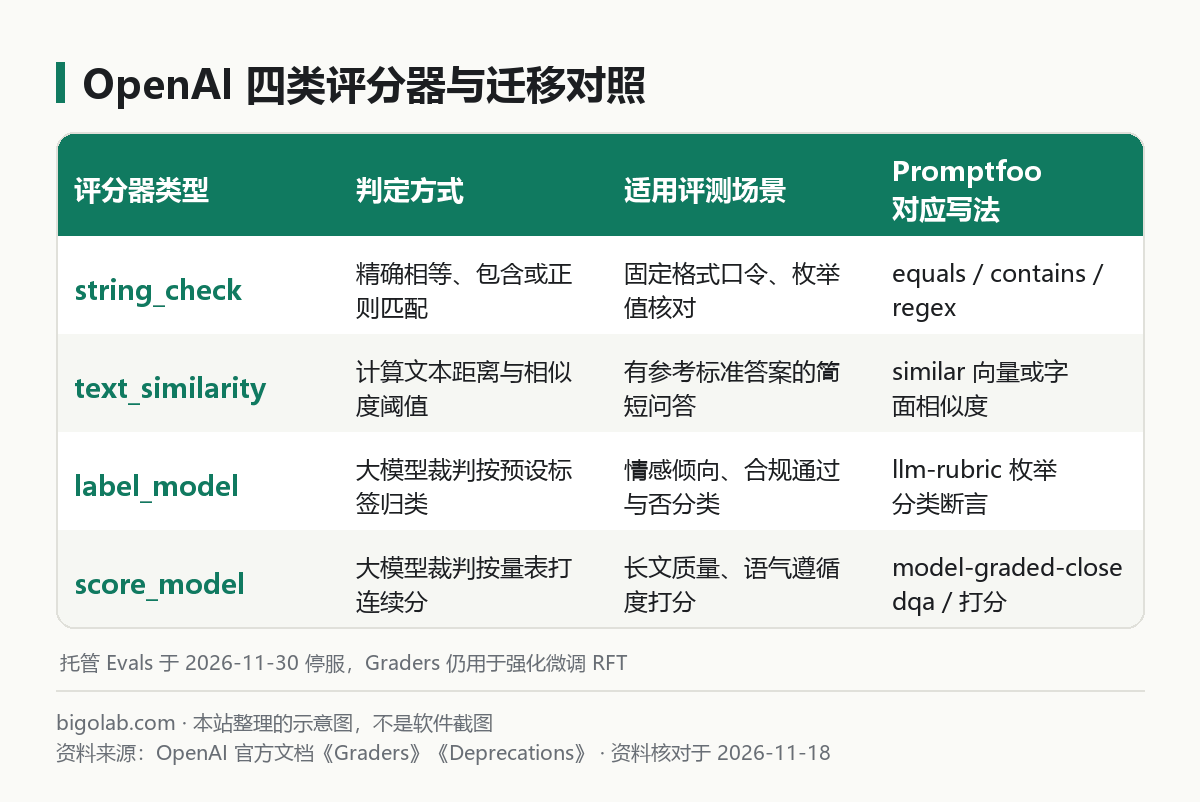
圖:本站根據 OpenAI 官方文檔:Graders 與棄用遷移說明整理的示意圖
選型原則很直接:能用確定性規則(string_check、JSON 校驗、正則)判定的,絕不先上大模型當裁判,既省 API 預算又沒有隨機波動;只有評估語氣、摘要完整性這類沒有唯一字面答案的題目,才啟用 label_model 或 score_model。
如果你們團隊是非技術崗居多,平時只是想在共享空間裏協作測試幾版辦公提示詞、不需要搭命令行評測流水線,也可以考慮直接用團隊工作區手動對比;需要定製企業協作席位時可查看本站 ChatGPT Business 團隊版,或了解個人訂閱 ChatGPT Plus。
三、實戰替代方案:用 Promptfoo 跑 OpenAI 模型與提示詞對比
把原本打算在 OpenAI 後台建的評測遷到本地,只需要建一個 promptfooconfig.yaml。先確保本機配好了 OPENAI_API_KEY(獲取見 /guides/openai-api-key,接口結構見 /guides/openai-responses-api):
yaml
description: "售後工單分類與回覆提示詞對比評測"

prompts:
  - "你是客服助手。請判斷用戶意圖(僅輸出 退款/換貨/諮詢)並給出一句回覆:{{query}}"
  - "請嚴格按【分類:xxx】開頭回復以下售後問題,分類限 退款、換貨、諮詢 三選一:{{query}}"

providers:
  - openai:responses:gpt-4o-mini
  - openai:responses:gpt-4o

tests:
  - vars:
      query: "剛收到的鍵盤空格鍵卡住了,能給我重新發一把新的嗎?"
    assert:
      # 對應原 Evals 的 string_check(確定性包含檢查)
      - type: contains
        value: "換貨"
      # 對應原 Evals 的 label_model / score_model(模型裁判打分)
      - type: llm-rubric
        value: "回覆語氣禮貌,明確引導用戶提供訂單號或故障照片,且未承諾額外賠償"
在終端運行下面兩條命令即可批量執行並在瀏覽器打開並排對比矩陣:
bash
npx promptfoo@latest eval
npx promptfoo@latest view
如果除了離線跑測試集,你還想在線上運行階段追蹤每次大模型調用的耗時與中間工具鏈路,可以搭配可觀測工具一起看,具體見 /guides/arize-phoenix-llm-tracing-observability。
常見問題
問:後台 Evals 停服後,強化微調(RFT)裏的 Grader 還能正常用嗎?
能正常使用。停服的是獨立託管的 Evals 面板與 /v1/evals 接口;強化微調作業配置裏內嵌的 string_check、score_model、Python 代碼評分器等屬於微調訓練管線的一部分,不受這次面板下線影響。
問:做一次評測大概要準備多少條測試樣本才夠看?
起步不必追求幾千條。工程上先從真實線上報錯或邊界情況裏挑出 20 到 50 條高代表性樣本建成基準集,每次改完提示詞必跑一遍,就已經能攔住大部分“改好A問題卻把B問題改壞”的迴歸退化。
問:用模型給模型打分(score_model)怎麼減少打分飄忽不定?
盡量把連續打分拆成邊界清晰的二元或三檔分類(類似 label_model),在評分指令裏寫明具體的得分點與扣分項,並把裁判模型的溫度固定在低檔或預設確定性檔位。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
- promptfoo 使用教學:對比提示詞和模型、寫斷言自動評測
- Arize Phoenix 調用鏈路追蹤與評測上手
- OpenAI Responses API 是什麼
- OpenAI API Key 怎麼獲取
參考資料
- OpenAI 官方文檔:Deprecations(棄用時間表)— https://developers.openai.com/api/docs/deprecations
- OpenAI 官方文檔:Graders(評分器說明)— https://developers.openai.com/api/docs/guides/graders
- OpenAI 官方文檔:Working with evals — https://developers.openai.com/api/docs/guides/evals
0 條評論
還沒有評論,來搶沙發~