
結論先說
- 加一個參數即可異步執行:在
responses.create請求裏傳background=True,接口會立刻返回帶resp_前綴的響應 ID 和初始狀態,無需一直佔着網絡連接苦等。 - 硬性前提是允許服務端存儲:Background 模式要求
store=True(預設值);如果業務開啟了零數據保留(ZDR)或傳了store=False,接口會報錯拒絕。 - 取回結果有兩條正路:生產環境優先配平台 Webhook 監聽
response.completed等事件;本地腳本或內網服務則每隔幾秒調用responses.retrieve(id)輪詢,直到脫離queued和in_progress。 - 本地斷開不代表服務端停機:直接關掉終端或跳出輪詢循環,OpenAI 後台仍會繼續跑完並扣費;確定不要結果時必須顯式調用
responses.cancel(id)。 - 它不打折但即時排隊:Background 按標準 API 單價計費,圖的是分鐘級在線任務防超時;若是成千上萬條不着急的離線任務想省一半費用,應選 Batch API。
- 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
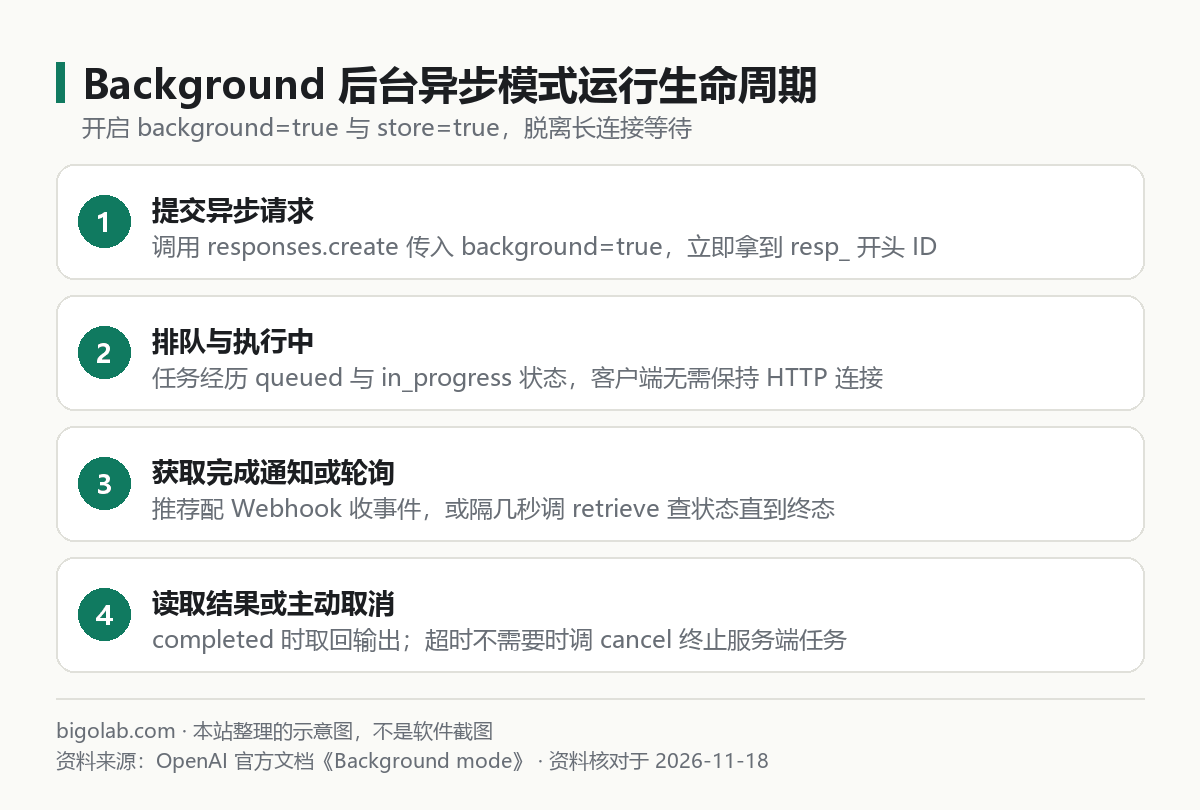
圖:本站根據 OpenAI 官方文檔:Background mode 整理的示意圖
本文根據 OpenAI 官方文檔《Background mode》與《Webhooks》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 調用深度推理模型或複雜多步工具鏈,單次運行動輒幾分鐘、經常撞上網關或客戶端 HTTP 超時的開發者;
- 不希望前端長連接一斷就白跑一次昂貴請求,需要任務在服務端穩妥跑完再取結果的人;
- 分不清何時該用常規流式、Background 後台模式和 Batch API 批量接口的人。
一、流式、Background 與 Batch 三種模式怎麼選
很多剛上手 Responses API(基礎見 /guides/openai-responses-api)的開發者容易把異步後台和批處理混為一談,先按官方定義看清邊界:
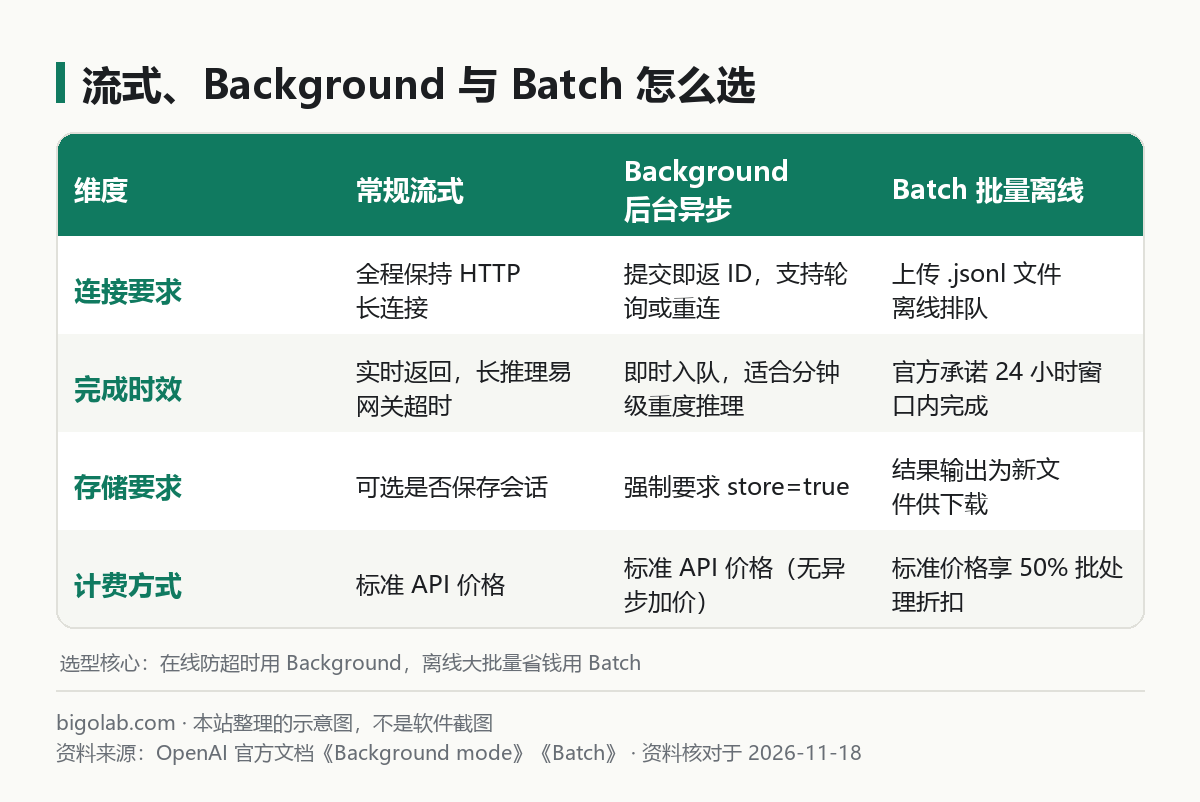
圖:本站根據 OpenAI 官方文檔:Background mode 與《Batch》整理的示意圖
需要離線跑大批量數據集、享受 50% 折扣的做法見 /guides/openai-api-batch;常規實時吐字的寫法見 /guides/openai-api-streaming。
如果你並不是寫後端服務的開發者,只是自己做課題調研時想跑長耗時的深度研究(Deep Research)或高強度推理任務,直接在 ChatGPT 網頁或桌面客戶端發起即可,客戶端自帶後台運行提醒;需要升級訂閱額度時可查看本站的 ChatGPT Plus 或 ChatGPT Pro,注意個人訂閱與開發者 API 餘額互不通用。
二、最小可用代碼:提交任務與輪詢狀態
先確保已配置好 OPENAI_API_KEY(獲取步驟見 /guides/openai-api-key)。下面的 Python 示例演示提交一個後台推理任務,並用輪詢等它跑完:
python
import time
from openai import OpenAI

client = OpenAI()

# 1. 提交後台異步請求(store 預設為 True,不可設為 False)
resp = client.responses.create(
    model="o3",  # 請按官方模型頁替換為你要調的推理或主力模型
    input="請對比微服務架構下三種分佈式事務方案的邊界條件,並給出故障恢復檢查表。",
    background=True,
)

print(f"任務已提交,ID: {resp.id},初始狀態: {resp.status}")

# 2. 當狀態處於排隊或執行中時,間隔輪詢
while resp.status in ("queued", "in_progress"):
    time.sleep(3)
    resp = client.responses.retrieve(resp.id)
    print("當前狀態:", resp.status)

# 3. 到達終態後檢查結果
if resp.status == "completed":
    print("生成結果:\n", resp.output_text)
else:
    print(f"任務未正常完成,終態: {resp.status},詳情: {resp.error}")
六種生命週期狀態說明
- 非終態(繼續等):
queued(已入隊等待調度)、in_progress(模型正在推理或調工具)。 - 終態(停止輪詢):
completed(成功完成)、failed(執行報錯)、cancelled(已被主動取消)、incomplete(因達到max_output_tokens等上限提前截斷)。
輪詢間隔不要設成幾百毫秒死循環,否則容易觸發請求頻率限制(429 排查見 /guides/openai-api-error-codes),建議從 2 到 5 秒起步並做退避遞增。生產環境更推薦在開發者後台(Settings → Webhooks)配好接收地址,勾選 response.completed、response.failed、response.cancelled 和 response.incomplete 四類事件:每次收到推送時先用官方 SDK 的 client.webhooks.unwrap 校驗簽名防偽造,拿到事件裏的 data.id 後再去拉取完整響應正文,這樣你的業務伺服器完全不用跑常駐輪詢協程。
三、怎麼中途取消任務與配合流式重連
1. 主動取消後台任務
用戶關掉了頁面,或者任務卡在 queued 太久決定放棄重試時,調用 cancel 接口把服務端狀態強制推到 cancelled:
python
cancelled_resp = client.responses.cancel(resp.id)
print("取消後狀態:", cancelled_resp.status)
對已經處於 completed 等終態的響應重複調取消接口屬於冪等操作,直接返回當前對象。
2. 後台模式也能邊跑邊流式讀取
如果既想讓前端實時看到輸出進度,又怕中途斷網前功盡棄,創建請求時可以同時傳 background=True 和 stream=True。消費流式事件時記錄每個事件的 sequence_number 作為遊標;一旦網絡閃斷,調用 responses.retrieve(resp.id, stream=True, starting_after=遊標號) 就能從斷點接着往下收,不必重頭再跑一遍。
常見問題
問:開 background=True 會比普通請求慢一點啟動嗎?
會有輕微的入隊調度延遲。因為後台請求走異步隊列池,遇到平台算力高峰時可能在 queued 停留幾秒甚至更久;只有幾秒就能答完的短對話沒必要開後台模式,直接用同步或常規流式響應更快。
問:為什麼傳了 background=True 直接報 400 錯誤?
先檢查請求裏是不是同時傳了 store=False,或者你的組織預設開啟了不落盤的零數據保留策略。後台任務必須把中間與最終狀態持久化在 OpenAI 服務端才能供後續拉取。
問:任務在 in_progress 階段被我調用 cancel 取消了,還要付錢嗎?
取消前模型已經實際消耗掉的推理與輸出 token 仍會按實際發生量計費,但及時調 cancel 能阻止它繼續往後生成幾千字,避免無謂浪費。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
參考資料
- OpenAI 官方文檔:Background mode — https://developers.openai.com/api/docs/guides/background
- OpenAI 官方文檔:Webhooks — https://developers.openai.com/api/docs/guides/webhooks
0 條評論
還沒有評論,來搶沙發~