
结论先说
- 聊十几轮就忘规矩不是偶然 Bug,而是「注意力稀释 + 窗口滑出」的必然结果:普通聊天框里的第一条消息只是普通历史文本;随着中间插进十几轮问答、长文档和修改指令,模型对最近几轮的权重远高于开头,早期规则就会逐步失效;一旦总字数超出当前套餐上下文上限,开头设定甚至会被彻底截断(不同套餐上下文长度说明见 /guides/chatgpt-context-length-limits)。
- 最治本的招数是把铁律搬出聊天框,放进 Projects 指令或自定义指令:写入 Projects(项目) 专属指令或 Custom Instructions 的规矩,每一轮都会以高优先级系统指令载入,不会因为多聊了二十轮就被挤出记忆。
- 不要在同一条对话里死磕几十轮,每 8–10 轮做一次「交接快照」换新窗:让模型把已定规则和当前成果压缩成 300 字状态摘要,带去全新对话第一条继续干活,效果比硬拖一条百轮长线程稳得多。
- 发现跑偏立刻「编辑上一条提问」,别顺着错误连骂五轮:你在下面连续补五句「不对、不要这样写」,只会把错误示范和负面指令全塞进上下文,把模型越带越糊涂。
- 需要更大上下文窗口、Projects 项目空间与更强长指令遵循模型的升级入口:免费版在上下文容量与高阶推理配额上限制较紧,国内免外币卡可通过本站用支付宝、微信支付或 AlipayHK 开通 ChatGPT Plus(Plus 自助充值卡密)或超大上下文与高配额的 ChatGPT Pro。
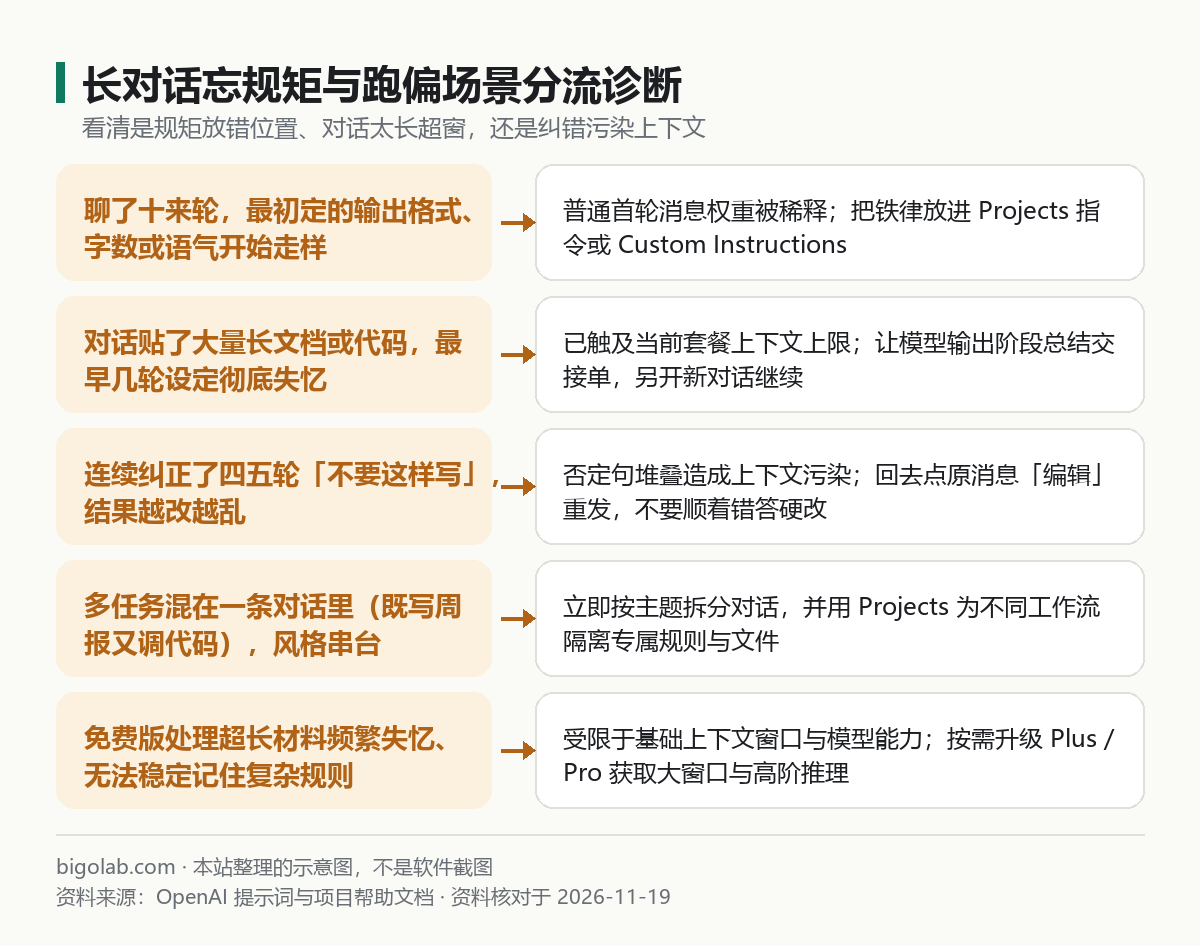
图:本站根据 OpenAI 提示词与项目文档 整理的分流诊断图
本文根据 OpenAI 帮助中心《Prompt engineering best practices for ChatGPT》《ChatGPT Custom Instructions》《Projects in ChatGPT》《Memory FAQ》整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 在对话开头仔细规定了「不准用翻译腔、固定分三列输出、不要编造数据」,聊了十几轮之后发现 ChatGPT 彻底抛在脑后的职场与写作者;
- 用同一条对话连续改代码、改方案或写连载小说,越往后越答非所问、把前面已经敲定的设定改丢的用户;
- 想知道这是免费版上下文太短还是自己提示词用法不对,希望让长任务始终稳稳听话的高频用户。
一、为什么 ChatGPT 聊到后面就会「失忆」和跑偏
把大模型的对话想象成一块固定面积的白板:每聊一轮,白板上就会多写一屏文字。当白板越写越满,两个机制会同时拖垮最开始定下的规矩:
- 近因权重压过早期约束:模型在生成下一句话时,更容易被最近两三轮的语气、结构和例子牵着走。如果第 1 轮要求「极简干练」,但第 8 轮你贴了一大段啰嗦的会议纪要,第 9 轮的输出风格就会不自觉被纪要带偏;
- 多轮返工制造「上下文污染」:连续要求修改 A 版、B 版、C 版后,历史对话里同时躺着多套互相矛盾的草稿,模型在检索前文时极易把已经作废的旧要求重新捡回来;
- 超过上下文窗口上限触发硬截断:特别是塞进了多份长 PDF、Excel 或整段代码库后,token 消耗极快,系统为保证还能继续对话,只能把最早那几轮包含核心规矩的文本裁掉。
二、4 招长对话防跑偏实战技巧
下面四招既可以单独用,也可以组合起来跑复杂项目。
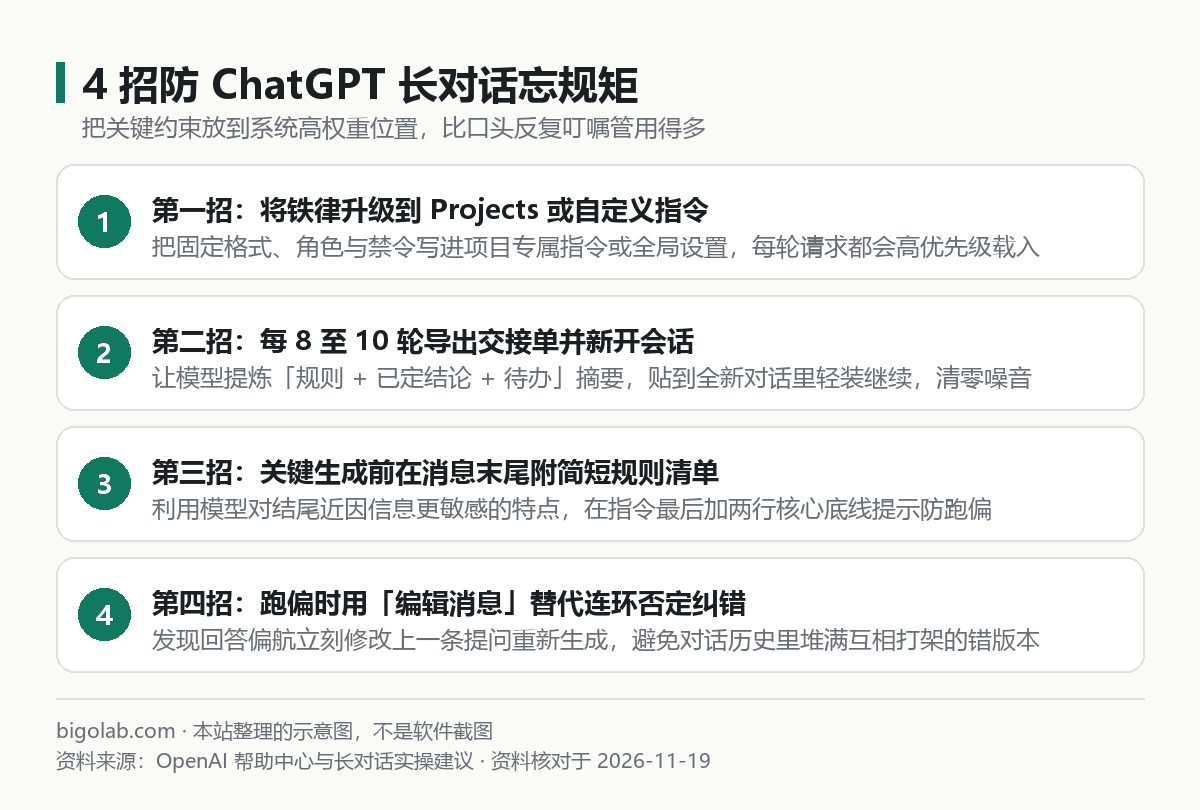
图:本站根据 OpenAI 帮助中心文档与高频长对话实战整理的步骤图
1. 第一招:把铁律抬升到 Projects 指令或自定义指令
如果你要连续几天围绕同一个产品、论文或客户写几十条对话,千万别把规则只发在普通对话框第一条。直接新建一个 Project(项目),把角色设定、禁止事项、术语表和范文填进「项目指令(Project Instructions)」,并将参考资料上传到项目文件区(完整用法见 /guides/chatgpt-projects)。如果是全账号通用的偏好(如始终用中文、先给结论再分点),则直接写入 Custom Instructions(配置教程见 /guides/chatgpt-custom-instructions)。
2. 第二招:每 8–10 轮导出「状态交接单」,果断新开对话
当一条对话已经完成了大纲确认、初稿写作或几轮需求变更,别继续往下硬叠。直接发下面这段交接模板:
text
请将我们截至目前的合作压缩为一份 400 字以内的「任务交接单」,必须包含:
1. 不可违背的硬规则(语气、格式、禁用项);
2. 已经确认锁定的核心结论与参数;
3. 下一步唯一待办任务。
不要保留已经作废的旧草稿。拿到这份干净交接单后,直接点左上角开一条全新对话把它贴进去继续干活,上下文瞬间回到巅峰状态。
3. 第三招:关键输出前,在消息最末尾挂一行「微型规则锚点」
当你终于聊到最核心的一步(比如要输出最终交付稿或关键代码),哪怕前面已经说过规矩,也建议在本次消息最后顺手附上一行 30 字的底线提醒,例如:「底线复核:严格用 3 列 Markdown 表格输出,不编造未提供数字,总字数控制在 600 字内」。把硬约束放在当前提示词末尾,能直接利用模型的近因注意力把格式牢牢锁死。
4. 第四招:发现跑偏立刻「编辑消息」分叉,拒绝连环否定
一旦发现某轮输出违背了核心规则,不要在下面接着回「你又忘了,我刚才说了不要用英文……」。直接把鼠标移到你上一条提问处点击编辑(Edit),把漏说的条件补进去重新生成——这样错误回答会彻底从当前分支抹掉,不会留在上下文里继续诱导模型犯错。
开通与排障提示:长文项目、代码架构推演与多文件对比非常吃上下文窗口和指令遵循稳定性。国内免外币卡升级可选购本站 Plus 信用卡通道卡密 或 Plus 卡密自助兑换,解锁 Projects 与更大上下文;需要超长上下文与最高配额推理的用户可升级 Pro 5x 空白号档。
三、三类持久化规则工具怎么选
| 工具位置 | 生效范围 | 最适合放什么内容 |
|---|---|---|
| Custom Instructions(自定义指令) | 全账号所有新对话 | 个人职业背景、固定语言、通用排版偏好 |
| Projects(项目指令 + 项目文件) | 单个项目内所有对话 | 某本书大纲、固定品牌调性、项目术语表与规范 |
| Memory(跨对话记忆) | 由模型自动或手动记住的关键事实 | 常用技术栈、个人长期目标、常住城市等碎片事实 |
如果频繁撞到高阶模型消息次数限制导致被迫回退到轻量模型,也会明显感觉「突然变笨忘规矩」,对应周期重置与模型切换机制可看 /guides/chatgpt-reached-limit-of-messages-reset-upgrade。
常见问题
问:打开了「记忆(Memory)」功能,为什么同一条长对话里它还是会忘规矩?
答:Memory 偏向记录跨对话的个人长期事实(例如你是前端工程师、喜欢简洁回复),不会自动把你单条临时对话里临时定下的十几条复杂格式要求全部持久化。想让某一专项任务从头到尾严守规矩,Projects 专属指令远比依赖自动 Memory 靠谱。
问:在对话中间突然发现模型回答质量断崖下降、完全不守规矩,是什么原因?
答:除了上下文太长被稀释之外,最常见的原因是你的当前高阶模型(例如主力推理模型)额度刚好用完,系统在后台悄悄自动降级成了基础轻量模型。鼠标悬停在回答底部查看当前实际生成模型名称即可核实。
问:国内没有外币卡,或者升级 Pro 遇阻、担心外币卡扣费异常,怎么安全开通 ChatGPT Plus / Pro / Business?
答:可直接进入本站 AI 会员充值总览,支持支付宝、微信支付与 AlipayHK 获取卡密自助兑换 ChatGPT Plus 或高配额 ChatGPT Pro,团队共享项目与统一报销可选 ChatGPT Business 团队方案。全程免交账号密码,支持开具国内增值税发票(标价不含税,另付 6% 税费);实时价格与售后边界(订阅期内非自身原因掉订阅按剩余天数折退,封号不在质保范围)以对应商品页展示为准。
相关教程
- ChatGPT 上下文长度限制详解:各套餐窗口大小与超长处理方法
- ChatGPT 自定义指令(Custom Instructions)完整配置教程
- ChatGPT Projects(项目文件夹)怎么用:统一管理指令、对话与文件
- ChatGPT 提示已达消息上限怎么办:额度重置周期与升级建议
0 条评论
还没有评论,来抢沙发~