
结论先说
- 核心机制是利用 Codex 官方的「分层继承」加载规则,把
AGENTS.md拆成根目录 + 子包两级。Codex 会从 Git 根目录一路向下读取到当前工作目录,把沿途所有AGENTS.md拼接起来,且离当前子目录越近的规则优先级越高。 - 根目录
AGENTS.md只写「全局红线与仓库地图」,严禁塞满细节。控制在精炼篇幅内,只交代包管理器、模块目录速查表、禁止扫描的生成目录以及跨包提交约束,避免污染每一个无关子包的上下文。 - 子包
AGENTS.md专门落地「局部构建、局部类型检查、局部单测命令」。明确禁止在根目录直接跑全量pnpm test或pytest,强制使用--filter、定向路径或标签测试,把反馈闭环从十分钟压回十秒内。 - 日常改单一子服务时,用
codex --cd <子目录>启动或在提示词里锁定边界。缩小工作起点不仅能自动命中对应子包规则,还能大幅减少 Codex 漫无目的地全仓乱扫。 - 在大型 Monorepo 中做跨包重构和自动化验证,对额度裕度与团队协作要求更高。个人重度开发推荐直接开通高配额 ChatGPT Pro,常规起步可选 ChatGPT Plus,研发团队统一席位管理可了解 ChatGPT Business 团队定制。
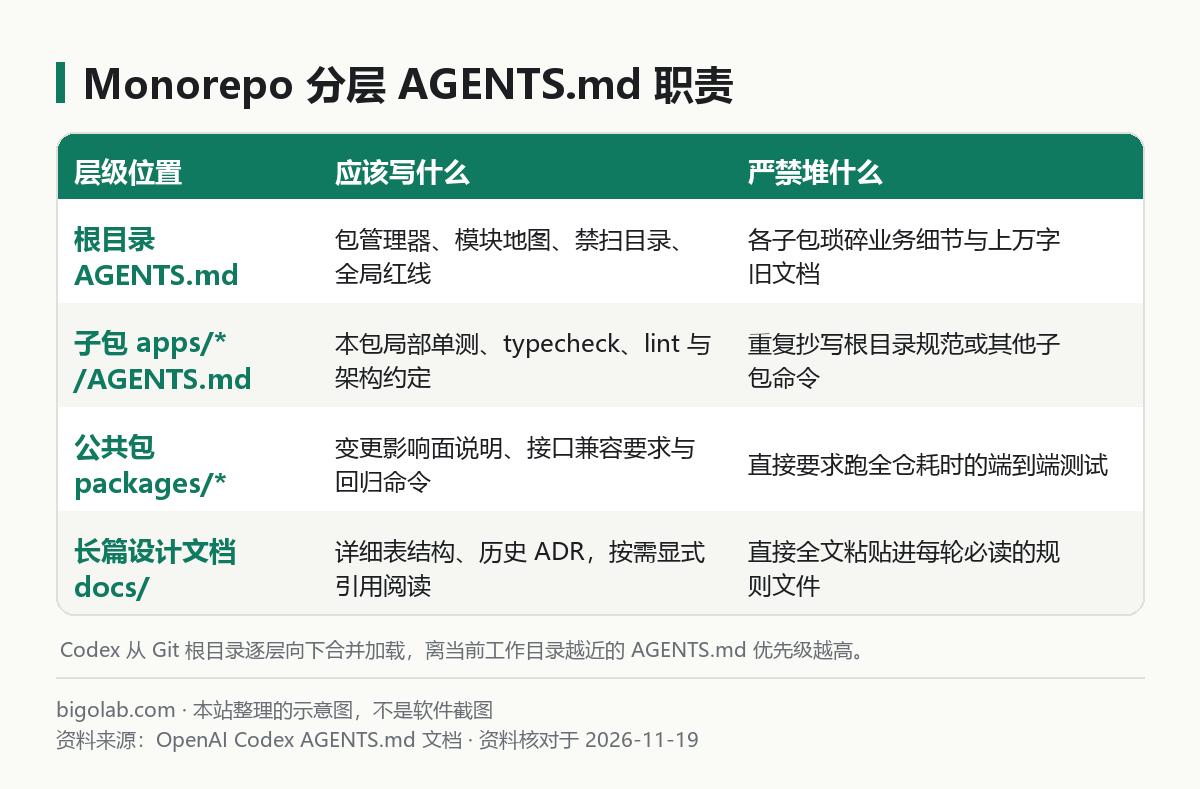
图:本站根据 OpenAI Codex 官方文档:AGENTS.md 与多包仓库规范整理的示意图
本文根据 OpenAI Codex 官方文档《AGENTS.md》《Codex CLI》《Configuration Reference》《Codex environments》及大型仓库工程实践整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 在包含多个前端应用、后端微服务和共享组件库的大型 Monorepo(如
pnpm workspaces、Turborepo、Nx、Go/Python 多模块仓)里接入 Codex 的工程师; - 让 Codex 改一个子模块,它却动不动全仓
find/grep、跑长达十几分钟的根级测试,或者把无关子包的构建产物读进上下文导致慢且费额度的团队; - 想设计一套清晰、可维护的分层
AGENTS.md规范,让每位团队成员开箱即用的架构师或 Tech Lead。
一、为什么 Monorepo 不能只靠一份巨型根目录 AGENTS.md
不少团队刚开始接 Codex 时,习惯把前端 React 规范、后端 Go 微服务部署、Python 数据脚本和数据库迁移文档全堆进仓库根目录的一份 AGENTS.md。结果很快出现三大副作用:
- 上下文信噪比暴跌:你只是想改
apps/admin的一个表格筛选,Codex 每次开局却被迫吞下几千字 Go 支付服务的架构规则,既浪费 Token 额度又容易注意力分散。 - 规则互相打架:A 子包用 Vitest,B 子包用 Jest,C 子服务用 Pytest;全揉在一张文件里,模型极易张冠李戴跑错测试框架。
- 动辄触发全仓扫描与全量构建:没有给清晰的仓库目录索引和忽略清单,Codex 为了找一个类型定义,可能会扫遍
dist/、storybook-static/、自动生成的 GraphQL/Protobuf 产物和上千个历史 fixture 文件。
关于 Codex 查找并合并多层规则文件的底层顺序,可搭配阅读 /guides/codex-agents-md-how-it-reads 和 /guides/codex-onboard-unfamiliar-project-agents-md。
二、大型 Monorepo 接入 Codex 的 5 步标准配法
以下为本站建议的 5 步落地架构,适用于前后端一体或微服务 Monorepo:
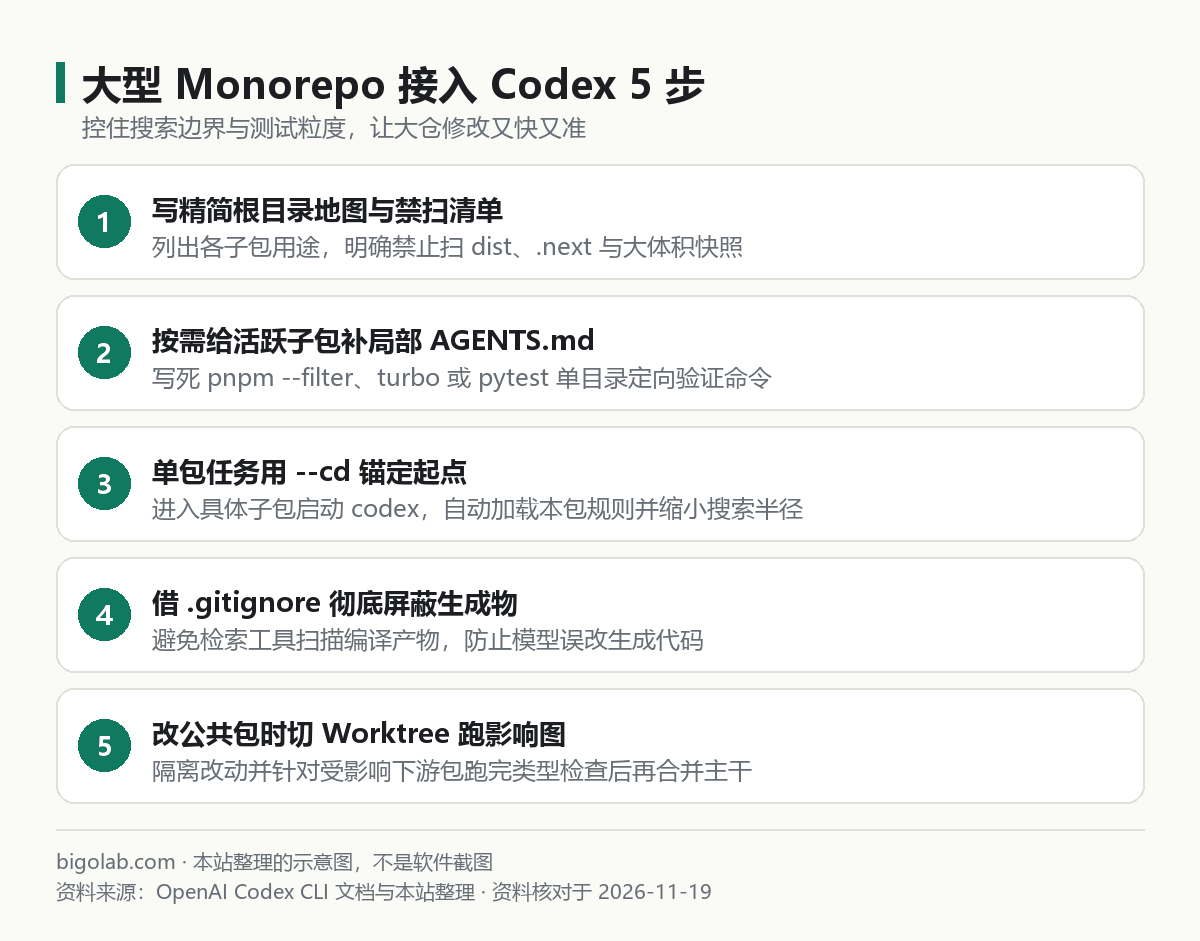
图:本站根据 OpenAI Codex 官方文档:Codex CLI 与 Monorepo 实践整理的示意图
第 1 步:编写精简的根目录 AGENTS.md(目录地图 + 防扫红线)
把根目录 AGENTS.md 控制在 1 屏左右,重点给 Codex 一张「导航图」和「禁行清单」:
markdown
# Monorepo 全局开发规则

## 仓库目录地图(先看地图再搜索,不要盲目全仓递归)
- `apps/web`: Next.js 用户端前台
- `apps/admin`: 管理后台(React + Vite)
- `services/billing`: Python FastAPI 计费服务
- `packages/shared-types`: 前后端共享类型与 OpenAPI 产物
- `packages/ui`: 公共组件库

## 全局约束与禁扫目录
- Node 依赖统一使用 `pnpm`,严禁运行 `npm install` 或 `yarn`。
- 禁止读取或全局搜索以下生成与大体积目录:`dist/`、`.next/`、`.turbo/`、`coverage/`、`**/__snapshots__/`、`testdata/large-dumps/`。
- 禁止在仓库根目录直接执行全量 `pnpm test`;必须先进入子包或加 `--filter` 局部运行。
- 修改 `packages/*` 公共包前,必须先列出受影响的下游应用并获得确认。
第 2 步:为每个活跃子包维护独立的局部 AGENTS.md
在各自子目录放置精简专属规则,例如 apps/web/AGENTS.md:
markdown
# apps/web 局部规则

## 局部验证命令(改完必须先跑单文件,再跑本包检查)
- 单文件测试:`pnpm --filter @acme/web test -- <测试文件路径>`
- 本包类型检查:`pnpm --filter @acme/web typecheck`
- 本包 Lint:`pnpm --filter @acme/web lint`

## 模块约定
- 接口请求统一复用 `src/lib/api-client.ts`,禁止在组件里手写裸 `fetch`。
- 新增路由页面放在 `src/app/`,公共 Hook 放在 `src/hooks/`。
同理,在 services/billing/AGENTS.md 中则写明使用 ./.venv/bin/pytest services/billing/tests/<file>.py -q 与 ruff check services/billing。当你在该子目录下启动 Codex 时,它会自动同时继承根目录红线和当前子包的局部命令。
第 3 步:按任务粒度选择 codex --cd 起点(本站建议)
- 单包需求(占日常 80% 工作量):直接定位到子目录启动,如
codex --cd apps/web或在子目录内运行codex。Codex 天然把探索起点锚定在该包内,只会按需读取被引用的packages/shared-types。 - 跨包联动需求:从仓库根目录启动,但在首句提示词里显式圈定本次允许读写的 2 至 3 个目录,禁止越界修改其他子包。
第 4 步:把构建缓存与生成文件彻底挡在搜索之外
除了在 AGENTS.md 里口头提醒,更要在工程基础设施层配合 .gitignore(多数高速搜索工具如 rg 会默认遵循 .gitignore)。把自动生成的 SDK、编译产物、大号 SQL 种子文件与日志目录正确加入忽略规则,既能提速搜索,也能防止 Codex 错把编译后的 dist/*.js 当源码去改。
第 5 步:改动公共底层包时用 Worktree 隔离验证
在 Monorepo 中修改 packages/shared-types 或 packages/ui 这类被十几个应用共同依赖的核心包时,风险远高于改业务页面。建议在桌面端选 Worktree 模式或命令行建独立 Git Worktree 开展重构,跑通 turbo run typecheck --filter=...[HEAD^1] 这类受影响子图检查后再合并主干。配置参数与权限边界可联动参考 /guides/codex-config-toml-complete-guide 与 /guides/codex-permissions-sandbox。
排障与订阅提示:大型 Monorepo 即使做足了分层裁剪,跨包类型检查和多轮验证的 Token 吞吐量依然明显高于单仓小项目。需要充沛配额保障可按需选择 ChatGPT Pro 20x iOS 可覆盖档;企业技术团队统一采购席位可看 ChatGPT Business 团队定制,新账号手机验证受阻可参考 Codex 注册手机验证服务。
三、大型仓常见踩坑与排查要点
- 写了子目录
AGENTS.md却感觉没生效:核对两件事——一是你是否是从仓库根目录启动且工作目录未切到子包(根启动时某些场景要等到实际操作或切换进入子目录才会读取下层规则);二是检查父级是否存在高优先级的覆盖文件(如AGENTS.override.md)覆盖了同名约定。 - 改完公共包,本包测试过了但 CI 全仓挂了:局部测试用于日常秒级开发闭环;临近提交 PR 前,建议让 Codex 跑一次受影响下游包的类型检查(例如 Turborepo 的
--filter=...^或 Nx 的affected命令),把回归拦截在提交之前。
常见问题
问:仓库里已经有 30 个子包,需要一口气写完 30 份 AGENTS.md 吗?
答:完全不需要。建议采用「按需渐进」策略:先花 15 分钟写好根目录的仓库地图和全局红线,再优先给最常迭代的 2 到 3 个核心子包补上局部 AGENTS.md,其余冷门子包等真正要大改时再顺手补齐,维护成本最低。
问:根目录 AGENTS.md 写太长到底有多大影响?
答:根目录规则文件会叠加到该仓内几乎每一次 Codex 会话的初始上下文里。文件过长不仅持续放大额度消耗,还会稀释真正关键的局部命令和禁令。建议根目录不超过 80 到 120 行,把长篇设计文档拆成独立 Markdown 放进 docs/,只在规则里写「做某类改动时再去按需阅读对应文档」。
问:国内没有外币卡,或者研发团队需要集中采购 Pro / 团队版并开具发票,怎么办理?
答:可前往本站 AI 会员充值总览 按需选购 ChatGPT Plus(含 Plus iOS 可覆盖版)或高配额 ChatGPT Pro,团队多人研发亦可选择企业定制方案。支持支付宝、微信支付及 AlipayHK,提供免交密码卡密自助兑换与增值税发票服务,价格以商品页实时展示为准;售后遵循掉订阅按剩余天数折退、封号不在质保范围的说明。
相关教程
参考资料
- OpenAI ChatGPT Learn:AGENTS.md — https://learn.chatgpt.com/docs/agent-configuration/agents-md
- OpenAI Codex 官方文档:Codex CLI — https://developers.openai.com/codex/cli
- OpenAI ChatGPT Learn:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- OpenAI ChatGPT Learn:Codex environments — https://learn.chatgpt.com/docs/environments/modes
- OpenAI Codex 官方 GitHub 仓库 — https://github.com/openai/codex
0 条评论
还没有评论,来抢沙发~