
结论先说
- 先看重要状态变化:按 OpenAI 官方弃用时间表,平台托管版 Evals 控制台与
/v1/evals接口已于 2026-10-31 转为只读(仅支持查看与导出历史评测数据),并定于 2026-11-30 正式停服。 - 官方推荐的新去向是 Promptfoo:做提示词与模型对比评测时,OpenAI 官方迁移文档建议改用开源工具 Promptfoo 在本地或 CI 流水线里维护测试集。
- Graders(评分器)概念并未作废:OpenAI 定义的
string_check、text_similarity、label_model、score_model四类评分器,目前仍是强化微调(RFT)打奖励分的核心组件,设计思路也与主流评测框架完全相通。 - 手里还有旧 Evals 数据的请抓紧导出:在 2026-11-30 彻底关停前,去只读控制台把历史 JSONL 样本和期望输出备份下来,转成
promptfooconfig.yaml即可无缝接续。 - 国内免境外卡开通入口:若没有境外银行卡或遇到支付被拒,可在本站通过支付宝、微信支付或 AlipayHK 自助获取兑换码开通 ChatGPT Plus 或 ChatGPT Pro,团队多席位支持联系客服定制 ChatGPT Business 团队版。
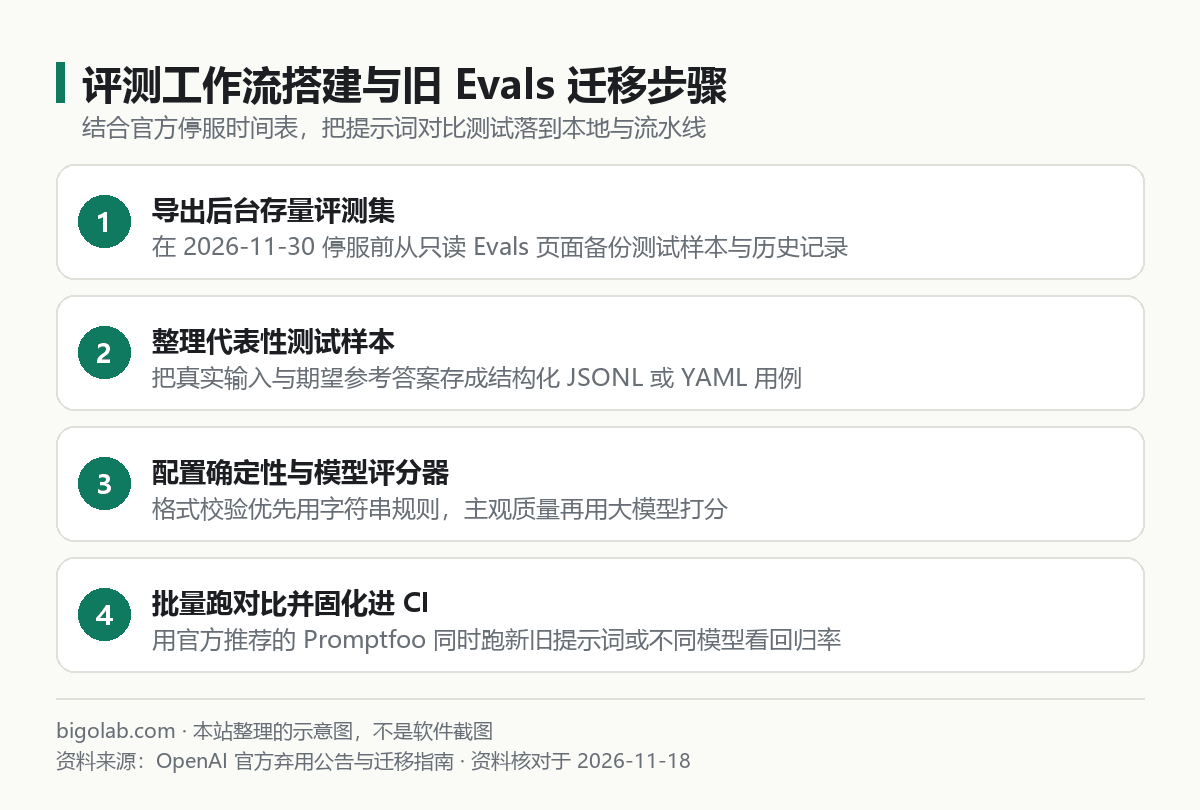
图:本站根据 OpenAI 官方弃用公告 与《Graders》文档整理的示意图
本文根据 OpenAI 官方《Deprecations》《Graders》与《Evals》文档整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 打开
platform.openai.com的 Evals 页面想建测试集,却发现新建和运行按钮已不可用的开发者; - 需要系统对比两版提示词(Prompt)或两个模型谁更准,不想每次靠肉眼挑几条试跑的人;
- 想搞懂 OpenAI 的评分器(Graders)怎么写,以便在强化微调或本地自动化评测里复用的人。
一、为什么托管版 Evals 建不了新任务
早期 OpenAI 在开发者后台提供了可视化的 Evals 面板和 /v1/evals 接口,允许上传测试集、绑定模板并在线出报表。但在 2026 年公布的平台收敛计划中,官方决定下线托管评测面板,让开发者把评测用例放回自己的代码仓库和持续集成(CI)流程里版本化管理。
两个关键时间节点务必记清:
- 2026-10-31 起:现有托管评测变为只读(Read-only),不能再通过网页后台或
/v1/evals新建评测、修改规则或触发新运行,但仍可查阅和下载存量记录; - 2026-11-30 起:托管版 Evals 面板与对应 API 端点全面关闭。
顺带区分一个容易重名的项目:OpenAI 在 GitHub 上早年开源过名为 openai/evals 的基准评测仓库,那是本地运行的命令行代码库;而官方在迁移指南里针对“日常应用改提示词、对比多模型”首先推荐的替代工具是 Promptfoo(详细安装与基础用法见 /guides/promptfoo-compare-prompts-models-eval)。
二、读懂四类评分器(Graders)与替代写法对照
不管用哪套工具做自动化评测,核心都是“测试数据集(Dataset)+ 评分器(Grader)”。OpenAI 官方《Graders》文档将评分逻辑划为四大类,即便托管面板下线,你在做强化微调或写本地断言时依然会直接用到它们:
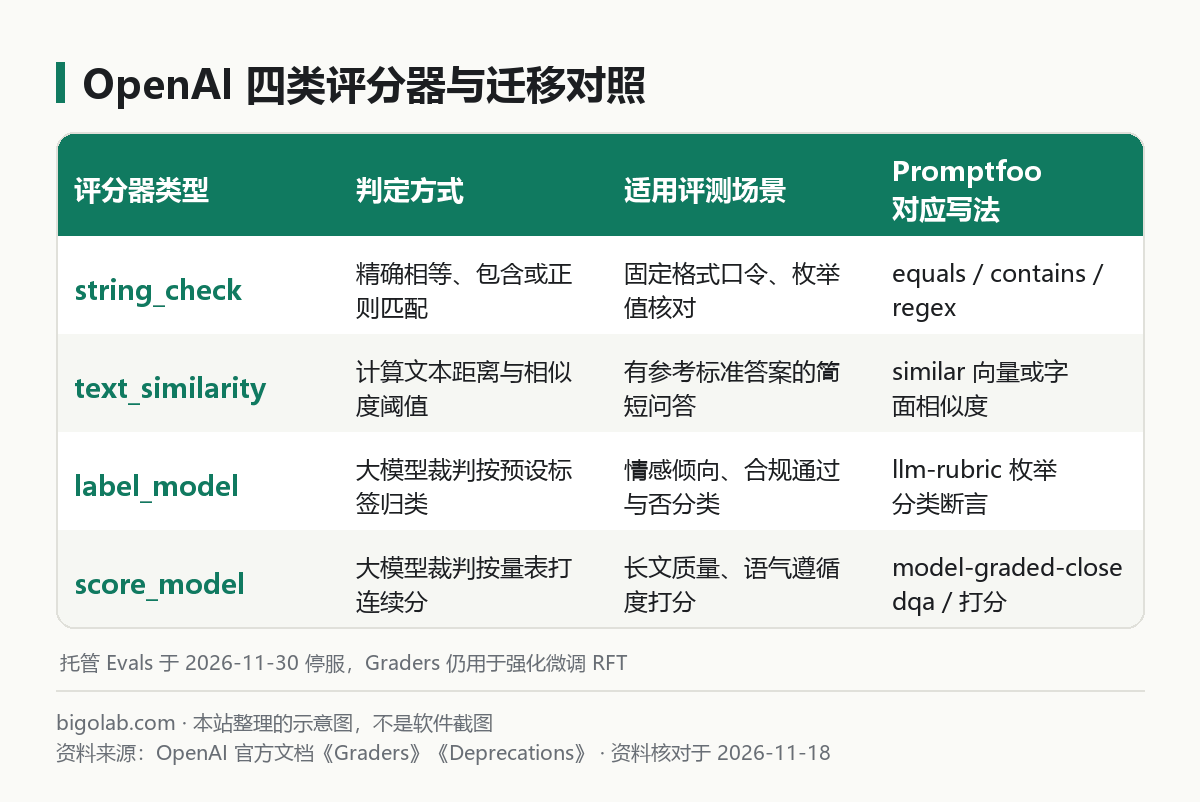
图:本站根据 OpenAI 官方文档:Graders 与弃用迁移说明整理的示意图
选型原则很直接:能用确定性规则(string_check、JSON 校验、正则)判定的,绝不先上大模型当裁判,既省 API 预算又没有随机波动;只有评估语气、摘要完整性这类没有唯一字面答案的题目,才启用 label_model 或 score_model。
如果你们团队是非技术岗居多,平时只是想在共享空间里协作测试几版办公提示词、不需要搭命令行评测流水线,也可以考虑直接用团队工作区手动对比;需要定制企业协作席位时可查看本站 ChatGPT Business 团队版,或了解个人订阅 ChatGPT Plus。
三、实战替代方案:用 Promptfoo 跑 OpenAI 模型与提示词对比
把原本打算在 OpenAI 后台建的评测迁到本地,只需要建一个 promptfooconfig.yaml。先确保本机配好了 OPENAI_API_KEY(获取见 /guides/openai-api-key,接口结构见 /guides/openai-responses-api):
yaml
description: "售后工单分类与回复提示词对比评测"

prompts:
  - "你是客服助手。请判断用户意图(仅输出 退款/换货/咨询)并给出一句回复:{{query}}"
  - "请严格按【分类:xxx】开头回复以下售后问题,分类限 退款、换货、咨询 三选一:{{query}}"

providers:
  - openai:responses:gpt-4o-mini
  - openai:responses:gpt-4o

tests:
  - vars:
      query: "刚收到的键盘空格键卡住了,能给我重新发一把新的吗?"
    assert:
      # 对应原 Evals 的 string_check(确定性包含检查)
      - type: contains
        value: "换货"
      # 对应原 Evals 的 label_model / score_model(模型裁判打分)
      - type: llm-rubric
        value: "回复语气礼貌,明确引导用户提供订单号或故障照片,且未承诺额外赔偿"
在终端运行下面两条命令即可批量执行并在浏览器打开并排对比矩阵:
bash
npx promptfoo@latest eval
npx promptfoo@latest view
如果除了离线跑测试集,你还想在线上运行阶段追踪每次大模型调用的耗时与中间工具链路,可以搭配可观测工具一起看,具体见 /guides/arize-phoenix-llm-tracing-observability。
常见问题
问:后台 Evals 停服后,强化微调(RFT)里的 Grader 还能正常用吗?
能正常使用。停服的是独立托管的 Evals 面板与 /v1/evals 接口;强化微调作业配置里内嵌的 string_check、score_model、Python 代码评分器等属于微调训练管线的一部分,不受这次面板下线影响。
问:做一次评测大概要准备多少条测试样本才够看?
起步不必追求几千条。工程上先从真实线上报错或边界情况里挑出 20 到 50 条高代表性样本建成基准集,每次改完提示词必跑一遍,就已经能拦住大部分“改好A问题却把B问题改坏”的回归退化。
问:用模型给模型打分(score_model)怎么减少打分飘忽不定?
尽量把连续打分拆成边界清晰的二元或三档分类(类似 label_model),在评分指令里写明具体的得分点与扣分项,并把裁判模型的温度固定在低档或默认确定性档位。
问:国内没有境外信用卡,怎么开通或续费 ChatGPT Plus / Pro?
答:可在本站使用支付宝、微信支付或 AlipayHK 下单获取卡密自助兑换(支持 ChatGPT Plus、Pro 5x 可覆盖档 与 Pro 5x 空白号档),实时价格、兑换前提与售后规则(掉订阅按剩余天数折退,封号不在质保范围)以对应页面说明为准。
相关教程
- promptfoo 使用教程:对比提示词和模型、写断言自动评测
- Arize Phoenix 调用链路追踪与评测上手
- OpenAI Responses API 是什么
- OpenAI API Key 怎么获取
参考资料
- OpenAI 官方文档:Deprecations(弃用时间表)— https://developers.openai.com/api/docs/deprecations
- OpenAI 官方文档:Graders(评分器说明)— https://developers.openai.com/api/docs/guides/graders
- OpenAI 官方文档:Working with evals — https://developers.openai.com/api/docs/guides/evals
0 条评论
还没有评论,来抢沙发~