
想在自己的 Python 輿情監控腳本、自動化投研日報或客服機器人裏調用 Grok 獨家的實時網頁與 X(Twitter)檢索能力,第一步是在 console.x.ai 創建好官方密鑰並了解計費檔位(詳見 Grok API 獲取方法與速率規則指南)。
但很多開發者從網上搜來早期示例代碼一跑就會踩坑:以前在請求體頂層傳 search_parameters 的早期 Live Search 寫法,在 docs.x.ai 最新規範中已被正式標記為棄用(Deprecated),全面升級為由模型自主按需觸發的服務端智能體工具(web_search 與 x_search)。下面用最新接口規範帶你一次調通。
SuperGrok 國內免綁卡自助開通入口:想要解鎖充裕的周配額池、DeepSearch 深度溯源與旗艦推理模型,可在本站通過支付寶、微信支付或 AlipayHK 免上號自助兌換 SuperGrok 會員充值(含 月付 iOS 自助檔、三個月省心檔 與頂配 SuperGrok Heavy)。
一、看清接口演進:從 search_parameters 升級到服務端工具
先通過這張對照表理清 xAI 官方接口的新舊更替關係,新開項目一律直接走新版工具數組:
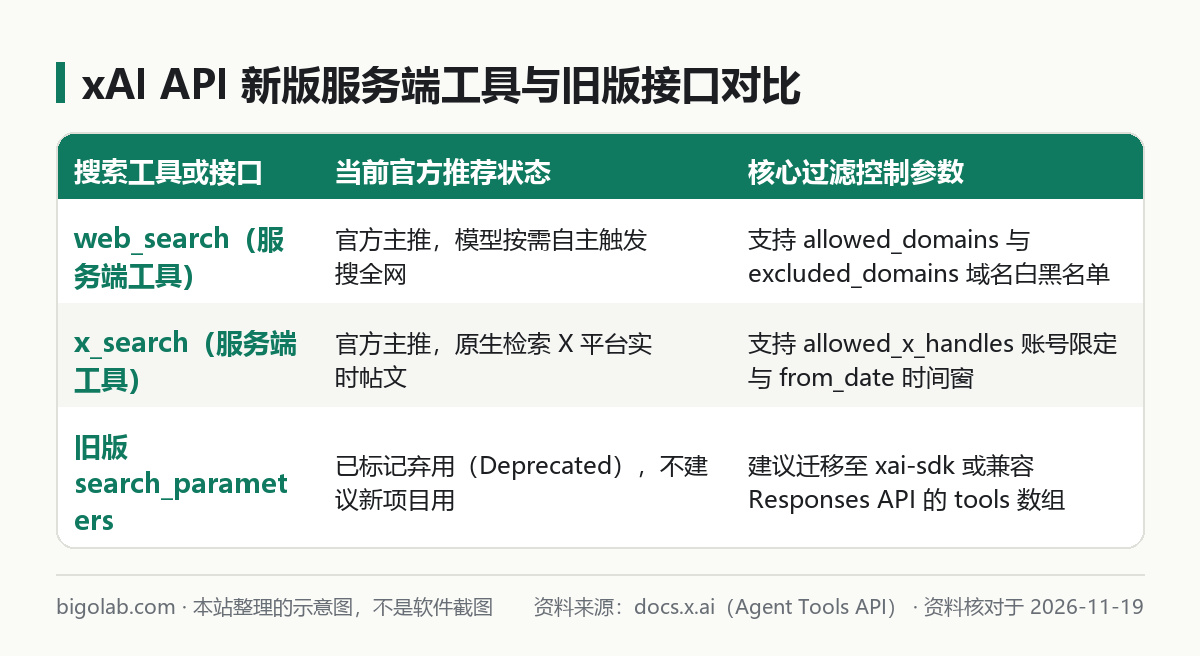
新版架構最大的好處是智能按需計費與混搭靈活:以前開啟強制聯網開關,哪怕用戶只問一句“1+1 等於幾”也會白白觸發一次外部檢索;換成服務端工具後,主力模型(如 Grok 4.7 編碼與知識旗艦模型)會自己判斷當前問題需不需要查實時數據,並且能在同一輪推理裏先搜完 X 實時輿情、緊接着回調你本地的數據庫函數。
二、Python 實戰代碼:兩種主流 SDK 接入寫法
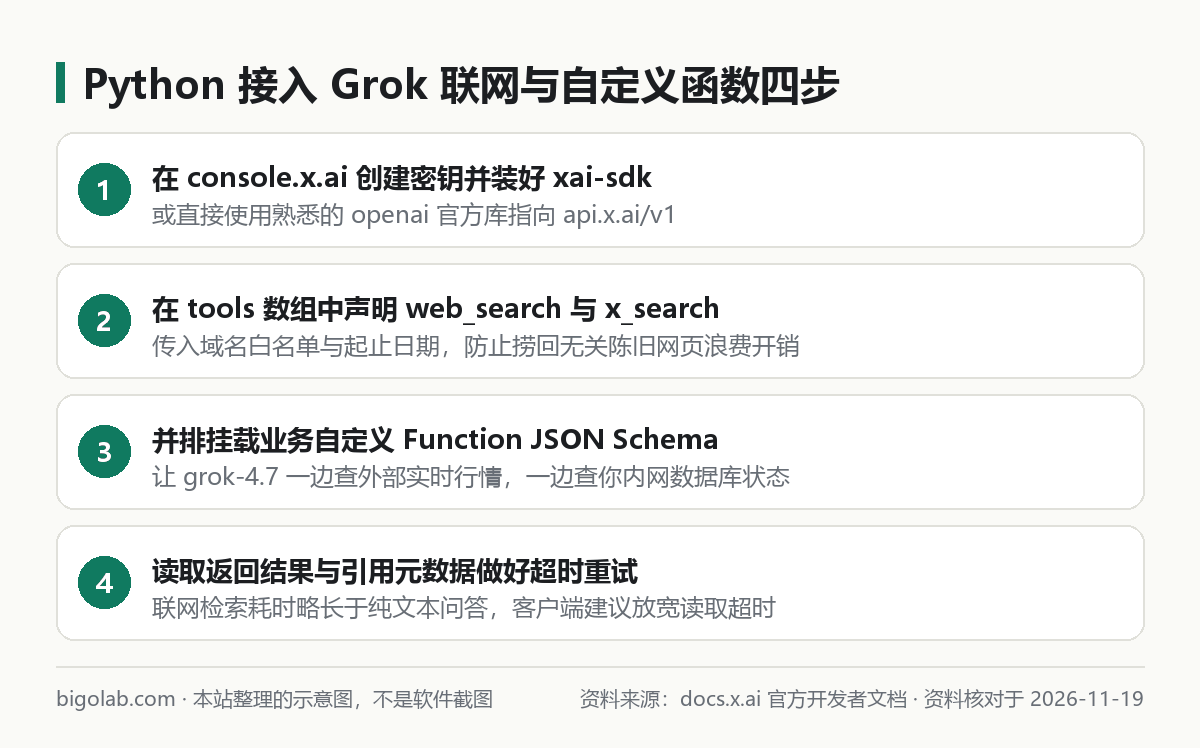
根據你現有工程的依賴習慣,任選官方原生 xai-sdk 或兼容 OpenAI 規範的 openai Responses API 接入即可。
寫法 1:使用官方原生 xai-sdk(支持精細參數過濾)
先在虛擬環境安裝官方包 pip install xai-sdk,通過 web_search 與 x_search 工具對象直接鎖定域名白名單、指定 X 帳號及日期區間,把無關垃圾站點徹底擋在門外:
python
import os
from datetime import datetime
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import web_search, x_search

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(
    model="grok-4.7",
    tools=[
        # 1. 網頁檢索:可按需傳入 allowed_domains 或 excluded_domains
        web_search(excluded_domains=["pinterest.com"]),
        # 2. X 實時帖文檢索:限定高信噪比帳號與起止時間窗
        x_search(
            allowed_x_handles=["xai", "OpenAI", "AnthropicAI"],
            from_date=datetime(2026, 11, 1),
        ),
    ],
)

chat.append(user("請彙總本月這三家官方帳號發佈的最新開發者工具動態,並用中文分點列出。"))
response = chat.sample()
print(response.content)
Grok 周配額不夠用時的升級選型:除了用 API 寫自動化採集腳本,日常高頻在網頁端查 X 實時情報或練語音選 SuperGrok 月付自助檔 即可滿足;長線課題跟進可選 三個月 iOS 充值檔,重度多智能體並行代碼排障可一步到位看 SuperGrok Heavy 詳情頁。
寫法 2:複用 openai 官方庫(Responses API 混搭自定義函數)
如果你團隊的後端代碼底座統一用的都是 openai Python 庫(就像在 Codex 或 Cursor 裏通過兼容協議接入 Grok 一樣),無需額外裝新包,只需把 base_url 指向 https://api.x.ai/v1,就能把服務端檢索工具和你自己的業務 Function 並排塞進 tools 列表:
python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("XAI_API_KEY"),
    base_url="https://api.x.ai/v1",
    timeout=120.0,  # 聯網多步檢索耗時略長,建議將預設讀取超時放寬至 120 秒
)

response = client.responses.create(
    model="grok-4.7",
    input="查一下今天主流開源框架倉庫的熱議動態,如果發現高危安全更新,請調用告警函數生成工單載荷。",
    tools=[
        {"type": "web_search"},
        {"type": "x_search"},
        {
            "type": "function",
            "name": "create_security_ticket",
            "description": "當檢測到高危依賴漏洞公告時生成內部排查工單",
            "parameters": {
                "type": "object",
                "properties": {
                    "package_name": {"type": "string", "description": "受影響組件名稱"},
                    "summary": {"type": "string", "description": "中文漏洞簡述與建議動作"}
                },
                "required": ["package_name", "summary"],
                "additionalProperties": False
            }
        }
    ],
)

for item in response.output:
    if item.type == "function_call":
        print(f"捕獲本地函數調用:{item.name} -> {item.arguments}")
print(response.output_text)
三、生產環境落地的三個成本與穩定性控制細節
把腳本搬上伺服器定時跑之前,務必核對好下面三條工程紅線:
- 看懂工具調用獨立計費規則:在 xAI 開發者控制檯裏,開啟服務端聯網工具除了按輸入輸出消耗模型本身的文本 Token 外,每次實際觸發外部搜尋調用還會按官方工具價目表單獨計量調用次數;並且注意 API 消費額度與你個人的網頁版會員訂閱是兩條完全獨立的帳本,互不抵扣。
- 嚴控
from_date與域名白名單防上下文膨脹:如果不做任何過濾直接搜熱門大詞,搜回來的十幾篇長網頁正文灌進上下文會讓單次輸入 Token 翻好幾倍。限定最近幾天的日期窗或核心技術域名,既準又省錢。 - 調寬 HTTP 客戶端讀取超時(Timeout):一旦模型決定連續發起兩三輪網頁與 X 交叉搜尋並閱讀原文,端到端響應時間很容易達到 20–50 秒。使用預設 10 秒超時的客戶端會頻繁假報錯斷開,生產代碼建議顯式設定
timeout=120.0並做好指數退避重試。
如果你除了寫自動化採集接口,日常自己看情報、寫代碼還想免折騰直接用官方網頁客戶端與終端編程工具,可以前往查看貝果研究社 SuperGrok 會員充值專頁或 Claude Code 開發者訂閱方案。
常見問題
如何拿到模型聯網搜尋參考的具體原帖連結展示在前端?
在 xai-sdk 或兼容 Responses API 返回的響應對象裏,除了生成的正文字符串外,還附帶結構化的引用列表(Citations / Annotations 元數據),裏面完整記錄了本輪檢索命中的網頁 URL 與 X 帖文連結。直接遍歷該字段渲染成前端角標即可,千萬不要只靠正則去正文裏硬摳網址。
為什麼本地 Function 工具偶爾出現參數字段缺失?
請檢查你傳入的 JSON Schema 是否寫清了每個屬性的 description(中文或英文簡述均可)以及完整的 required 必填字段數組。如果參數枚舉值是固定的(比如嚴重等級只允許 "high" 或 "medium"),直接加上 "enum" 約束能徹底消滅大模型自由發揮填錯詞的情況。
國內沒有境外支付方式,怎麼訂閱或續費 SuperGrok 會員?
可前往本站 Grok 會員(SuperGrok)充值專頁,使用支付寶、微信支付或 AlipayHK 下單獲取卡密,走蘋果 iOS 訂閱充值鏈路自助完成兌換,無需交出帳號密碼;若同時需要其他主流模型對比,也可在 AI 會員充值總覽 一站選購,實時價格與退款口徑以頁面說明為準。
小結
- 開發新項目請棄用老舊的
search_parameters,全面改用服務端工具web_search與x_search。 - 善用
allowed_x_handles、excluded_domains與from_date過濾噪音信源,大幅壓低檢索帶入的輸入 Token 帳單。 - 混搭自定義業務 Function 時務必補齊
required約束,並將客戶端網絡超時放寬至 120 秒左右以適應多輪檢索耗時。
0 條評論
還沒有評論,來搶沙發~