
想在自己的 Python 舆情监控脚本、自动化投研日报或客服机器人里调用 Grok 独家的实时网页与 X(Twitter)检索能力,第一步是在 console.x.ai 创建好官方密钥并了解计费档位(详见 Grok API 获取方法与速率规则指南)。
但很多开发者从网上搜来早期示例代码一跑就会踩坑:以前在请求体顶层传 search_parameters 的早期 Live Search 写法,在 docs.x.ai 最新规范中已被正式标记为弃用(Deprecated),全面升级为由模型自主按需触发的服务端智能体工具(web_search 与 x_search)。下面用最新接口规范带你一次调通。
SuperGrok 国内免绑卡自助开通入口:想要解锁充裕的周配额池、DeepSearch 深度溯源与旗舰推理模型,可在本站通过支付宝、微信支付或 AlipayHK 免上号自助兑换 SuperGrok 会员充值(含 月付 iOS 自助档、三个月省心档 与顶配 SuperGrok Heavy)。
一、看清接口演进:从 search_parameters 升级到服务端工具
先通过这张对照表理清 xAI 官方接口的新旧更替关系,新开项目一律直接走新版工具数组:
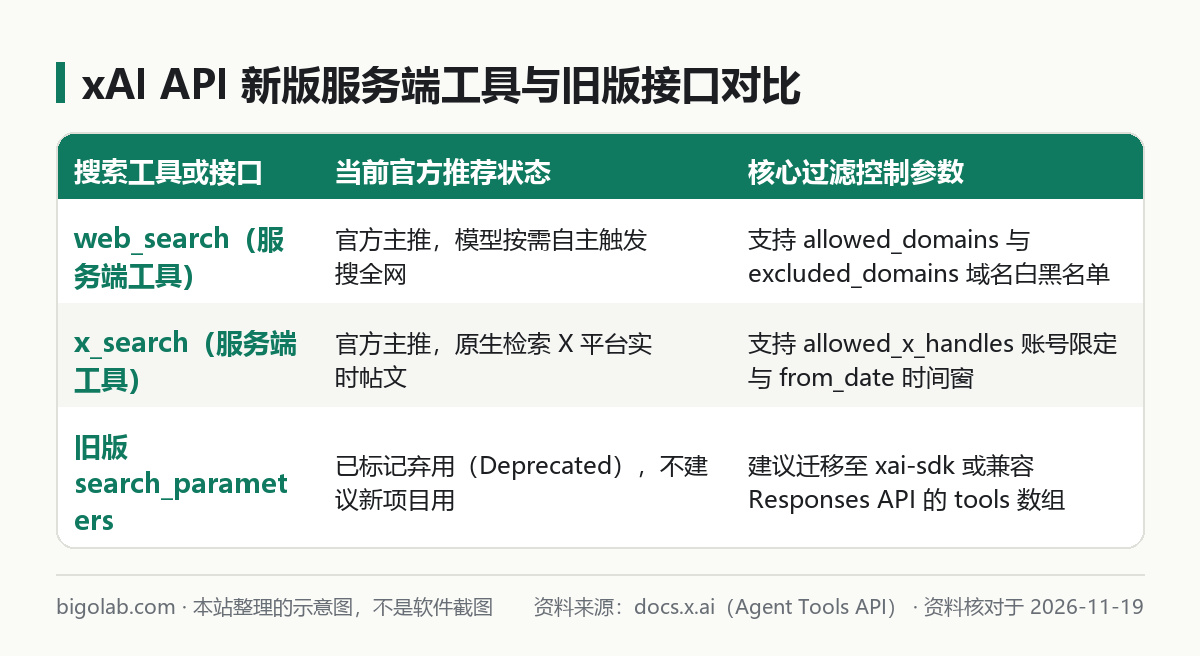
新版架构最大的好处是智能按需计费与混搭灵活:以前开启强制联网开关,哪怕用户只问一句“1+1 等于几”也会白白触发一次外部检索;换成服务端工具后,主力模型(如 Grok 4.7 编码与知识旗舰模型)会自己判断当前问题需不需要查实时数据,并且能在同一轮推理里先搜完 X 实时舆情、紧接着回调你本地的数据库函数。
二、Python 实战代码:两种主流 SDK 接入写法
根据你现有工程的依赖习惯,任选官方原生 xai-sdk 或兼容 OpenAI 规范的 openai Responses API 接入即可。
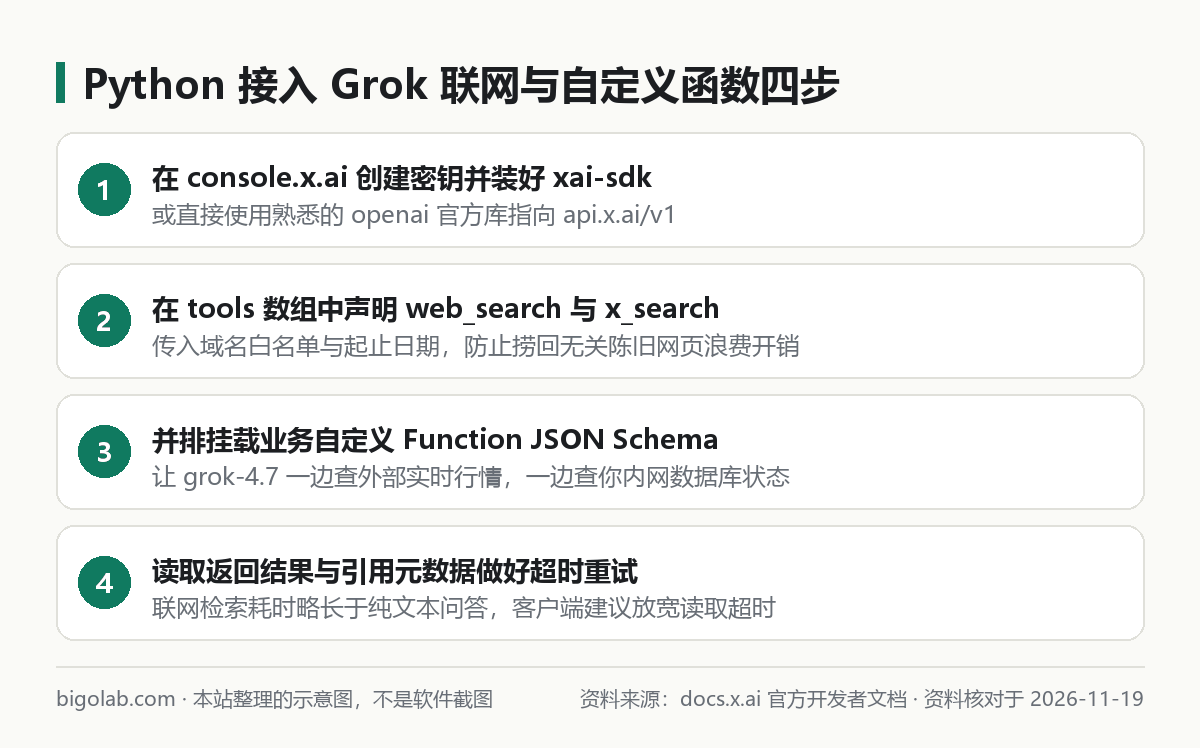
写法 1:使用官方原生 xai-sdk(支持精细参数过滤)
先在虚拟环境安装官方包 pip install xai-sdk,通过 web_search 与 x_search 工具对象直接锁定域名白名单、指定 X 账号及日期区间,把无关垃圾站点彻底挡在门外:
python
import os
from datetime import datetime
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import web_search, x_search

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(
    model="grok-4.7",
    tools=[
        # 1. 网页检索:可按需传入 allowed_domains 或 excluded_domains
        web_search(excluded_domains=["pinterest.com"]),
        # 2. X 实时帖文检索:限定高信噪比账号与起止时间窗
        x_search(
            allowed_x_handles=["xai", "OpenAI", "AnthropicAI"],
            from_date=datetime(2026, 11, 1),
        ),
    ],
)

chat.append(user("请汇总本月这三家官方账号发布的最新开发者工具动态,并用中文分点列出。"))
response = chat.sample()
print(response.content)
Grok 周配额不够用时的升级选型:除了用 API 写自动化采集脚本,日常高频在网页端查 X 实时情报或练语音选 SuperGrok 月付自助档 即可满足;长线课题跟进可选 三个月 iOS 充值档,重度多智能体并行代码排障可一步到位看 SuperGrok Heavy 详情页。
写法 2:复用 openai 官方库(Responses API 混搭自定义函数)
如果你团队的后端代码底座统一用的都是 openai Python 库(就像在 Codex 或 Cursor 里通过兼容协议接入 Grok 一样),无需额外装新包,只需把 base_url 指向 https://api.x.ai/v1,就能把服务端检索工具和你自己的业务 Function 并排塞进 tools 列表:
python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("XAI_API_KEY"),
    base_url="https://api.x.ai/v1",
    timeout=120.0,  # 联网多步检索耗时略长,建议将默认读取超时放宽至 120 秒
)

response = client.responses.create(
    model="grok-4.7",
    input="查一下今天主流开源框架仓库的热议动态,如果发现高危安全更新,请调用告警函数生成工单载荷。",
    tools=[
        {"type": "web_search"},
        {"type": "x_search"},
        {
            "type": "function",
            "name": "create_security_ticket",
            "description": "当检测到高危依赖漏洞公告时生成内部排查工单",
            "parameters": {
                "type": "object",
                "properties": {
                    "package_name": {"type": "string", "description": "受影响组件名称"},
                    "summary": {"type": "string", "description": "中文漏洞简述与建议动作"}
                },
                "required": ["package_name", "summary"],
                "additionalProperties": False
            }
        }
    ],
)

for item in response.output:
    if item.type == "function_call":
        print(f"捕获本地函数调用:{item.name} -> {item.arguments}")
print(response.output_text)
三、生产环境落地的三个成本与稳定性控制细节
把脚本搬上服务器定时跑之前,务必核对好下面三条工程红线:
- 看懂工具调用独立计费规则:在 xAI 开发者控制台里,开启服务端联网工具除了按输入输出消耗模型本身的文本 Token 外,每次实际触发外部搜索调用还会按官方工具价目表单独计量调用次数;并且注意 API 消费额度与你个人的网页版会员订阅是两条完全独立的账本,互不抵扣。
- 严控
from_date与域名白名单防上下文膨胀:如果不做任何过滤直接搜热门大词,搜回来的十几篇长网页正文灌进上下文会让单次输入 Token 翻好几倍。限定最近几天的日期窗或核心技术域名,既准又省钱。 - 调宽 HTTP 客户端读取超时(Timeout):一旦模型决定连续发起两三轮网页与 X 交叉搜索并阅读原文,端到端响应时间很容易达到 20–50 秒。使用默认 10 秒超时的客户端会频繁假报错断开,生产代码建议显式设置
timeout=120.0并做好指数退避重试。
如果你除了写自动化采集接口,日常自己看情报、写代码还想免折腾直接用官方网页客户端与终端编程工具,可以前往查看贝果研究社 SuperGrok 会员充值专页或 Claude Code 开发者订阅方案。
常见问题
如何拿到模型联网搜索参考的具体原帖链接展示在前端?
在 xai-sdk 或兼容 Responses API 返回的响应对象里,除了生成的正文字符串外,还附带结构化的引用列表(Citations / Annotations 元数据),里面完整记录了本轮检索命中的网页 URL 与 X 帖文链接。直接遍历该字段渲染成前端角标即可,千万不要只靠正则去正文里硬抠网址。
为什么本地 Function 工具偶尔出现参数字段缺失?
请检查你传入的 JSON Schema 是否写清了每个属性的 description(中文或英文简述均可)以及完整的 required 必填字段数组。如果参数枚举值是固定的(比如严重等级只允许 "high" 或 "medium"),直接加上 "enum" 约束能彻底消灭大模型自由发挥填错词的情况。
国内没有境外支付方式,怎么订阅或续费 SuperGrok 会员?
可前往本站 Grok 会员(SuperGrok)充值专页,使用支付宝、微信支付或 AlipayHK 下单获取卡密,走苹果 iOS 订阅充值链路自助完成兑换,无需交出账号密码;若同时需要其他主流模型对比,也可在 AI 会员充值总览 一站选购,实时价格与退款口径以页面说明为准。
小结
- 开发新项目请弃用老旧的
search_parameters,全面改用服务端工具web_search与x_search。 - 善用
allowed_x_handles、excluded_domains与from_date过滤噪音信源,大幅压低检索带入的输入 Token 账单。 - 混搭自定义业务 Function 时务必补齐
required约束,并将客户端网络超时放宽至 120 秒左右以适应多轮检索耗时。
0 条评论
还没有评论,来抢沙发~